前期准备
- 阅读本教程前,请确保您了解 Kubernetes 的一些基础概念
- 了解 YAML 语法
如您在配置时有疑惑,可以参考 example 目录下的 values.yaml。
Prometheus 和 Grafana 的介绍
Prometheus
什么是 Prometheus?
Prometheus 是一个开源系统监控和警报工具包,最初由 SoundCloud 构建。自 2012 年启动以来,许多公司和组织都采用了 Prometheus,该项目拥有非常活跃的开发者和用户社区。它现在是一个独立的开源项目,独立于任何公司进行维护。为了强调这一点,并明确项目的治理结构,Prometheus 于 2016 年作为继 Kubernetes 之后的第二个托管项目加入了云原生计算基金会。
Prometheus 将其指标收集并存储为时间序列数据,即指标信息(metrics)与记录时的时间戳以及称为标签的可选键值对一起存储。
什么是 Metrics?
用外行的话来说,指标是数字化的测量。时间序列意味着随着时间的推移记录变化。用户想要测量的内容因应用程序而异。对于 Web 服务器,它可能是请求时间,对于数据库,它可能是活动连接数或活动查询数等。
指标在理解您的应用程序为何以某种方式工作方面起着重要作用。假设您正在运行一个 Web 应用程序并发现该应用程序运行缓慢。您将需要一些信息来了解您的应用程序发生了什么。例如,当请求数量很高时,应用程序可能会变慢。如果您有请求计数指标,您可以找出原因并增加服务器数量来处理负载。
Prometheus 的组件
Prometheus 生态系统由多个组件组成,其中许多组件是可选的:
- 抓取和存储时间序列数据的主要 Prometheus 服务器
- 用于检测应用程序代码的客户端库
- 支持短期工作的推送网关
- 用于 HAProxy、StatsD、Graphite 等服务的特殊用途的 Exporter
- 用于处理警报的 Alertmanager
- 各种支持工具
大多数 Prometheus 组件都是用 Go 编写的,这使得它们易于构建和部署为静态二进制文件。
架构
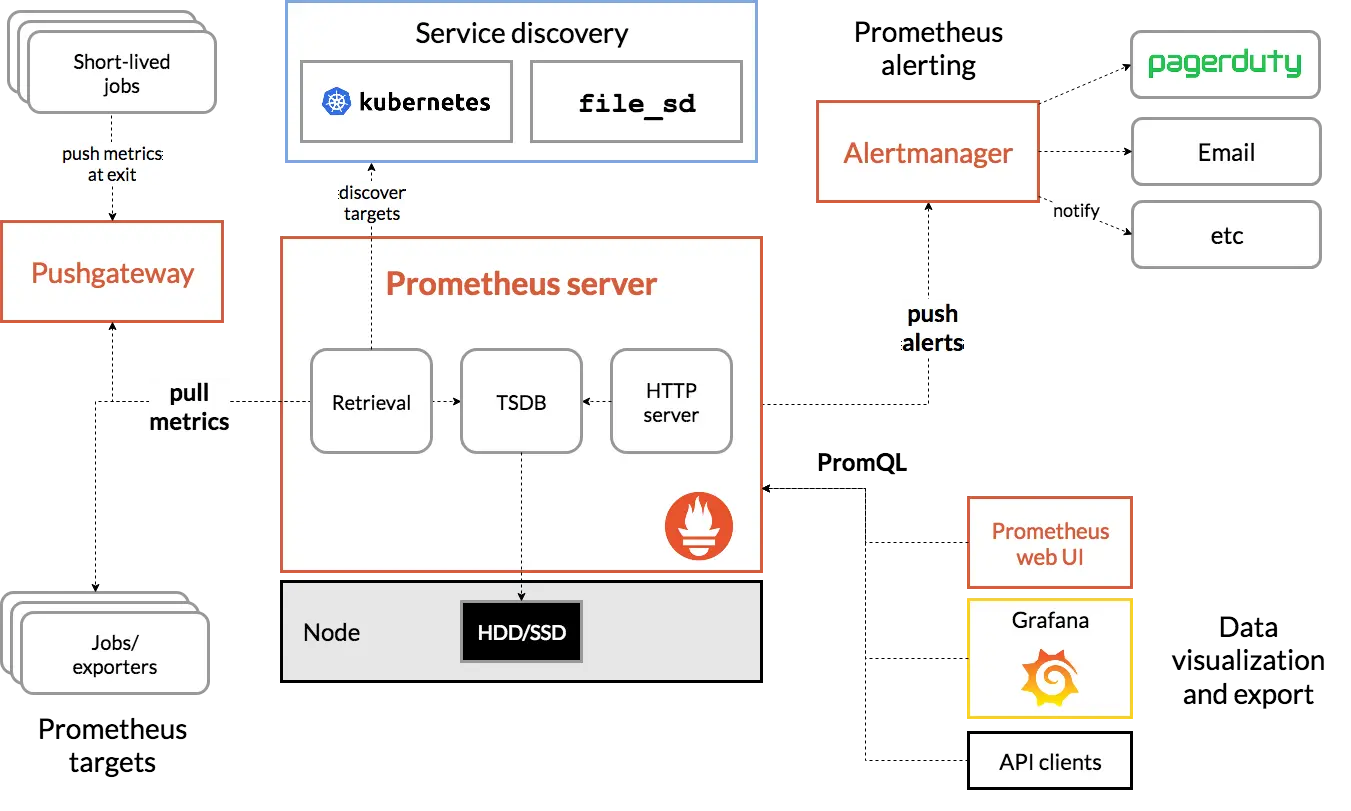
Prometheus 直接或通过一个用于短期作业的中间推送网关从检测作业中抓取指标。它在本地存储所有抓取的样本,并对这些数据运行规则,以聚合和记录现有数据的新时间序列或生成警报。Grafana 或其他 API consumer 可将收集的数据用于可视化。
Grafana
Grafana 允许您查询、可视化、告警和理解您的指标,无论它们存储在何处。与您的团队一起创建、探索和共享仪表板,培养数据驱动的文化:
- 可视化:具有多种选项的快速灵活的客户端图形。面板插件提供了许多不同的方式来可视化指标和日志。
- 动态仪表板:使用在仪表板顶部显示为下拉列表的模板变量创建动态和可重复使用的仪表板。
- 探索指标:通过临时查询和动态向下钻取探索您的数据。拆分视图并并排比较不同的时间范围、查询和数据源。
- 探索日志:体验使用保留的标签过滤器从指标切换到日志的魔力。快速搜索所有日志或实时流式传输。
- 告警:直观地为您最重要的指标定义警报规则。Grafana 将持续评估并向 Slack、PagerDuty、VictorOps、OpsGenie 等系统发送通知。
- 混合数据源:在同一张图中混合不同的数据源!您可以在每个查询的基础上指定数据源。这甚至适用于自定义数据源。
目标
- 使用 Prometheus 的 Blackbox Exporter,通过 POST 方法监控外部服务接口是否返回
200状态码;如未返回,则进行告警。 - 使用 Grafana 对 Prometheus 的部分 Metrics 进行可视化监控。
- 与钉钉机器人对接,实现告警。
环境准备
环境版本
- Kubernetes Client Version:v1.25.2
- Kubernetes Server Version:v1.19.0
- Helm Version:v3.10.3
- Clone 仓库
git clone https://github.com/Sunhill666/DeployPrometheusInKubernetesWithGrafana.git- 更新 Charts 依赖
cd dingtalk-prometheus
helm dependency update- 在 Kubernetes 创建新的命名空间
kubectl create namespace <your-namespace>告警信息的“翻译”
以下是对
translator目录的解释,只对 Model 进行说明,具体业务逻辑请自行查看。
因为 Prometheus 的 Alertmanager 告警信息格式与钉钉所能接受的信息格式不匹配,所以需要对二者进行“翻译”,在 models.py 中使用 Pydantic 创建相关模型:
{
  "version": "4",
  "receiver": "null",
  "status": "firing",
  "truncatedAlerts": 0,
  "groupKey": "{}:{alertname:\"API Error\", instance:\"prometheus-kube-prometheus-blackbox-exporter:19115\"}",
  "alerts": [
    {
      "status": "firing",
      "labels": {
        "alertname": "API Error",
        "instance": "prometheus-kube-prometheus-blackbox-exporter:19115",
        "job": "aiproxy",
        "prometheus": "monitoring/prometheus-kube-prometheus-prometheus",
        "severity": "critical"
      },
      "annotations": {
        "description": "The request API gets a non 200 status code!",
        "summary": "API Error!"
      },
      "startsAt": "2023-01-17T09:43:35.891246",
      "endsAt": "2023-01-17T10:43:35.891246",
      "generatorURL": "http://prometheus.hostname.com/graph?g0.expr=probe_http_status_code+%21%3D+200&g0.tab=1",
      "fingerprint": "213e839c0bf29378"
    }
  ],
  "groupLabels": {
    "alertname": "API Error",
    "instance": "prometheus-kube-prometheus-blackbox-exporter:19115"
  },
  "commonLabels": {
    "alertname": "API Error",
    "instance": "prometheus-kube-prometheus-blackbox-exporter:19115",
    "job": "aiproxy",
    "prometheus": "monitoring/prometheus-kube-prometheus-prometheus",
    "severity": "critical"
  },
  "commonAnnotations": {
    "description": "The request API gets a non 200 status code!",
    "summary": "API Error!"
  },
  "externalURL": "http://alertmanager.hostname.com"
}
from datetime import datetime
from typing import List, Dict
from pydantic import BaseModel, Field
class Alert(BaseModel):
status: str
labels: Dict[str, str] = dict()
annotations: Dict[str, str] = dict()
start_at: datetime = Field(alias="startsAt")
end_at: datetime = Field(alias="endsAt")
generator_url: str = Field(alias="generatorURL")
fingerprint: str
class Notification(BaseModel):
version: str
receiver: str
status: str
truncated_alerts: int = Field(alias="truncatedAlerts", default=0)
group_key: str = Field(alias="groupKey")
alerts: List[Alert] = list()
group_labels: Dict[str, str] = Field(alias="groupLabels")
common_labels: Dict[str, str] = Field(alias="commonLabels")
common_annotations: Dict[str, str] = Field(alias="commonAnnotations")
external_url: str = Field(alias="externalURL")
class DingTalkMessage(BaseModel):
msgtype: str = "markdown"
markdown: Dict[str, str]
然后在业务中监听 Alertmanager 发出的告警信息,并进行“翻译”后发送至机器人的 Webhook 地址:
# 监听 AlertManager 发出的告警信息并“翻译”,然后发出
@app.post("/webhook")
async def webhook(notification: Notification):
    ...
配置 dingtalk-prometheus 部署参数
使用合适的编辑器打开 dingtalk-prometheus 目录下的 values.yaml 文件。
本章节如未特别说明,修改 prometheus.serviceAccount.create=true 则代表:
prometheus:
  serviceAccount:
    create: true
配置 Blackbox Exporter
Blackbox Exporter 是 Prometheus 社区提供的官方黑盒监控解决方案,允许用户通过 HTTP、HTTPS、DNS、TCP 以及 ICMP 对网络进行探测。
- 修改
prometheus-blackbox-exporter.config.modules
prometheus-blackbox-exporter:
  config:
    modules:
      "<model-name>": # module 名称
        "prober": "http" # 使用 HTTP 协议
        "timeout": "15s"
        "http":
          "method": "POST" # 使用 POST 方法
          "preferred_ip_protocol": "ip4" # 使用 IPv4 协议
          "headers":
            "Content-Type": "application/json"
          "body": '{"key": "value"}' # 请求参数
配置 Prometheus
- 配置采集任务
prometheus:
  prometheusSpec:
    additionalScrapeConfigs:
      - job_name: <job-name>
        metrics_path: <metrics-path> # eg: /probe
        params:
          module: [<model-name>] # blackbox exporter 模块名称
        static_configs:
          - targets: [<API_url>] # 需要监测的接口地址
        relabel_configs:
          - source_labels: [__address__]
            target_label: __param_target
          - source_labels: [__param_target]
            target_label: instance
          - target_label: __address__
replacement: <blackbox-exporter-service-name>:<blackbox-exporter-service-port> # blackbox exporter 的 Service 名称 + 端口号- 配置 Alerting Rules(告警规则)
additionalPrometheusRulesMap:
  <rules-name>:
    groups:
      - name: <rule-group-name> # 规则组名称
        rules:
          - alert: <alert-content> # 警告内容
            expr: <PromQL-expr> # PromQL 表达式
            for: <for-time> # 等待时间
            labels: # 自定义标签,允许用户指定要附加到告警上的一组附加标签
              severity: critical
            annotations:
              summary: <alert-summary>
description: <alert-desc>-
配置 Webhook
alertmanager.config.receivers中webhook_configs的url要与上面的“翻译”所监听的url一致。
alertmanager:
  config:
    route:
      group_by: ["<labelname>"] # 依据标签名将告警进行分组
      group_wait: 30s # 同一组告警等待时间
      group_interval: 5m # 同一组告警周期时间
      repeat_interval: 4h # 重复告警周期时间
      receiver: "<receiver-name>"
      routes:
        - receiver: "<receiver-name>"
          matchers:
            - severity =~ "warning|critical" # 匹配标签发送告警
    receivers:
      - name: "<receiver-name>"
        webhook_configs:
- url: "<dingtalk-translator-service>"- 配置 Prometheus 和 Alertmanager 的 Ingress(可选)
prometheus:
  ingress:
    enabled: true
    hosts:
      - <prometheus-hostname> # prometheus 访问域名
    ingressClassName: <ingress-controller-name> # ingress Controller

alertmanager:
  ingress:
    enabled: true
    hosts:
      - <alertmanager-hostname> # alertmanager 访问域名
    ingressClassName: <ingress-controller-name> # ingress Controller
配置 Grafana
- 修改 Dashboard 登陆密码
grafana:
adminPassword: <password>- 配置 Grafana 的 Ingress(可选)
grafana:
  ingress:
    enabled: true
    hosts:
      - <grafana-hostname> # grafana 访问域名
    ingressClassName: <ingress-controller-name> # ingress Controller
关闭无用的告警规则和 Exporter(可选)
defaultRules:
  create: false

kubeApiServer:
  enabled: false

kubelet:
  enabled: false

kubeControllerManager:
  enabled: false

coreDns:
  enabled: false

kubeEtcd:
  enabled: false

kubeScheduler:
  enabled: false

kubeProxy:
  enabled: false

kubeStateMetrics:
  enabled: false
部署 dingtalk-prometheus
注意事项
- 一个集群中只能有一个 Prometheus Operator。
Only one instance of the Prometheus Operator component should be running in a cluster.
- 注意 Blackbox Exporter 中 POST 的请求参数不要过长,且
dingtalk-prometheus目录下不要有其他无关文件,否则会出现以下错误:
failed to create: Secret “sh.helm.release.v1.****.v1” is invalid: data: Too long: must have at most 1048576 bytes
部署
- 部署
dingtalk-prometheus
cd dingtalk-prometheus
helm install -n <your-namespace> <prometheus-release-name> . -f values.yaml- 查看状态
helm status <prometheus-release-name> -n <your-namespace>
kubectl get pods -n <your-namespace>
kubectl get service -n <your-namespace>-
通过 Ingress 配置的 Hostname 访问 Prometheus,可以看到上面配置的采集任务和告警规则都存在。
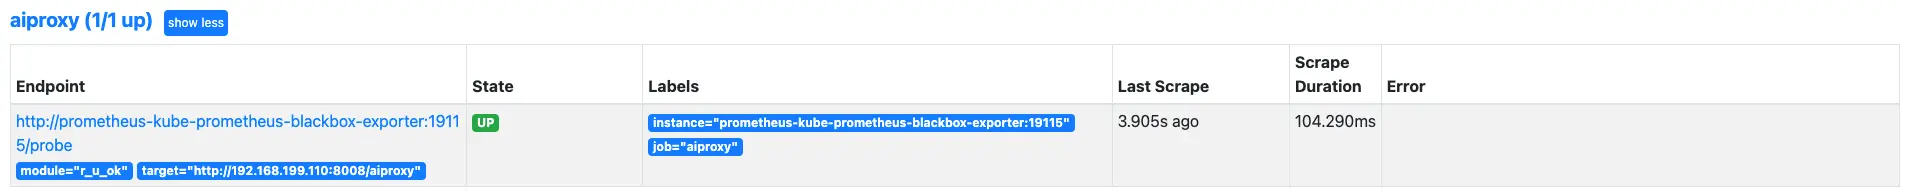
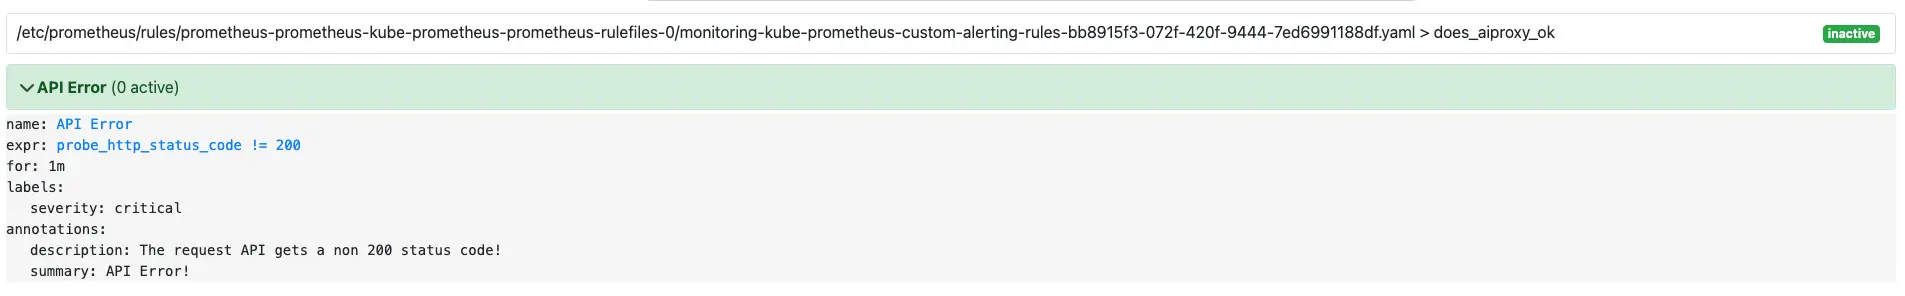
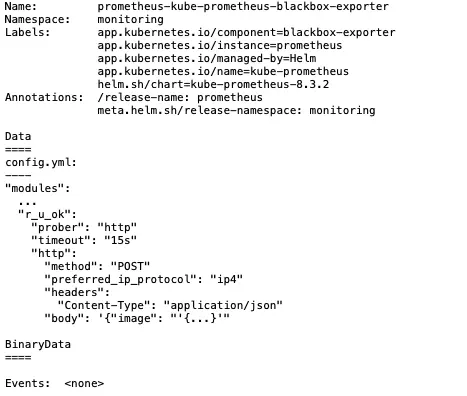
使用命令查看 Blackbox Exporter 的配置:
kubectl describe configmaps <configmap-name> -n <your-namespace>可以看到所添加的模块。
Grafana Dashboard 配置
-
访问 Ingress 配置的 Hostname,使用配置的密码登录。
-
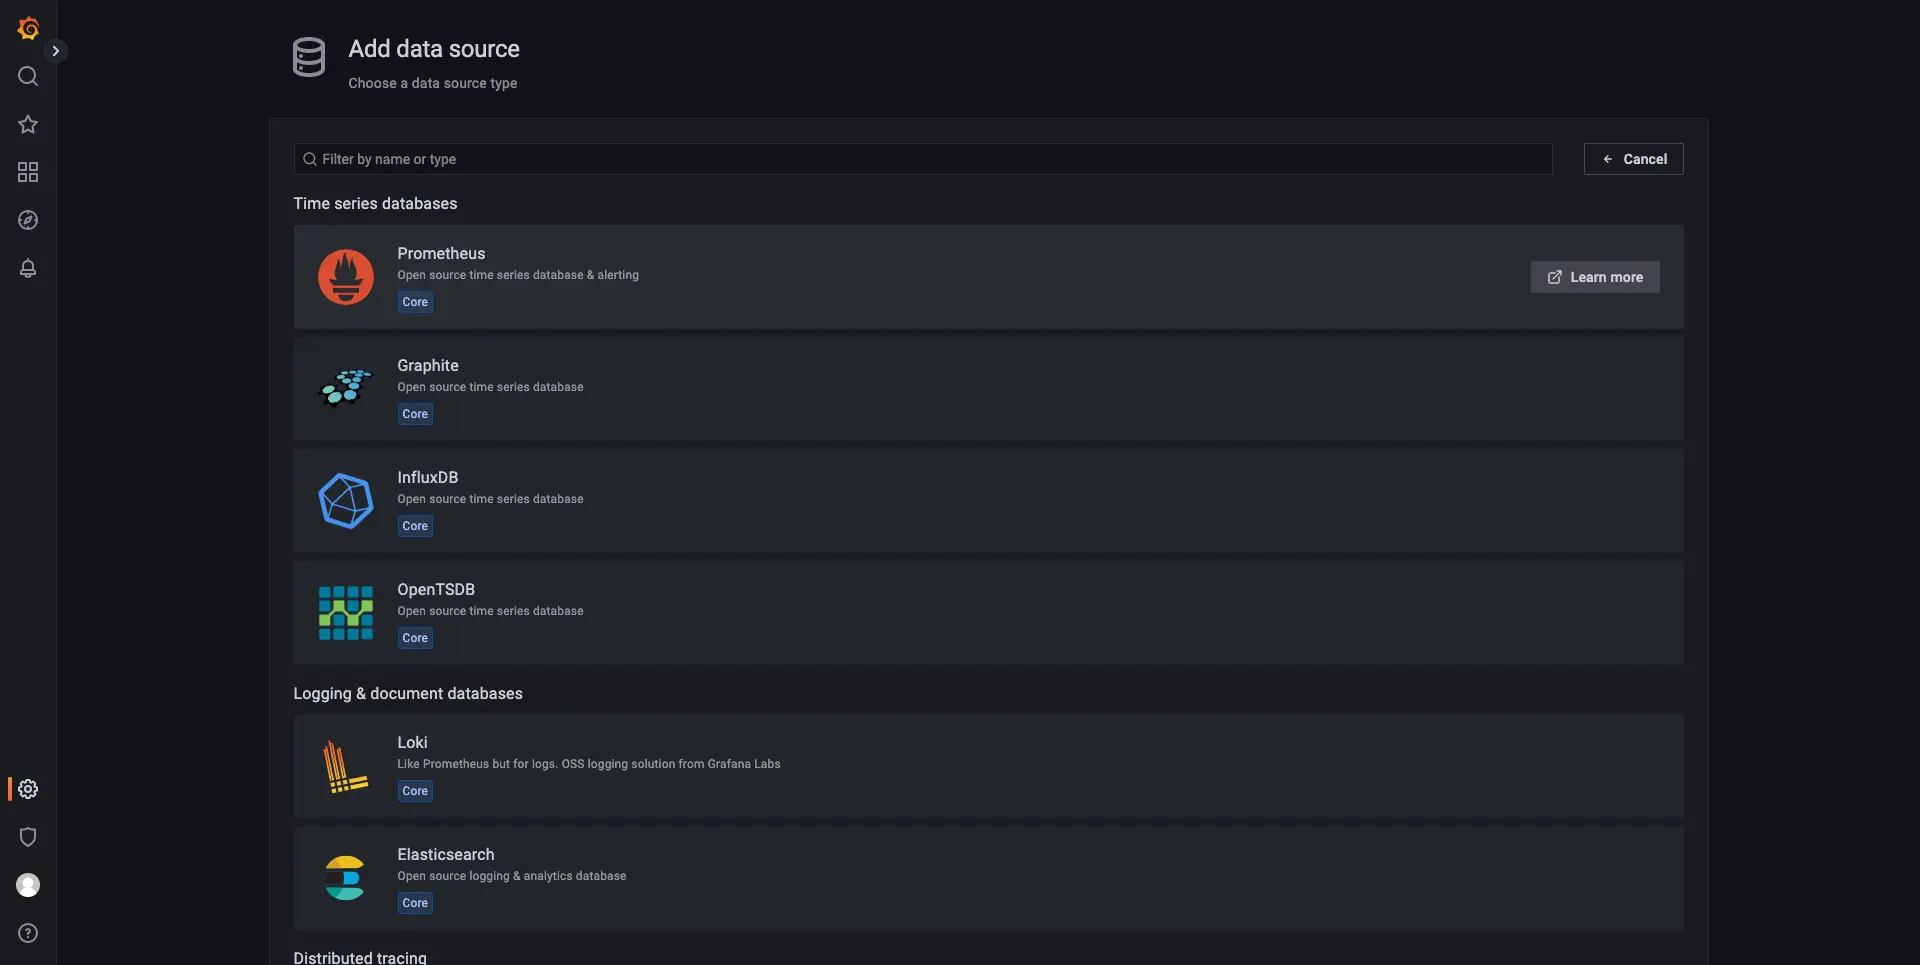
配置数据源,选择添加 Prometheus 数据源。
配置 URL:
http://<prometheus-service-name>:<prometheus-service-port> # Prometheus 的 Service 名称 + 端口号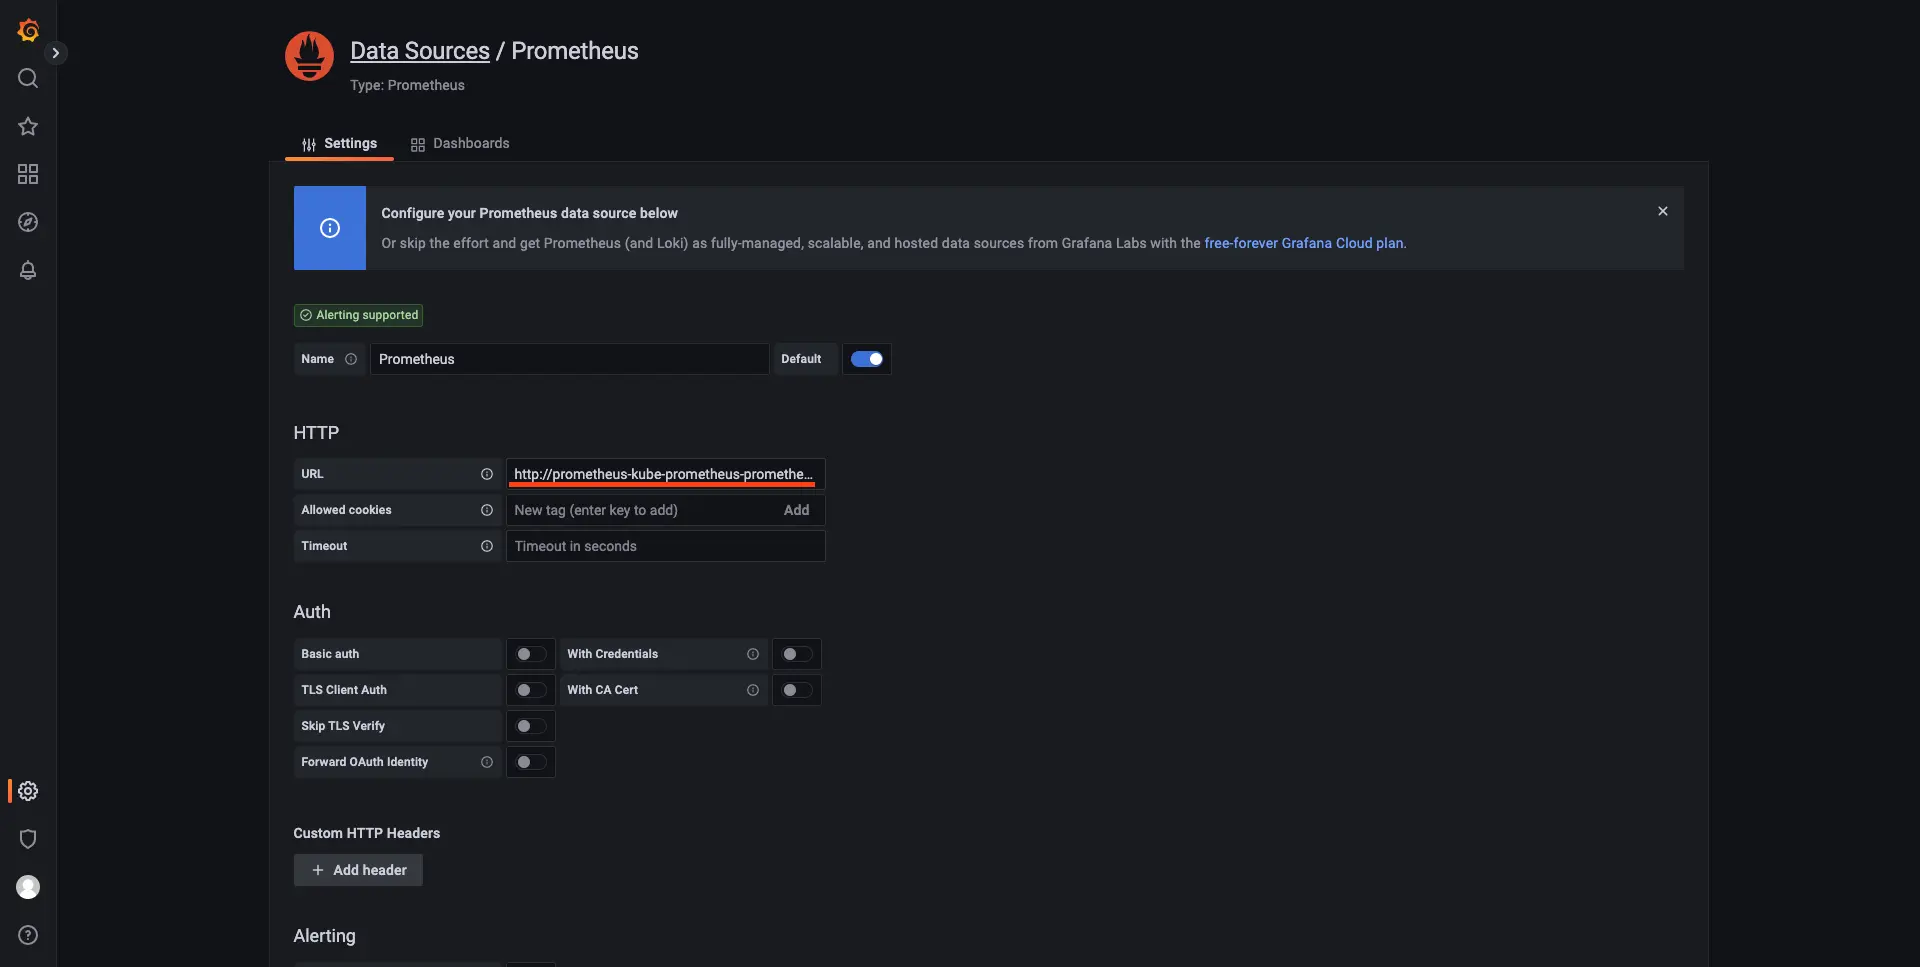
滑到最下方,点击 Save & test。
-
配置 Dashboard,添加新的 Dashboard 和 Panel。
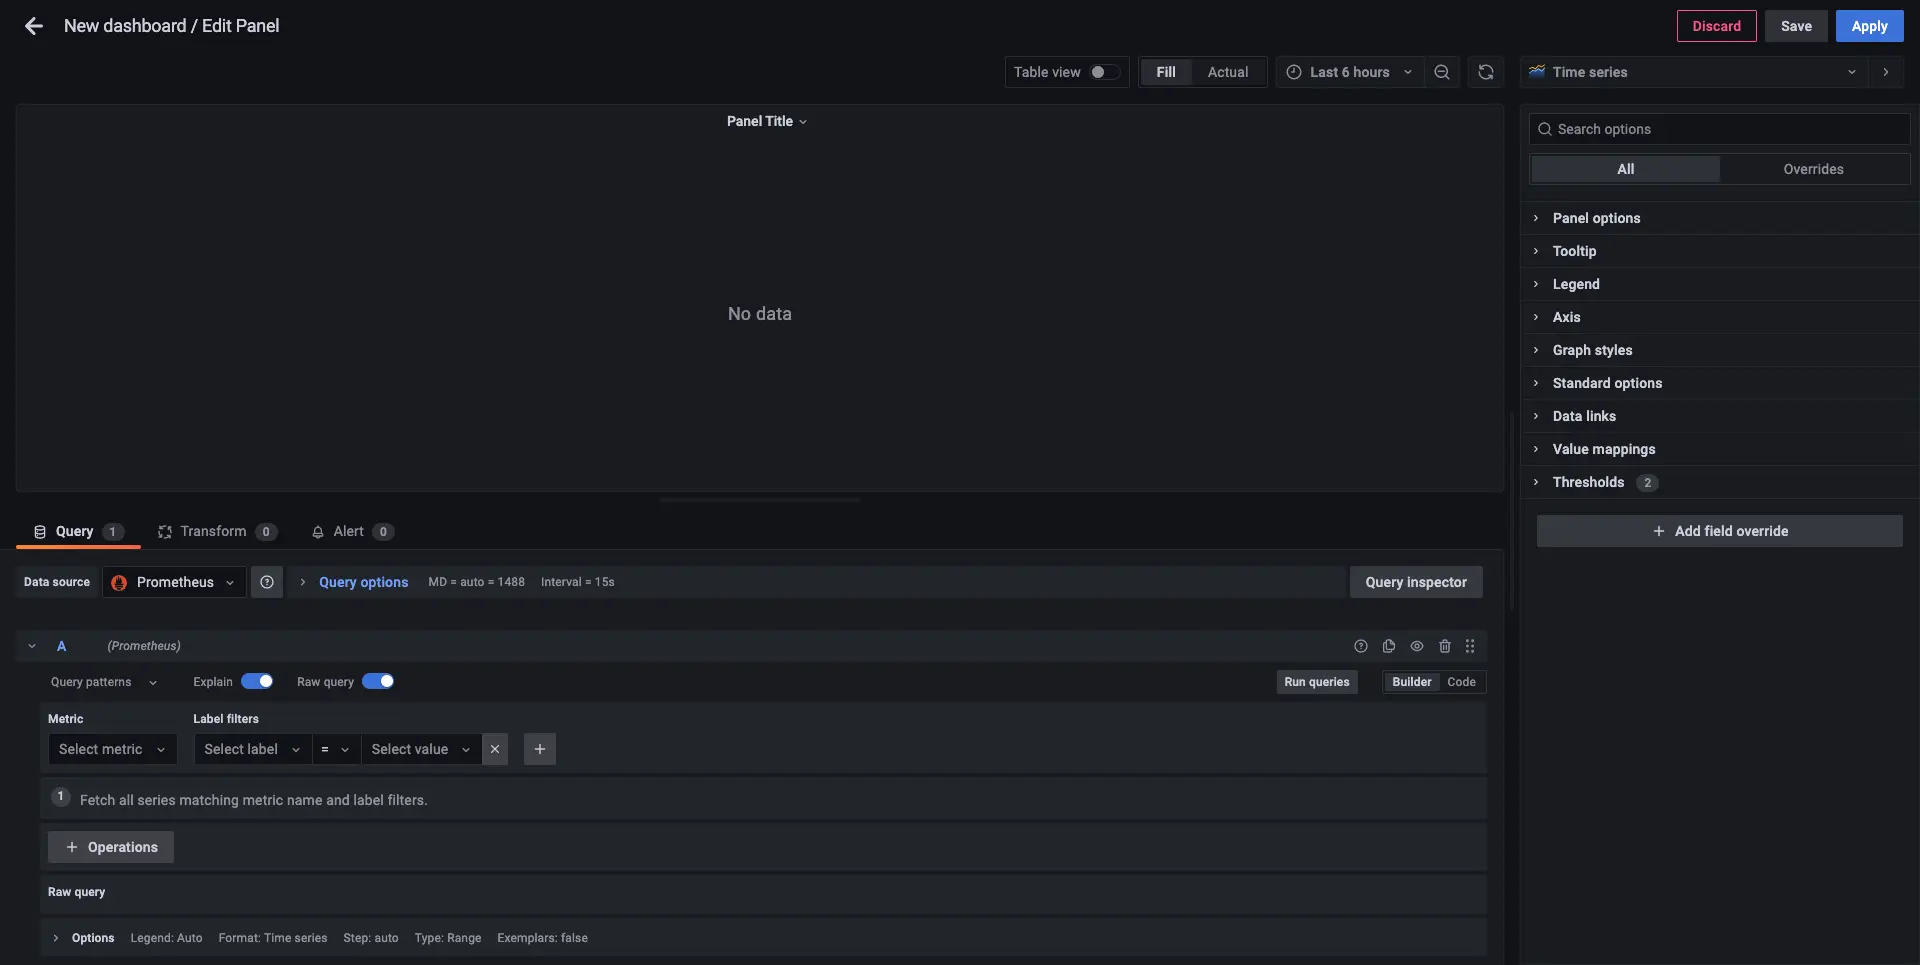
- 在 Data source 中选择 Prometheus
- Metrics 选择
<metrics-path>_http_status_code - Label filters 选择
instance = <blackbox-exporter-service-name>:<blackbox-exporter-service-port>(Blackbox Exporter 的 Service 名称和端口号)
再点击 Run queries 和 Apply,保存 Dashboard,即可看到监控数据。
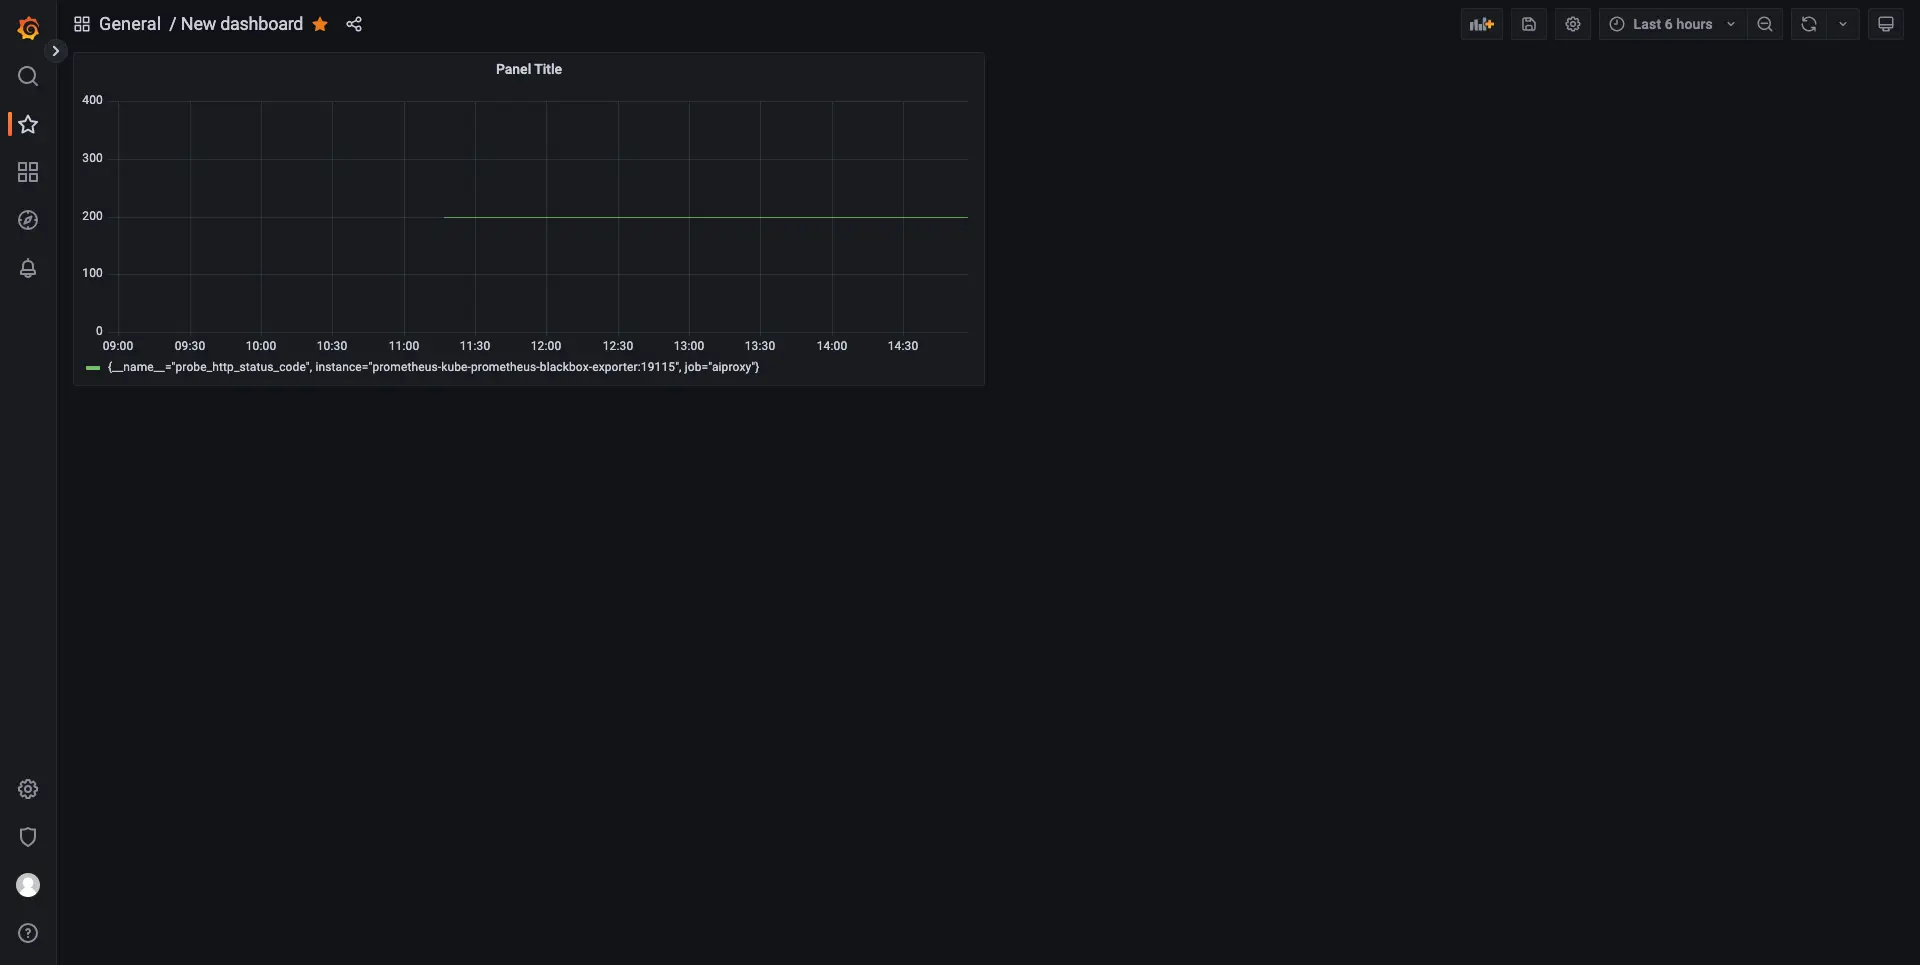
至此结束!
关于自动生成告警
关于 target 值与 params 中的 module 参数如何对接
additionalScrapeConfigs:
  - job_name: "http_sd"
    metrics_path: /probe
    http_sd_config:
      url: "" # 此处为获取 target 和 module 值的地址
    relabel_configs:
      - source_labels: [__address__]
        target_label: __param_target
      - source_labels: [__param_target]
        target_label: instance
      - source_labels: [module] # 此处起关键作用,使用 Prometheus Relabel 为其重新绑定参数
        target_label: __param_module
      - target_label: __address__
        replacement: ""
Translator 服务
translator 服务 API 文档在根目录的 API-DOC-Postman-v2.1.json 文件中。
translator 中的服务会根据用户使用 POST 请求的数据,在项目目录中生成 Exporter Module、告警规则文件,以及 Prometheus 所需的 http_sd_configs。
现需解决如何让 Prometheus 和 Blackbox Exporter 读取生成的配置文件。方案如下:将 translator 服务生成的配置文件挂载出去,供 Prometheus 和 Blackbox Exporter 读取。
# values.yaml
promethues:
  prometheusSpec:
    volumes:
      - name: serve-prometheus-rules
        persistentVolumeClaim:
          claimName: prometheus-storage
    volumeMounts:
      - name: serve-prometheus-rules
        mountPath: /etc/custom

prometheus-blackbox-exporter:
  extraVolumes:
    - name: serve-prometheus-modules
      persistentVolumeClaim:
        claimName: prometheus-storage
  extraVolumeMounts:
    - name: serve-prometheus-modules
      mountPath: /etc/custom
translator 的 Chart 在 templates/dingtalk 目录下。
Q&A
部署时出现 ImagePullBackOff,如何解决?
原因:Kubernetes 默认的 image-pull-progress-deadline 是 1 分钟。如果 1 分钟内镜像下载没有任何进度更新,下载动作就会取消。在节点性能较差或镜像较大时,可能出现镜像无法成功下载、负载启动失败的现象。
解决方法:
- 登录节点,手动拉取该镜像。
- 重新打 Tag,然后推送到私有仓库。
- 修改 Kubelet 配置参数,在
DAEMON_ARGS参数末尾追加--image-pull-progress-deadline=30m(30m表示 30 分钟)。
修改 values.yaml 后,如何更新部署?
使用以下命令更新:
helm upgrade -n <your-namespace> <prometheus-release-name> . -f values.yaml出现以下报错,如何解决?
error validating "": error validating data: [ValidationError(Prometheus.spec): unknown field "probeNamespaceSelector" in com.coreos.monitoring.v1.Prometheus.spec, ValidationError(Prometheus.spec): unknown field "probeSelector" in com.coreos.monitoring.v1.Prometheus.spec]
helm.go:84: [debug] error validating "": error validating data: [ValidationError(Prometheus.spec): unknown field "probeNamespaceSelector" in com.coreos.monitoring.v1.Prometheus.spec, ValidationError(Prometheus.spec): unknown field "probeSelector" in com.coreos.monitoring.v1.Prometheus.spec]
遇到类似报错时,可删除以下 CRD 解决:
kubectl delete crd alertmanagerconfigs.monitoring.coreos.com
kubectl delete crd alertmanagers.monitoring.coreos.com
kubectl delete crd podmonitors.monitoring.coreos.com
kubectl delete crd probes.monitoring.coreos.com
kubectl delete crd prometheuses.monitoring.coreos.com
kubectl delete crd prometheusrules.monitoring.coreos.com
kubectl delete crd servicemonitors.monitoring.coreos.com
kubectl delete crd thanosrulers.monitoring.coreos.com
TODO
- 实现告警通过 Webhook 推送到钉钉机器人 :smiling_face_with_tear:
- 部署钉钉告警服务至集群 :expressionless:
- 将钉钉告警服务整合至 Helm Chart :exploding_head:
- 以上使用的 Chart 基于 kube-prometheus-stack 修改,后期将简化 Chart
参考
- Grafana
- Helm Docs
- Prometheus
- 钉钉开放平台
- Prometheus Book
- kube-prometheus-stack
- prometheus-blackbox-exporter
- Additional Scrape Configuration
- Prometheus 做 POST 接口请求监控
- Helm upgrade fails with an error…
- Customize Scrape Configurations
- Prometheus Alert Model for Python
- Create a Multi-Cluster Monitoring Dashboard with Thanos, Grafana and Prometheus