Abstract
大多数视觉识别研究在很大程度上依赖于深度神经网络(DNNs)训练中的人群标记的数据,并且通常为每项视觉识别任务进行训练DNN,从而导致艰苦而耗时的视觉识别范式。为了应对这两个挑战,最近对视觉语言模型(VLM)进行了深入研究,该模型从网络尺度的图像-文本对中学习了丰富的视觉和语言相关性,这些相关是在互联网上几乎是无限可用的,并且可以通过单个VLM对各种视觉识别任务进行零样本预测。本文为各种视觉识别任务提供了对视觉语言模型的系统评价,包括:(1)引入视觉识别范式发展的背景; (2)总结了广泛的网络体系结构,预训练目标和下游任务的VLM基础; (3)VLM预训练和评估中广泛采用的数据集; (4)现有VLM预训练方法,VLM转移学习方法和VLM知识蒸馏方法的审查和分类; (5)对审查方法的基准测试,分析和讨论; (6)在未来的VLM研究中,可以追求的一些研究挑战和潜在的研究方向以进行视觉识别。
Introduction
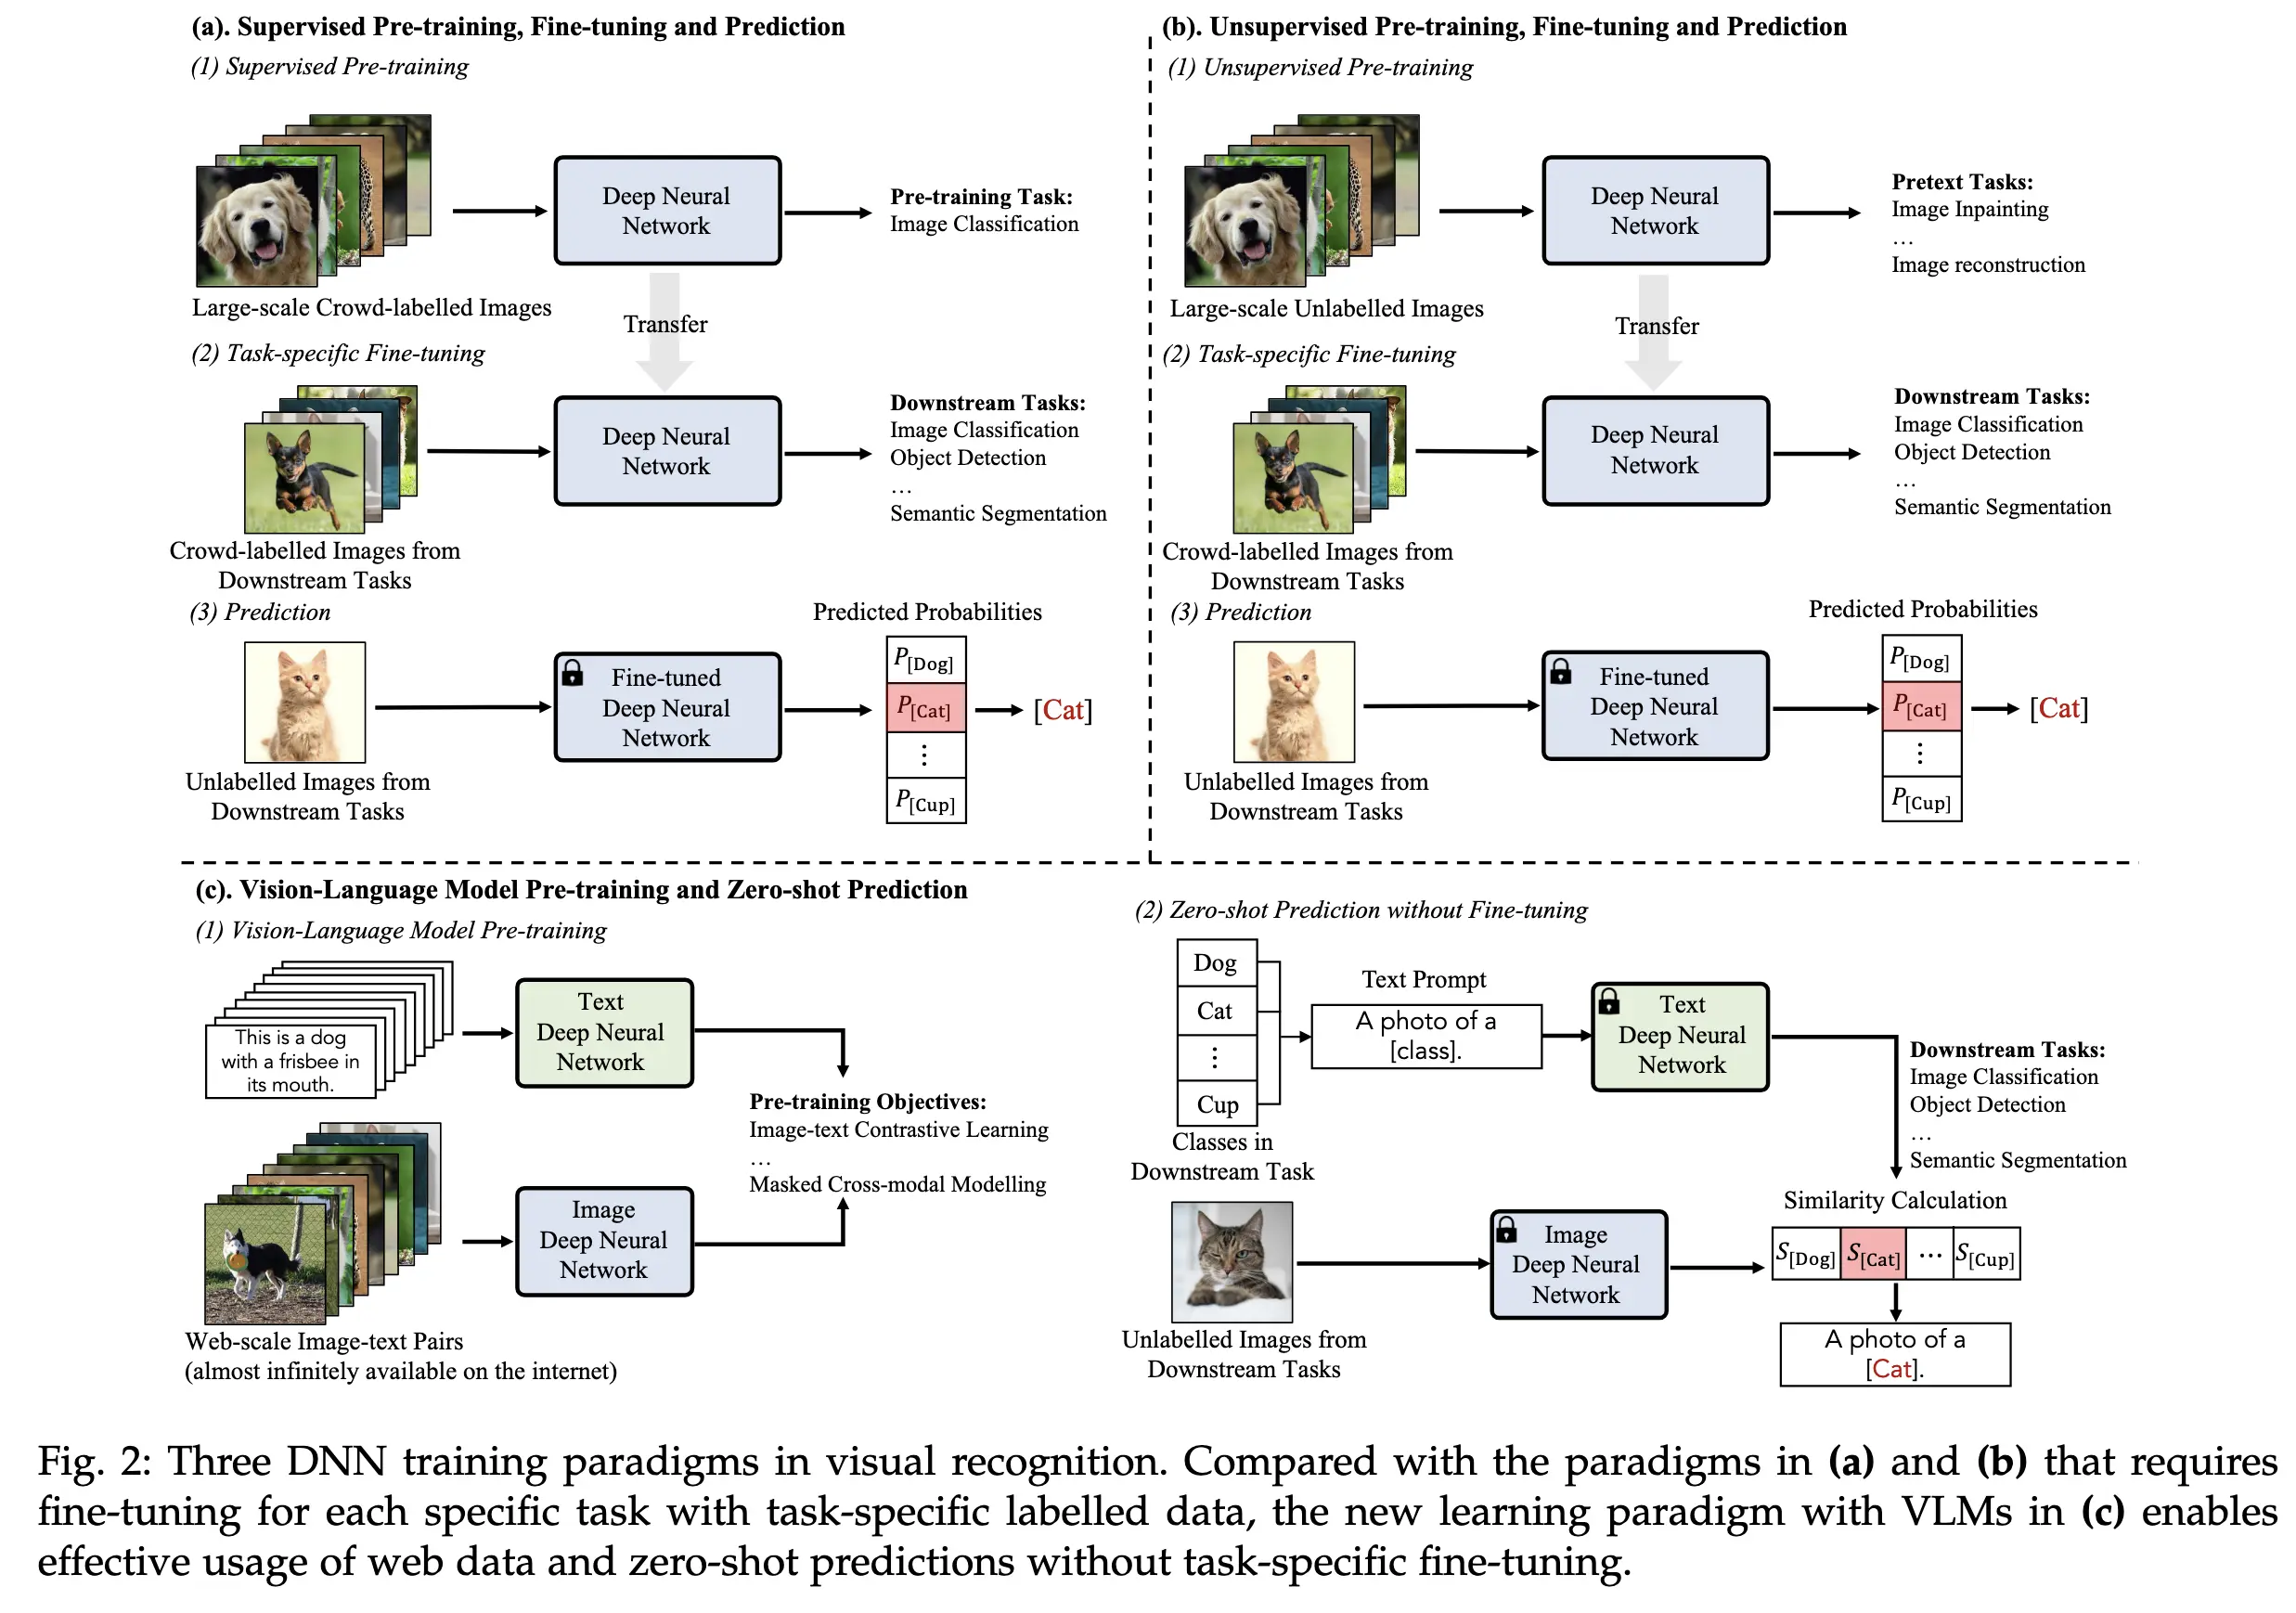
视觉识别作为计算机视觉研究的核心及众多应用的基石,在深度学习时代虽借助深度神经网络取得巨大成功,但面临训练收敛慢和数据标注繁琐的难题。“预训练、微调和预测” 范式一定程度上缓解问题,但仍需针对下游任务微调。受自然语言处理启发的 “视觉 - 语言模型预训练与零样本预测” 范式兴起,其利用互联网图像 - 文本对预训练视觉语言模型(VLM),无需微调即可用于下游任务,如 CLIP 通过图像 - 文本对比目标在嵌入空间匹配样本,在 36 项视觉识别任务中展现卓越零样本性能。此后,VLM 研究向迁移学习(如提示调优、视觉适配)和知识蒸馏方向拓展。
Background
训练视觉识别的范例
视觉识别训练范式的发展大致可分为以下五个阶段:
- 传统机器学习与预测
- 从零开始深度学习与预测
- 监督预训练、微调与预测
- 无监督预训练、微调与预测
- 视觉语言模型预训练与零样本预测
传统的机器学习和预测
在深度学习时代之前,视觉识别研究主要依赖特征工程,即通过人工设计的特征,结合轻量级学习模型,将手工设计的特征分类为预定义的语义类别。然而,这种范式需要领域专家为特定的视觉识别任务设计有效的特征,这对复杂任务的适应性较差,且缺乏良好的扩展性。
从头开始和预测深入学习
随着深度学习的出现,视觉识别研究通过利用端到端可训练的深度神经网络(DNN)取得了巨大成功。这种方法规避了复杂的特征工程,让研究者能够专注于神经网络架构的设计,以学习更有效的特征。例如,ResNet通过跳跃连接设计实现了非常深的网络,并能够利用大规模人工标注数据在具有挑战性的ImageNet基准上取得前所未有的性能。然而,从传统机器学习向深度学习的转变也带来了两大挑战:
- 在从零开始深度学习训练的经典设置下,DNN的训练收敛速度较慢;
- 训练DNN需要大规模、任务特定且由人工标注的数据。
监督预训练、微调与预测
随着研究发现从标注的大规模数据集中学习到的特征可以迁移到下游任务,从零开始深度学习与预测的范式逐渐被监督预训练、微调与预测的范式所取代。该新范式通过监督损失在大规模标注数据(如ImageNet)上对DNN进行预训练,然后使用任务特定的训练数据对预训练模型进行微调。由于预训练的DNN已经学习了某些视觉知识,这种方法可以加速网络的收敛,并帮助在有限的任务特定数据上训练出性能优异的模型。
无监督预训练、微调与预测
尽管监督预训练、微调与预测在许多视觉识别任务上取得了最先进的性能,但其在预训练阶段需要大规模标注数据。为减少这一限制,研究者提出了一种新的学习范式:无监督预训练、微调与预测,该方法探索了自监督学习,通过未标注数据学习有用且可迁移的表示。为此,提出了各种自监督训练目标,包括用于建模跨图像块关系的掩码图像建模(masked image modelling)和通过对比样本来学习判别特征的对比学习(contrastive learning)等。自监督预训练的模型随后通过标注的任务特定数据进行微调。由于这种范式在预训练中不需要标注数据,可以利用更多的训练数据来学习有用且可迁移的特征,从而在性能上优于监督预训练。
VLM预训练与零样本预测
尽管监督或无监督的预训练与微调方法可以改善网络的收敛速度,但仍然需要通过标注的任务特定数据进行微调。受到自然语言处理领域的巨大成功的启发,一种新的深度学习范式——视觉-语言模型预训练与零样本预测被提出用于视觉识别。在这种范式中,通过从几乎无限量的网络图像-文本对中学习,VLM利用特定的视觉-语言目标进行预训练,捕获丰富的视觉-语言知识,并能通过匹配任何给定图像和文本的嵌入来实现零样本预测(无需微调)。
与预训练与微调范式相比,这种新范式能够有效利用大规模的网络数据,并在不进行任务特定微调的情况下实现零样本预测。现有研究主要从以下三个方面改进VLM:
- 收集大规模且有信息量的图像-文本数据;
- 设计高容量模型以从大数据中进行有效学习;
- 设计新的预训练目标以学习更有效的VLM。
用于视觉识别的VLM发展
自CLIP的提出以来,与视觉识别相关的VLM研究取得了显著进展。我们从以下三个方面概述VLM在视觉识别中的发展:
- 预训练目标:从“单一目标”到“多目标混合”。早期的VLM通常采用单一的预训练目标,而近期的VLM引入了多种目标(例如对比、对齐和生成目标),通过探索这些目标之间的协同作用,开发出更稳健的VLM并在下游任务中实现更好的性能。
- 预训练框架:从“多独立网络”到“统一网络”。早期的VLM采用了双塔式(two-tower)预训练框架,而近期的VLM尝试使用单塔式(one-tower)预训练框架,在一个统一的网络中对图像和文本进行编码,这种方法不仅减少了GPU内存的使用,还提高了跨模态数据的通信效率。
- 下游任务:从简单任务到复杂任务。早期的VLM主要专注于图像级别的视觉识别任务,而近期的VLM则更加通用化,能够应用于复杂的密集预测任务,这些任务通常需要定位相关的知识。
VLM Foundations
网络架构
VLM预训练依赖于深度神经网络从预训练数据集中提取图像和文本特征。深度神经网络包含一个图像编码器和一个文本编码器,分别将图像和文本编码为图像嵌入和文本嵌入。
图像特征学习的架构
用于学习图像特征的网络架构主要包括两类:基于卷积神经网络(CNN)的架构和基于Transformer的架构。
CNN架构
不同的卷积网络被设计用于学习图像特征。其中,ResNe作为VLM预训练中最受欢迎的卷积网络之一,通过在卷积块之间引入跳跃连接来缓解梯度消失和爆炸问题,从而支持非常深的网络。为了更好地提取特征并建模视觉-语言关系,一些研究对原始网络架构进行了改进。例如,改进ResNet时,引入了ResNet-D,采用了抗锯齿的rect-2模糊池化,并用Transformer多头注意力中的注意力池化替代了全局平均池化。
Transformer架构
近年来,Transformer在图像分类、目标检测和语义分割等视觉识别任务中得到了广泛应用。作为一种标准的图像特征学习Transformer架构,ViT由多层Transformer模块堆叠而成,每个模块由一个多头自注意力层和一个前馈网络组成。输入图像首先被分割为固定大小的图像块,经过线性投影和位置嵌入后送入Transformer编码器。一些研究通过在Transformer编码器之前增加归一化层对ViT进行了改进。
文本特征学习的架构
Transformer及其变体被广泛用于学习文本特征。标准的Transformer采用了编码器-解码器结构,其中编码器包含6个模块,每个模块包括一个多头自注意力层和一个多层感知机(MLP);解码器也由6个模块组成,每个模块包含一个多头注意力层、一个掩码多头注意力层和一个MLP。大多数VLM研究采用了标准的Transformer,并在GPT2的基础上稍作修改,从头开始训练,而未使用GPT2权重进行初始化。
VLM 预训练目标
对比目标
对比目标通过拉近配对样本、拉远其他样本在特征空间中的距离,训练VLM学习判别性表征。
图像对比学习 图像对比学习:旨在通过使查询图像与其正样本(如数据增强后的图像)更接近,同时与负样本(如其他图像)更远,来学习判别性图像特征。给定一批大小为 ( B ) 的图像,对比学习目标(如InfoNCE及其变体)的公式如下:
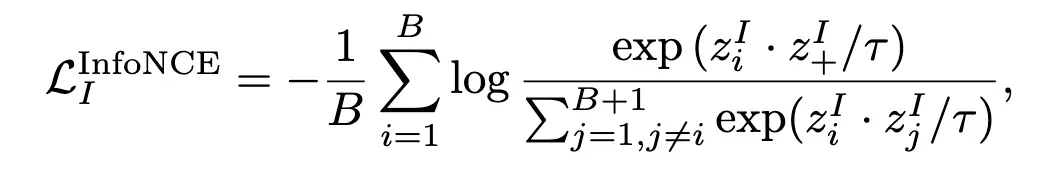
图像-文本对比学习
通过拉近成对图像和文本的嵌入,同时拉远其他样本,实现判别性图像-文本表征的学习。通常通过3最小化对称的图像-文本InfoNCE损失来实现
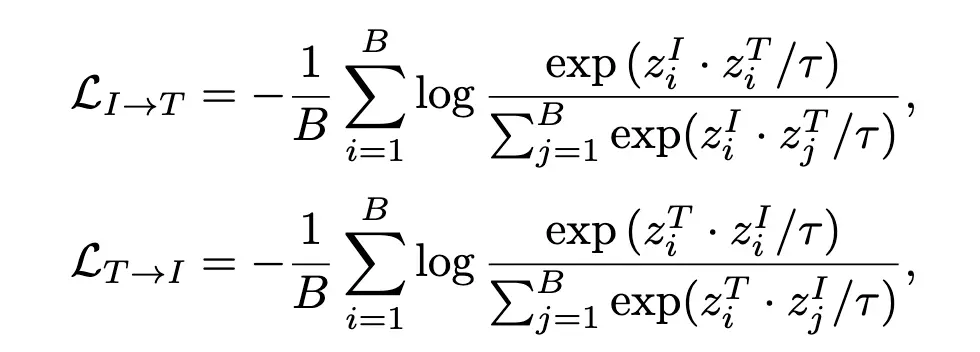
图像-文本-标签对比学习
将监督对比学习引入到图像-文本对比学习中,公式如下:
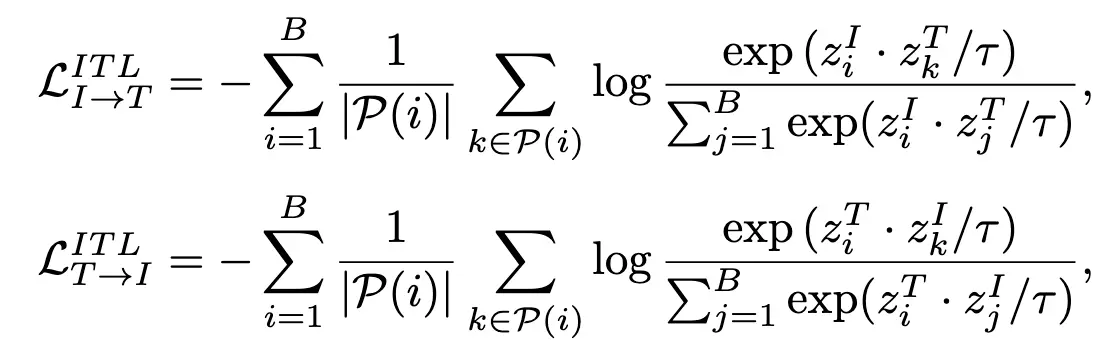
生成目标
生成目标通过训练网络生成图像或文本数据、语言生成或跨模态生成,学习语义特征。
掩码图像建模(Masked Image Modelling)
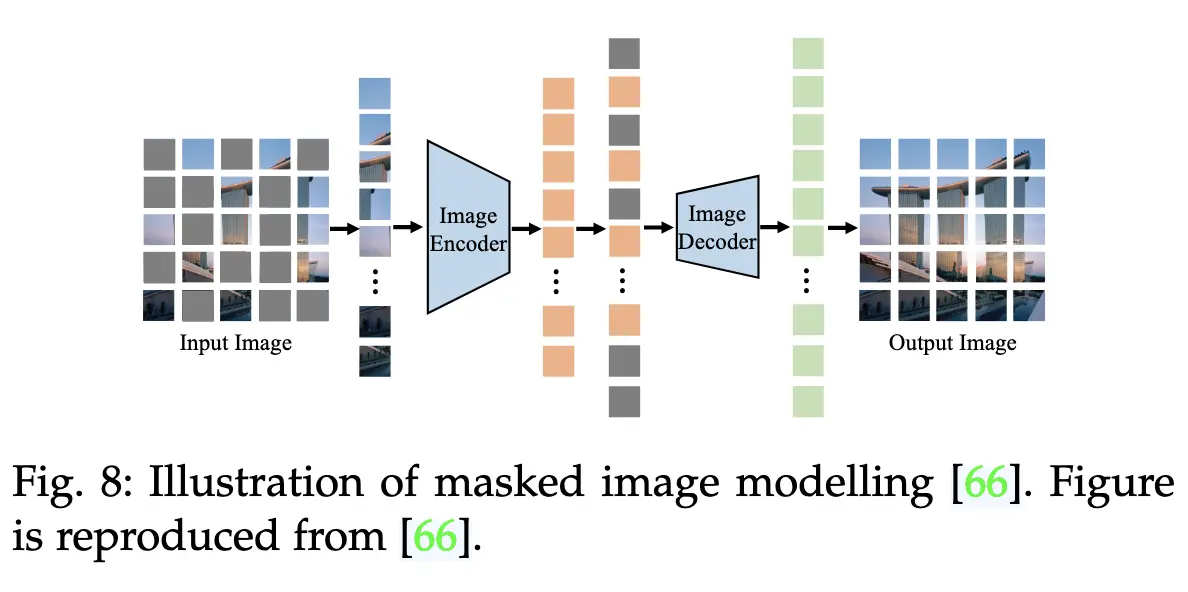
通过随机屏蔽输入图像的一部分并训练编码器重建被屏蔽部分,学习跨图像块的关联
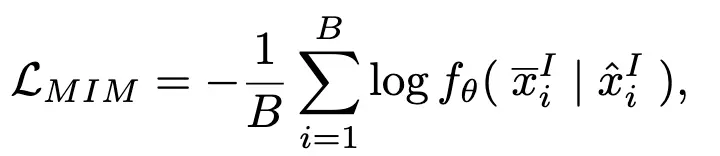
掩码语言建模(Masked Language Modelling)
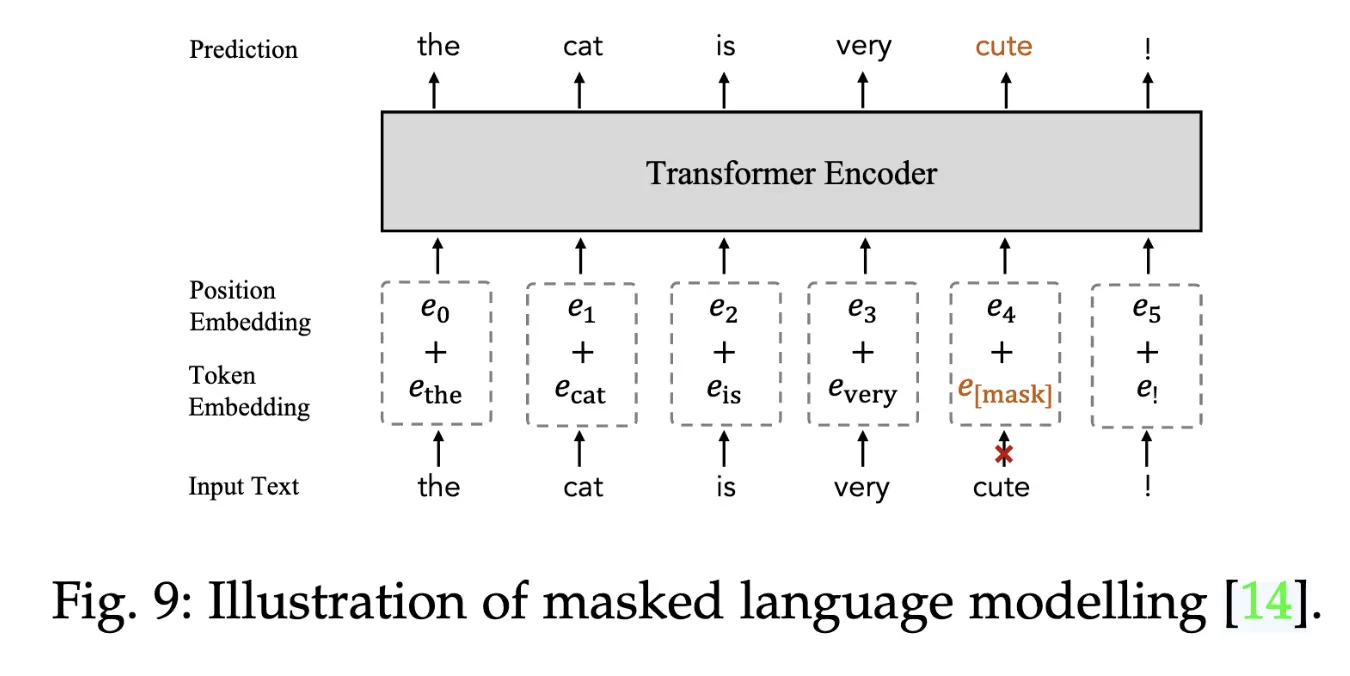
NLP中广泛采用的预训练目标,随机屏蔽一定比例的文本标记(如BERT的15%),并通过未屏蔽的标记重建:
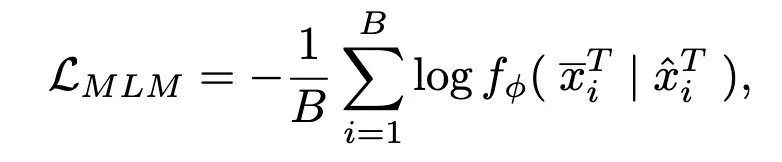
掩码跨模态建模(Masked Cross-Modal Modelling)
结合掩码图像建模和掩码语言建模,屏蔽图像块和文本标记并通过未屏蔽部分重建:
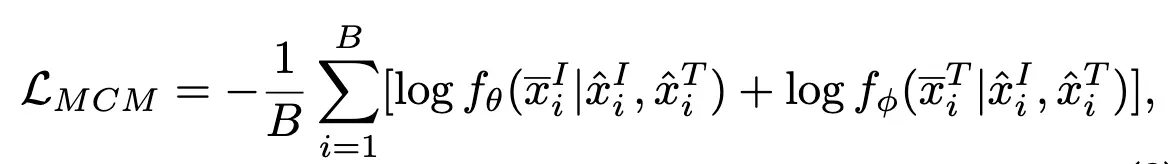
图像到文本生成(Image-to-Text Generation)
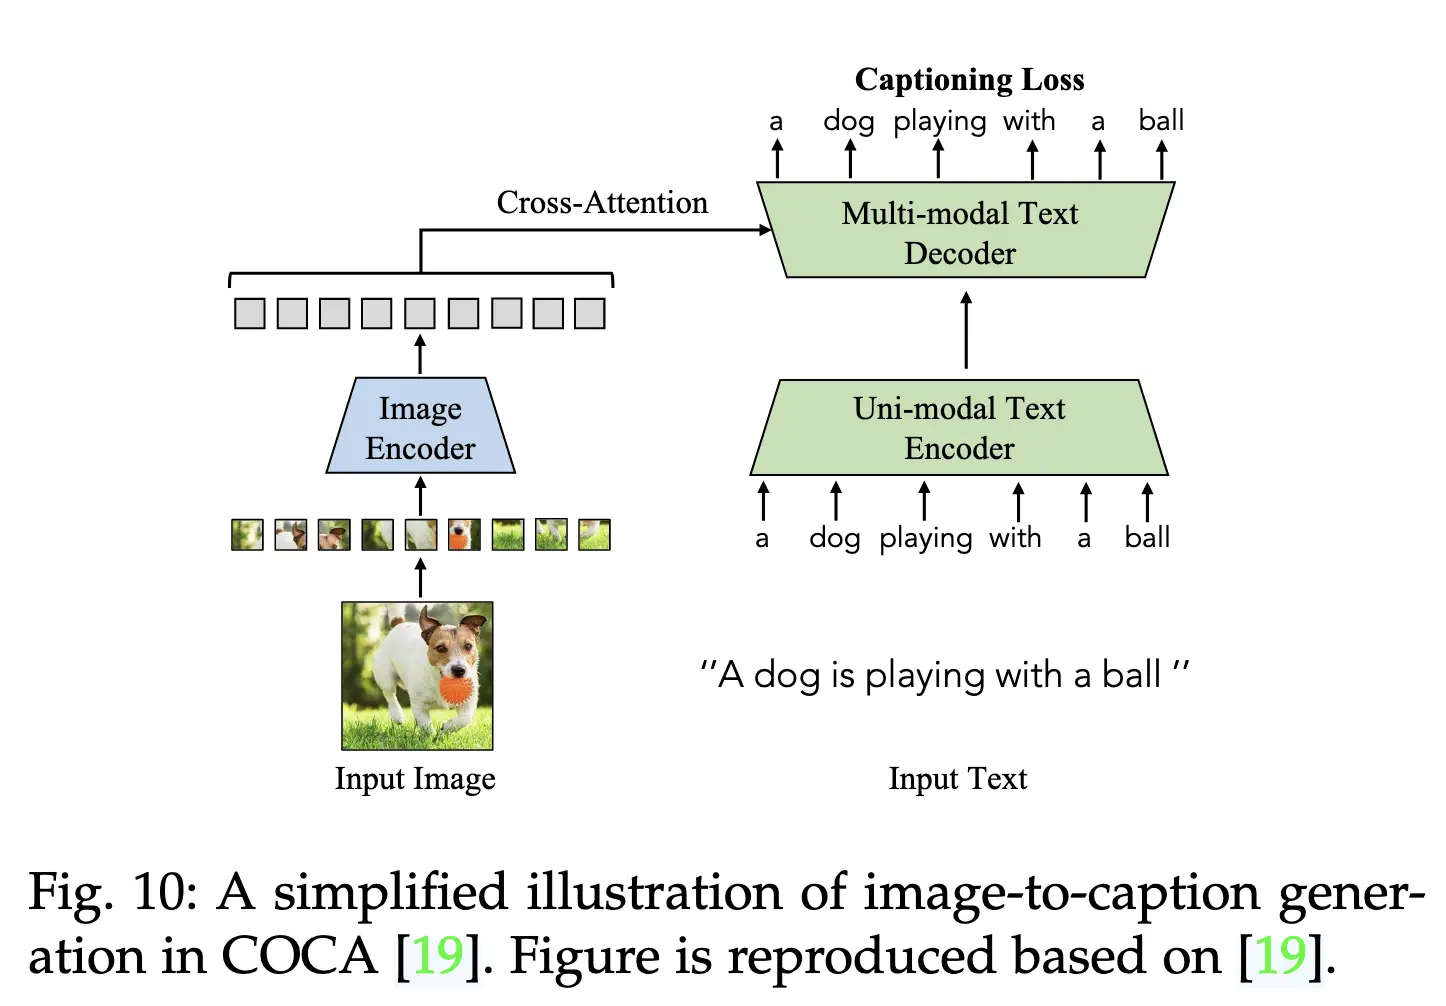
通过训练网络根据配对图像逐步生成描述文本,捕获细粒度视觉-语言关联:
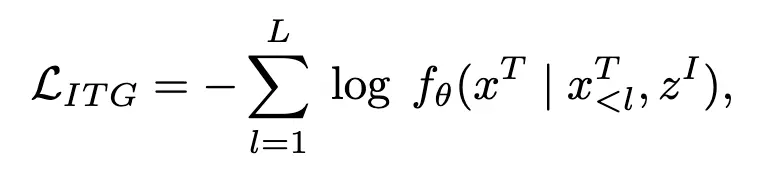
对齐目标
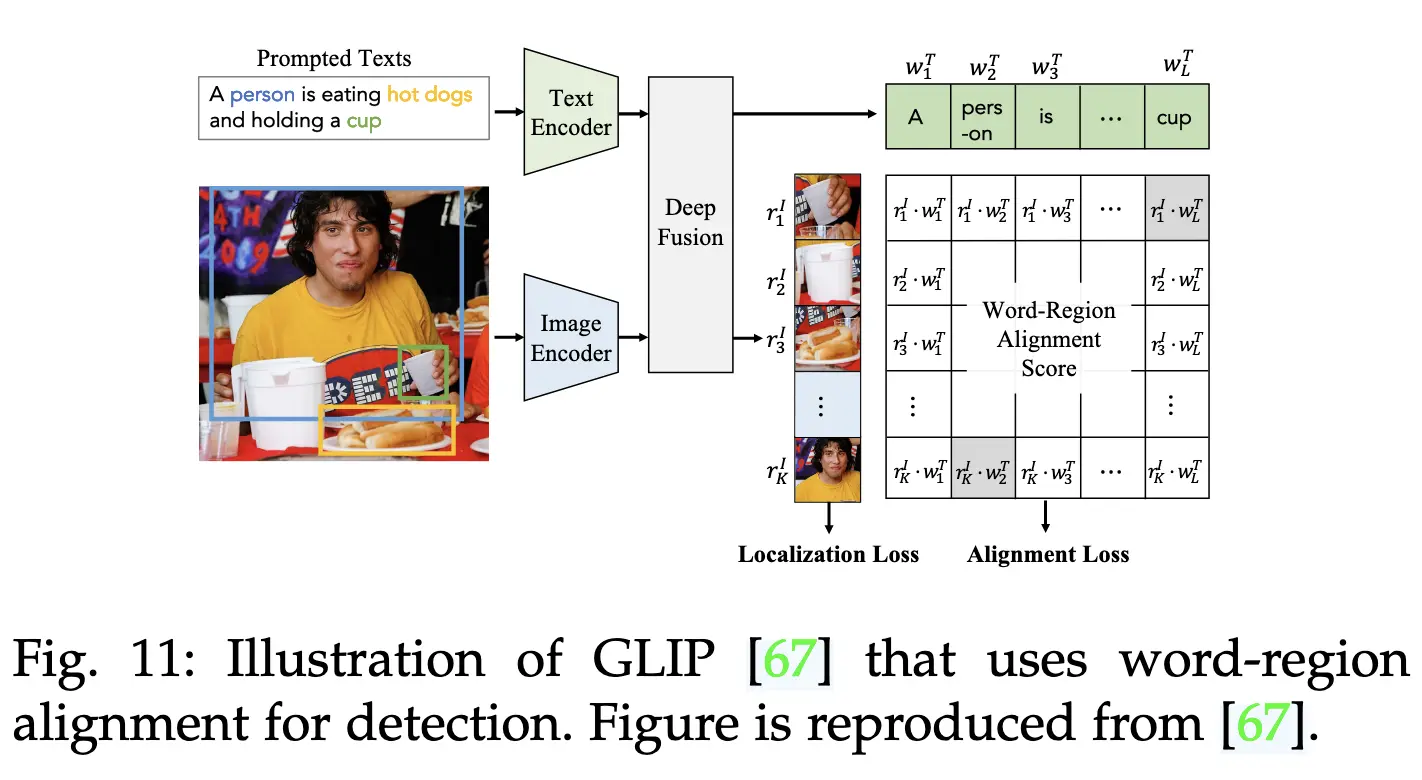
对齐目标通过全局图像-文本匹配或局部区域-单词匹配在嵌入空间中对齐图像-文本对。
图像-文本匹配
通过度量图像和文本的匹配概率 ( S(·) ),用二元分类损失建模全局图像-文本关联:
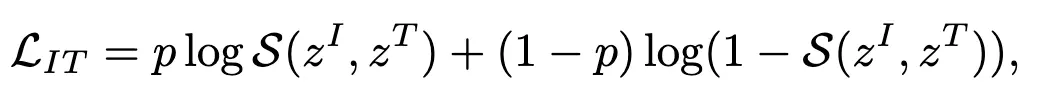
区域-单词匹配
对图像区域和单词进行局部匹配,适用于目标检测等密集视觉任务:
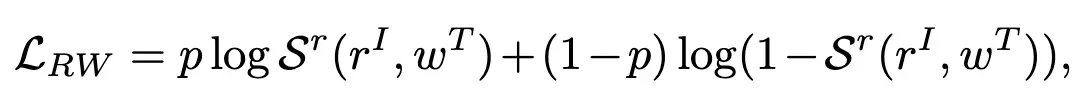
VLM预训练框架
VLM预训练的框架主要包括双塔式(Two-Tower)、双腿式(Two-Leg)和单塔式(One-Tower)。
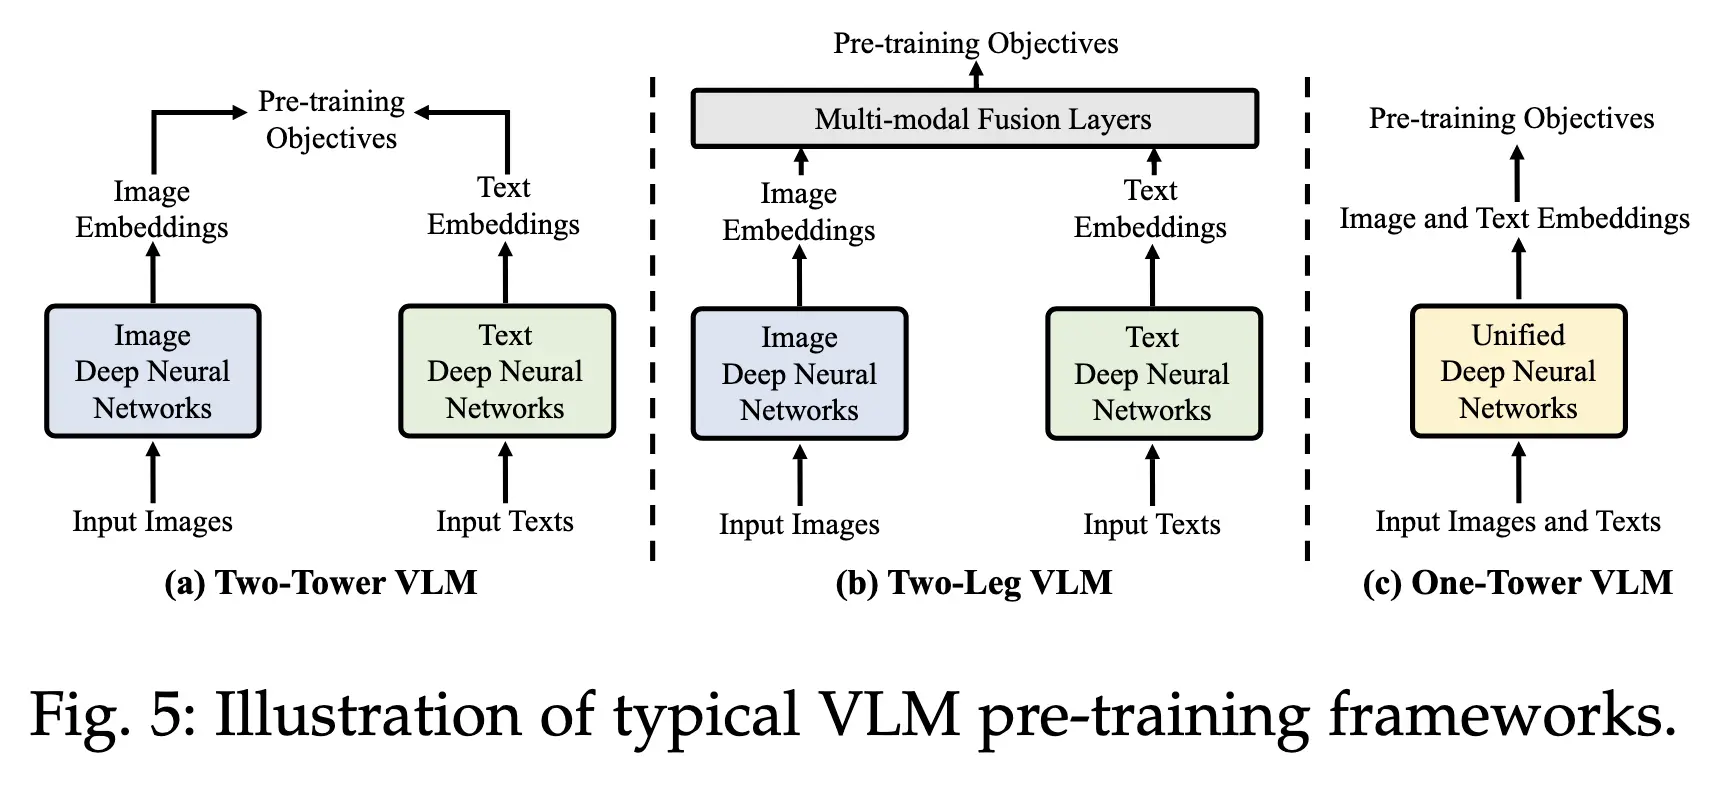
双塔式框架:图像和文本分别用两个编码器独立编码(如图5(a))。
双腿式框架:增加多模态融合层,使图像和文本特征可以交互(如图5(b))。
单塔式框架:在单一编码器中统一视觉和语言学习,提升跨模态通信效率(如图 5(c))。
评估设置与下游任务
零样本预测
零样本预测是评估VLM泛化能力的最常用方式。在这种设置下,预训练的VLM无需任务特定的微调,直接应用于下游任务。
- 图像分类:目标是将图像分类为预定义类别。VLM通过比较图像和文本的嵌入实现零样本图像分类,其中常采用“提示工程”(Prompt Engineering)生成任务相关提示词,例如“a photo of a [label]”。
- 语义分割:目标是为图像中的每个像素分配一个类别标签。预训练的VLM通过比较图像像素和文本的嵌入实现语义分割任务的零样本预测。
- 目标检测:目标是定位并分类图像中的物体,这是许多视觉应用的重要任务。通过从辅助数据集中学习的物体定位能力,预训练的VLM通过比较给定物体提议(object proposals)和文本的嵌入实现目标检测的零样本预测。
- 图像-文本检索:目标是在一种模态中,根据另一种模态的提示检索所需样本,包括文本到图像检索(基于文本检索图像)和图像到文本检索(基于图像检索文本)。
线性探测
线性探测在VLM评估中被广泛采用。它冻结预训练的VLM,并训练一个线性分类器对VLM编码的嵌入进行分类,以评估VLM的表征能力。
- 图像分类:在此设置中,评估VLM编码特征在图像分类任务中的性能。
- 动作识别:动作识别任务中,通常对视频片段进行子采样以实现高效识别。
这种评估方法为VLM提供了一个衡量其表征泛化能力的标准,同时不依赖于模型的大规模微调。
视觉-语言模型预训练
基于对比目标的VLM预训练
图像对比学习
这一预训练目标旨在学习图像模态中的判别性特征,通常作为辅助目标以充分挖掘图像数据的潜力。例如,SLIP使用标准的InfoNCE损失来学习判别性图像特征。
图像-文本对比学习
图像 - 文本对比学习通过拉近配对图像与文本嵌入、拉远非配对嵌入来学习视觉 - 语言关联,如 CLIP 采用对称的图像 - 文本 InfoNCE 损失,通过嵌入点积计算相似性,使预训练 VLM 能实现下游任务的零样本预测。受其启发,后续研究从多方面改进:
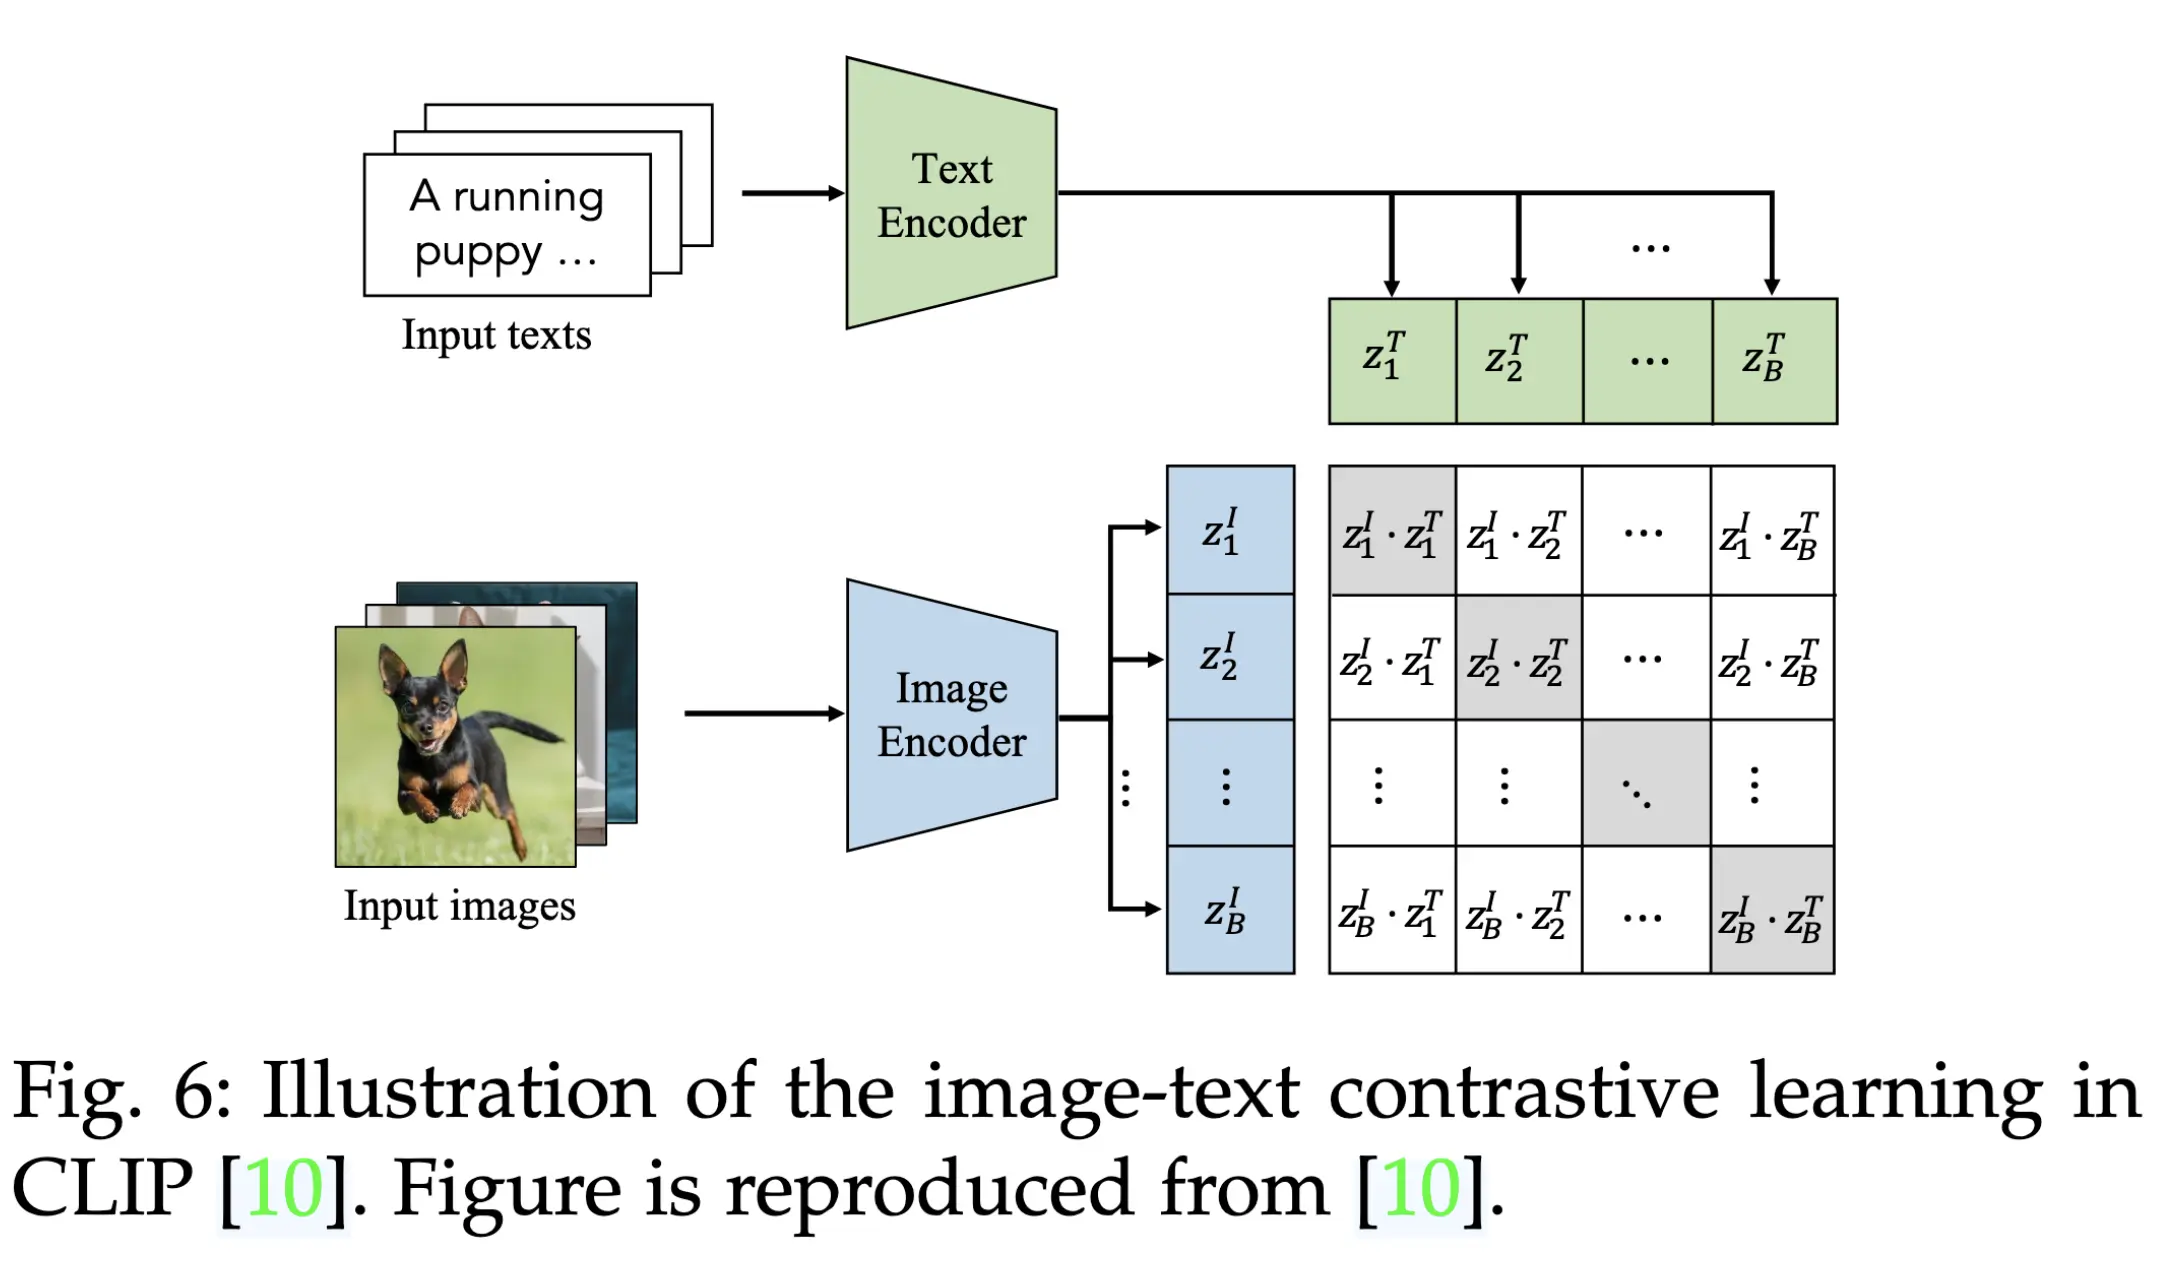
- 规模与抗噪优化:ALIGN 用 18 亿对噪声数据结合抗噪对比学习扩大预训练规模;DeCLIP 引入最近邻监督、OTTER 通过最优传输伪配对、ZeroVL 采用去偏采样与数据增强,实现数据高效预训练。
- 跨语义层次建模:FILIP 引入区域 - 单词对齐实现细粒度对应,PyramidCLIP 构建多语义层次进行跨层与同层对比学习。
- 数据增强与模态交互:LA-CLIP、ALIP 用大语言模型生成图像描述,RA-CLIP 检索相关对增强数据;部分研究尝试用单一编码器统一视觉与语言学习以促进跨模态交互。
图像-文本-标签对比学习
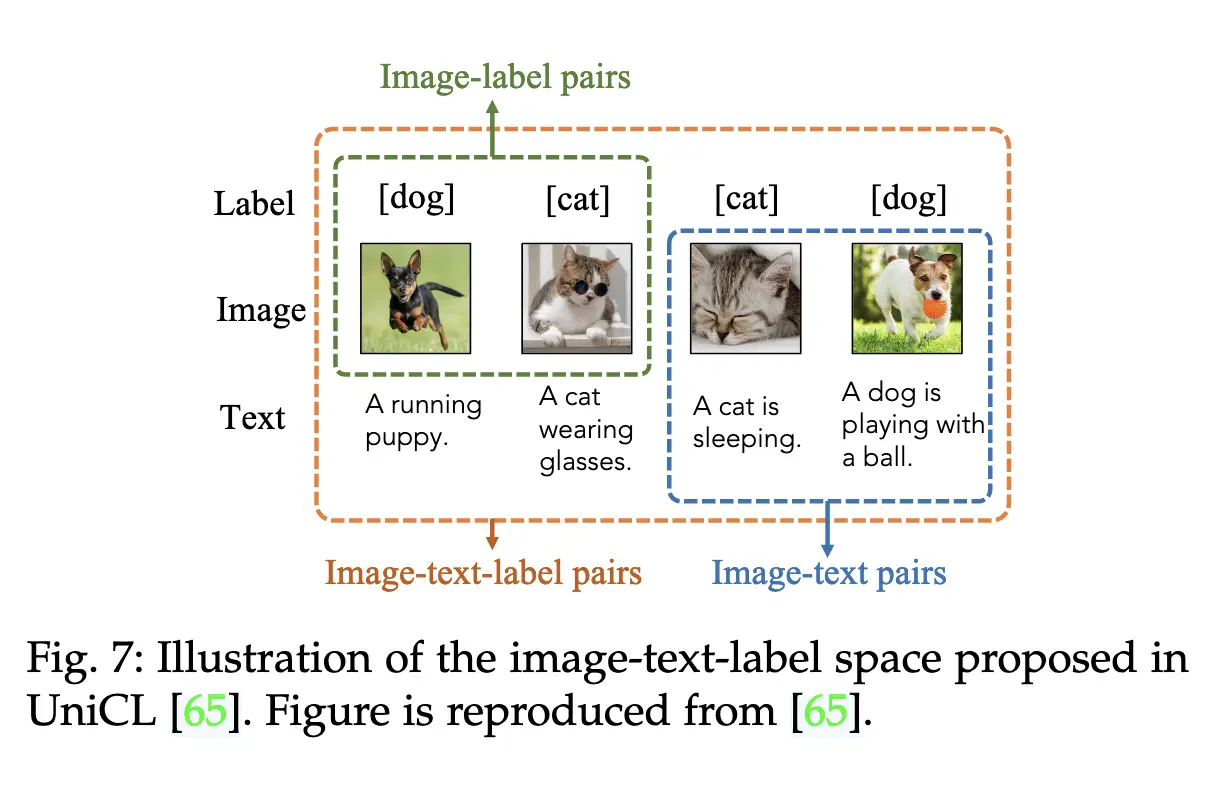
这种预训练方法将图像分类标签引入到图像-文本对比中,并将图像、文本和分类标签编码到共享空间中。该方法结合了带有图像标签的监督预训练和带有图像-文本对的无监督VLM预训练。例如,UniCL的研究表明,这种预训练方法能够同时学习判别性和任务特定(如图像分类)的特征。后续研究使用约9亿对图像-文本对扩展了UniCL的规模,在各种下游识别任务中表现卓越。
基于生成目标的VLM预训练
掩码图像建模
掩码图像建模通过屏蔽并重建图像来学习图像的上下文信息(见公式6)。在掩码图像建模(例如MAE和BeiT)中,图像的部分块被屏蔽,编码器被训练在未屏蔽的块条件下重建被屏蔽的部分,如图8所示。例如,FLAVA采用了这种方法来提升图像上下文信息的建模能力。
掩码语言建模
掩码语言建模是NLP中广泛使用的预训练目标,也在VLM预训练中证明了其在文本特征学习中的有效性。其方法是屏蔽每段输入文本中的一部分标记,并训练网络预测被屏蔽的标记。遵循BERT的方法,FLAVA屏蔽了15%的文本标记并利用其余标记重建,以建模跨单词的关联关系。FIBER也将掩码语言建模作为VLM预训练目标之一,用于提取更优的语言特征。
掩码跨模态建模
掩码跨模态建模同时屏蔽和重建图像块和文本标记,继承了掩码图像建模和掩码语言建模的优势。其方法是屏蔽一定比例的图像块和文本标记,并训练VLM通过未屏蔽的图像块和文本标记的嵌入重建被屏蔽部分。例如,FLAVA屏蔽了约40%的图像块和15%的文本标记,并使用多层感知机(MLP)预测被屏蔽的块和标记,从而捕捉丰富的视觉-语言对应信息。
图像到文本生成
图像到文本生成旨在为给定图像生成描述性文本,通过训练VLM预测标记化文本来捕捉细粒度的视觉-语言关联。其方法首先将输入图像编码为中间嵌入,然后解码为描述性文本(见公式9)。例如,COCA、NLIP和PaLI使用标准的编码器-解码器架构和图像描述目标进行训练。
基于对齐目标的VLM预训练
对齐目标通过学习判断给定的文本是否正确描述给定图像,使VLM能够对配对的图像和文本进行对齐。这类目标主要分为全局图像-文本匹配和局部区域-单词匹配。‘
图像-文本匹配
图像-文本匹配通过直接对齐配对的图像和文本建模全局的图像-文本关联。例如,在一批图像-文本对中,FLAVA使用分类器和二元分类损失,将给定图像与其配对文本进行匹配。FIBER遵循的方法,通过成对相似性挖掘难负样本,从而实现更好的图像与文本对齐。
区域-单词匹配
区域-单词匹配目标通过对齐配对的图像区域和文本标记建模局部细粒度的视觉-语言关联,这对目标检测和语义分割等密集预测任务的零样本预测非常有益。例如,GLIP、FIBER和DetCLIP将目标分类的logits替换为区域-单词对齐得分,即区域视觉特征与逐标记文本特征之间的点积相似性。
VLM 迁移学习
迁移学习的动机
尽管预训练的VLM展现出强大的泛化能力,但在应用于下游任务时通常面临两类差距:
- 图像和文本分布差距:例如,下游数据集可能具有特定任务的图像风格和文本格式;
- 训练目标差距:VLM通常以任务无关的目标进行训练,学习的是通用概念,而下游任务通常涉及任务特定的目标,如粗粒度或细粒度分类、区域级别或像素级别的识别等。
常见迁移学习设置
为弥补上述的领域差距,探索了三种迁移学习设置:
- 监督迁移:使用全部标注的下游数据微调预训练的VLM;
- 小样本监督迁移:只使用少量标注的下游样本,具有更高的标注效率;
- 无监督迁移:使用未标注的下游数据微调VLM,尽管更具挑战性,但具有更高的潜力和效率。
常见迁移学习方法
通过提示调优进行迁移
受到NLP中“提示学习”的启发,许多VLM提示学习方法被提出,用于通过寻找最佳提示词将VLM适配到下游任务,而无需微调整个模型。提示调优的方法主要包括文本提示调优、视觉提示调优,以及文本-视觉联合提示调优。
文本提示调优
不同于手动设计提示词的提示工程,文本提示调优通过为每个类别生成可学习的提示词,在少量标注样本的帮助下探索更高效的提示词。例如:
- CoOp:通过上下文优化为单一类别名称学习上下文词,将类别标签扩展为句子“[V]1, [V]2, …, [V]m [label]”,其中[V]表示可学习的词向量。
- CoCoOp:通过条件上下文优化为每张图像生成特定提示词,缓解提示学习中因样本数量有限导致的过拟合问题。
- SoftCPT:在多个小样本任务上同时微调VLM,利用多任务学习提升性能。
- UPL:通过伪标签样本的自训练优化可学习提示,实现无监督提示调优。
视觉提示调优
通过调节图像编码器的输入实现VLM迁移。例如:
- VP:通过添加可学习的图像扰动项来调整输入图像,从而最小化识别损失。
- RePrompt:将检索机制集成到视觉提示调优中,以利用下游任务的知识。
文本-视觉联合提示调优
同时调节文本和图像输入,利用多模态联合优化提示词的优势。例如:
- UPT:统一提示调优方法,同时优化文本和图像提示。
- MAPLE:通过对齐视觉提示与对应的语言提示,实现文本提示与图像提示的互相促进。
通过特征适配器进行迁移
特征适配器通过插入额外的轻量级模块微调VLM,用于调整图像或文本特征。例如:
- Clip-Adapter:在CLIP的语言和图像编码器后插入可训练的线性层,并冻结CLIP的参数。
- Tip-Adapter:通过使用小样本标注图像的嵌入作为适配器权重,无需训练即可完成迁移。
特征适配器灵活有效,适合不同下游任务,但需要修改网络结构,可能无法应用于涉及知识产权问题的VLM。
其他迁移方法
其他迁移方法包括直接微调、架构修改和交叉注意力机制。例如:
- Wise-FT:结合微调后模型的权重与原始模型的权重,从下游任务中学习新信息。
- MaskCLIP:通过修改CLIP的图像编码器架构提取密集图像特征。
- CALIP:引入无参数注意力机制以增强视觉和文本特征之间的交互。
VLM 知识蒸馏
VLM捕获了涵盖广泛视觉和文本概念的通用知识。一些研究探讨了如何蒸馏这种通用且稳健的VLM知识,以应对目标检测和语义分割等复杂的密集预测任务。本节介绍了从VLM蒸馏知识的动机,以及在语义分割和目标检测任务上的知识蒸馏方法。
VLM知识蒸馏的动机
与通常保持原始VLM架构不变的迁移学习不同,VLM知识蒸馏将通用且稳健的VLM知识蒸馏到任务特定模型中,而不受VLM架构的限制,从而在解决各种密集预测任务时受益于任务特定的设计。例如,知识蒸馏允许将VLM的通用知识转移到目标检测任务,同时利用先进的检测架构,如Faster R-CNN和DETR。
目标检测的知识蒸馏
开放词汇目标检测旨在检测由任意文本描述的目标,即超出基础类别的任何类别的目标。由于VLM(如CLIP)使用亿级图像-文本对进行训练,覆盖了非常广泛的词汇,许多研究探索通过蒸馏VLM知识来扩展检测器的词汇量。例如:
- ViLD:将VLM知识蒸馏到一个两阶段检测器中,强制其嵌入空间与CLIP的图像编码器一致;
- HierKD:探索分层的全局-局部知识蒸馏;
- RKD:探索基于区域的知识蒸馏,以更好地对齐区域级和图像级嵌入;
- ZSD-YOLO:引入自标注数据增强,利用CLIP提升目标检测性能;
- DetPro:引入检测提示技术,学习连续提示表示以进行开放词汇目标检测;
- PB-OVD:利用VLM预测的伪边界框训练目标检测器;
- P3OVD:结合提示驱动的自训练方法,通过细粒度提示调优改进VLM生成的伪标签。
语义分割的知识蒸馏
开放词汇语义分割利用VLM扩展分割模型的词汇量,旨在分割由任意文本描述的像素(即超出基础类别的任何类别)。例如:
- CLIPSeg:引入轻量级Transformer解码器,将CLIP扩展至语义分割;
- LSeg:最大化CLIP文本嵌入与分割模型编码的像素级图像嵌入之间的相关性;
- ZegCLIP:利用CLIP生成语义掩码,并引入关系描述符以缓解基础类别上的过拟合问题;
- MaskCLIP+:通过VLM预测的像素级伪标签进行知识蒸馏;
- FreeSeg:首先生成掩码提议,然后对其进行零样本分类。
此外,弱监督语义分割的知识蒸馏结合VLM和弱监督信号(如图像级标签)进行分割。例如:
- CLIP-ES:通过设计Softmax函数和基于类别注意的亲和模块,利用CLIP改进类别激活图,缓解类别混淆问题;
- CLIMS:利用CLIP知识生成高质量的类别激活图,从而改进弱监督语义分割。
未来方向
VLM预训练的挑战与潜在方向
细粒度视觉-语言关联建模
通过学习局部视觉-语言对应知识,VLM能够识别超越图像的块和像素,这对目标检测和语义分割等密集预测任务尤为重要。然而,目前在这一方向上的研究非常有限,期待未来更多针对零样本密集预测任务的细粒度VLM预训练研究。
视觉与语言学习的统一
Transformer的出现使得通过统一方式对图像和文本进行标记成为可能,而不是像现有VLM中使用两个独立网络。统一视觉与语言学习能够提高数据模态间的交互效率,从而提升训练效果与效率。虽然已有一些研究关注这一问题,但还需要更多努力以开发更可持续的VLM。
多语言VLM预训练
现有大多数VLM只使用单一语言(如英语)进行训练,这可能引入文化与区域偏差,并限制其在其他语言场景中的应用。通过多语言文本预训练VLM,可以学习同一含义在不同语言中的文化视觉特征,从而使VLM能够在不同语言环境中高效工作。未来多语言VLM研究值得进一步探索。
数据高效的VLM
目前的研究通常依赖大规模训练数据和高强度计算,影响了可持续性。通过有限的图像-文本数据训练高效的VLM可以显著缓解这一问题。例如,除了学习每个图像-文本对,还可以通过对图像-文本对之间的监督信息挖掘更多有用信息。
结合大型语言模型(LLM)的VLM预训练
近期研究利用LLM丰富VLM预训练中的语言知识,具体来说,通过LLM扩充原始图像-文本对中的文本内容,从而提供更丰富的语言信息,帮助更好地学习视觉-语言关联。未来关于LLM在VLM预训练中的探索值得更多关注。
VLM迁移学习的挑战与潜在方向
无监督VLM迁移
现有VLM迁移研究大多使用需要标注数据的监督或小样本监督设置,而后者容易过拟合于少量标注样本。无监督VLM迁移可以利用大量未标注数据,降低过拟合风险。未来研究中对无监督VLM迁移的关注值得期待。
基于视觉提示/适配器的VLM迁移
大多数现有研究集中在文本提示学习,而视觉提示学习或视觉适配器在各种密集预测任务中能够提供像素级适配支持,却鲜有关注。未来的研究中需要更多探索基于视觉的VLM迁移方法。
测试时的VLM迁移
现有研究通常通过在每个下游任务上微调VLM(即提示学习)进行迁移,这在面对大量下游任务时显得重复且低效。测试时的VLM迁移允许在推理阶段动态调整提示词,从而避免现有迁移学习中的重复训练。预计这一方向将在未来得到更多关注。
结合LLM的VLM迁移
与提示工程和提示学习不同,一些研究利用LLM生成更能描述下游任务的文本提示。这种方法自动化程度高且几乎不需要标注数据,未来可以进一步探索LLM在VLM迁移学习中的应用。
VLM知识蒸馏的挑战与潜在方向
多VLM知识蒸馏
从多个VLM中蒸馏知识,并通过协同蒸馏不同VLM的知识来获得协同效应,这一方向值得探索。
更多视觉识别任务的知识蒸馏
除了目标检测和语义分割,未来可以将VLM知识蒸馏扩展到实例分割、全景分割、行人再识别等任务,以探索更多可能的应用场景。