Abstract
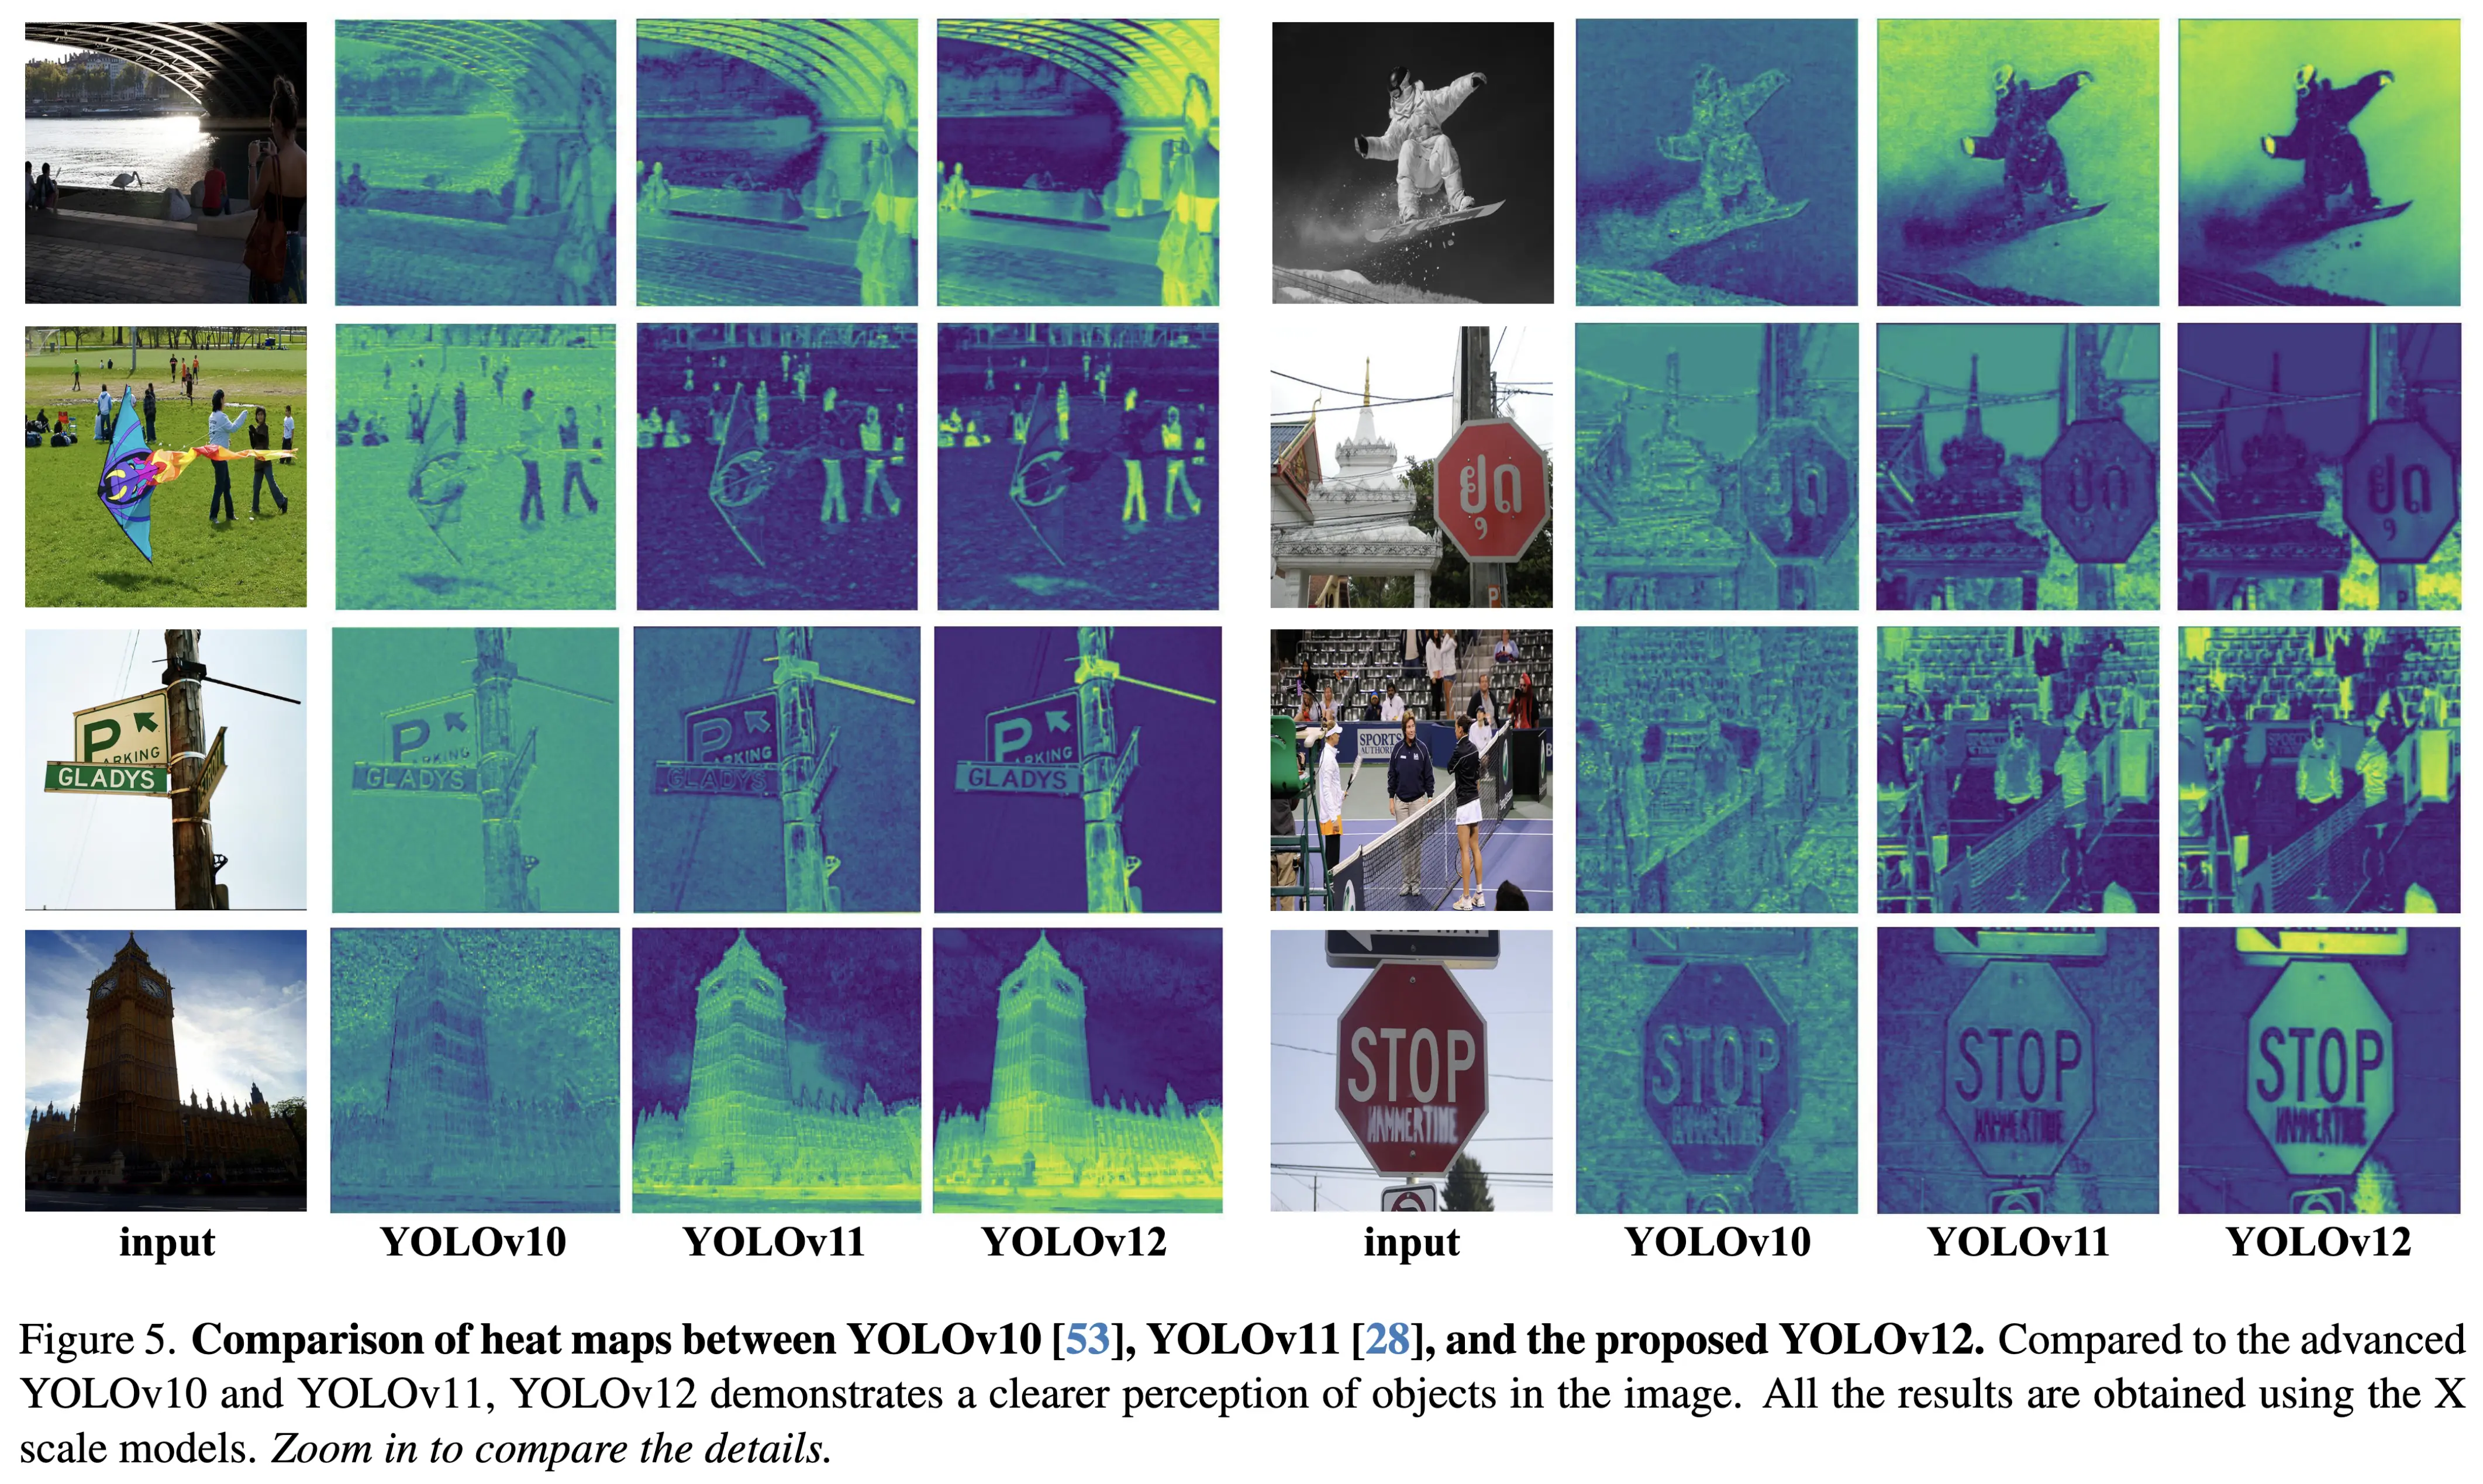
Enhancing the network architecture of the YOLO framework has been crucial for a long time, but has focused on CNN-based improvements despite the proven superiority of attention mechanisms in modeling capabilities. This is because attention-based models cannot match the speed of CNN-based models. This paper proposes an attention-centric YOLO framework, namely YOLOv12, that matches the speed of previous CNN-based ones while harnessing the performance benefits of attention mechanisms.
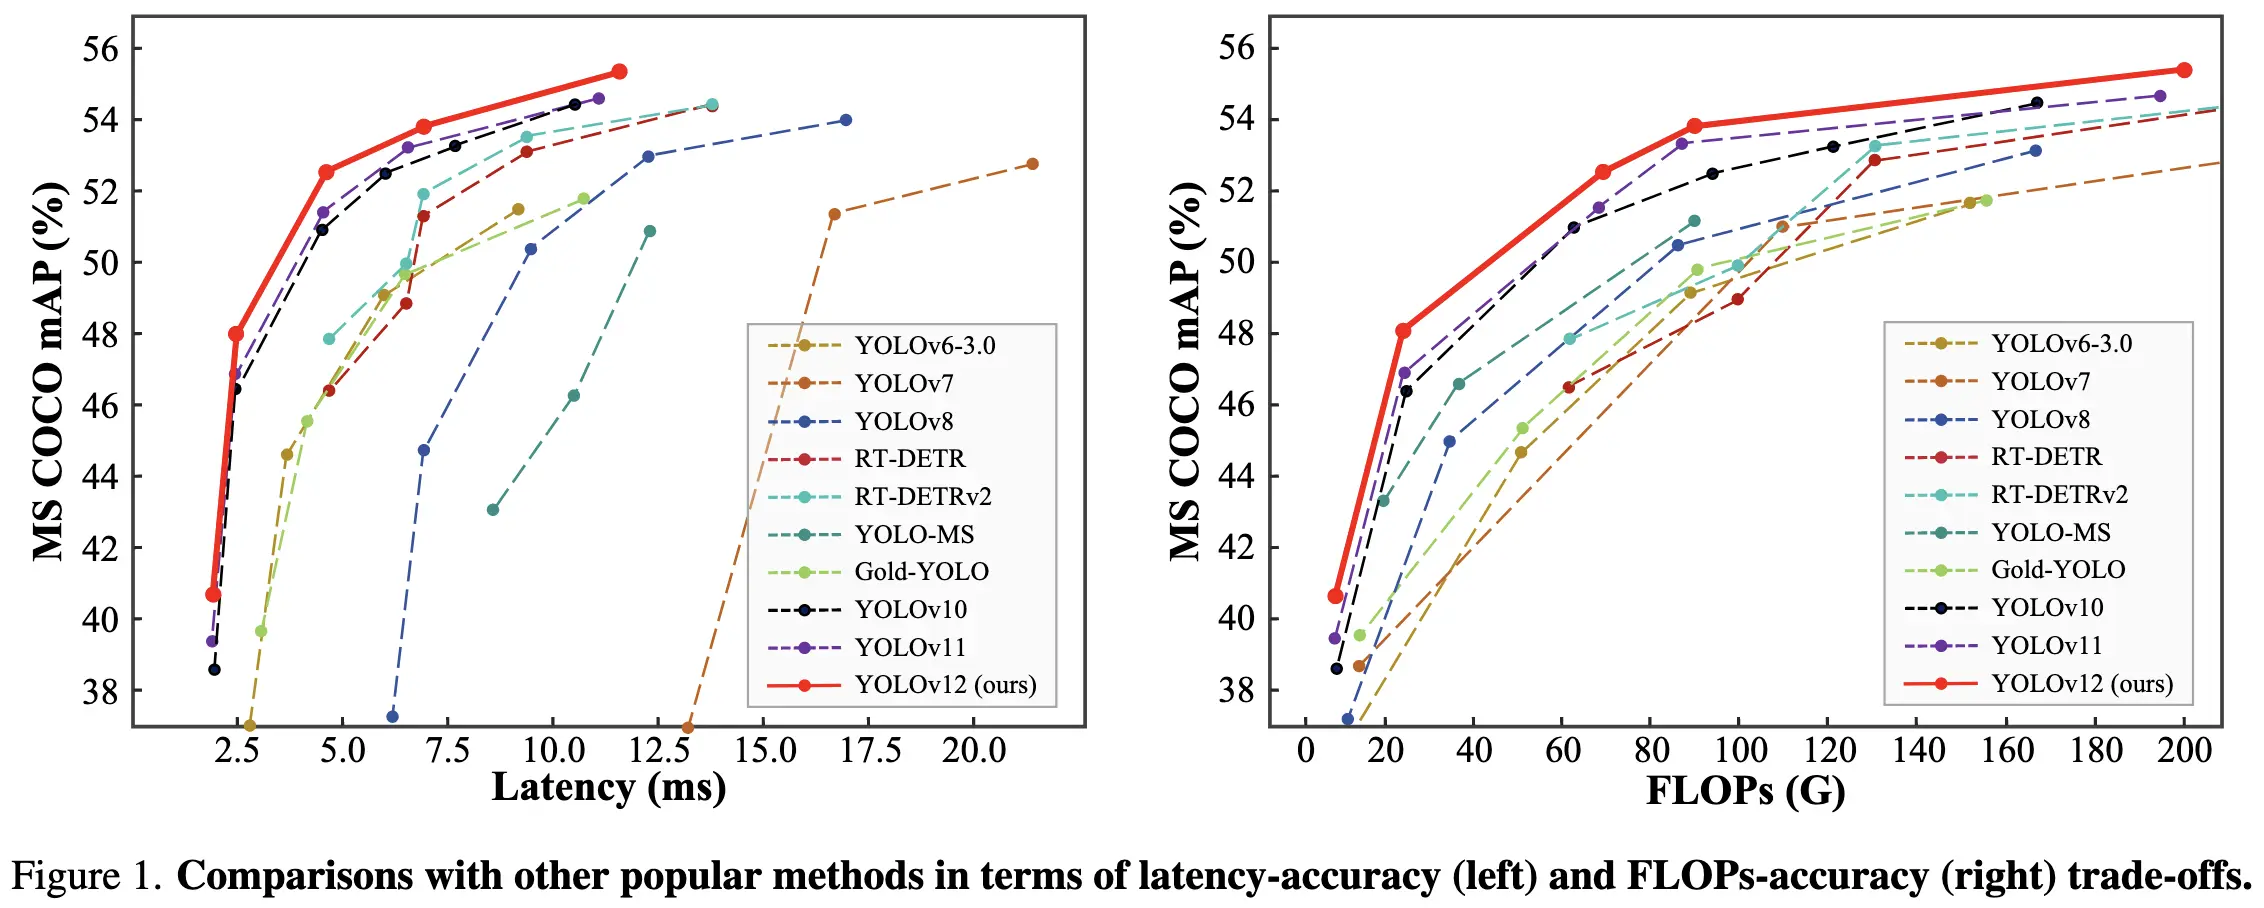
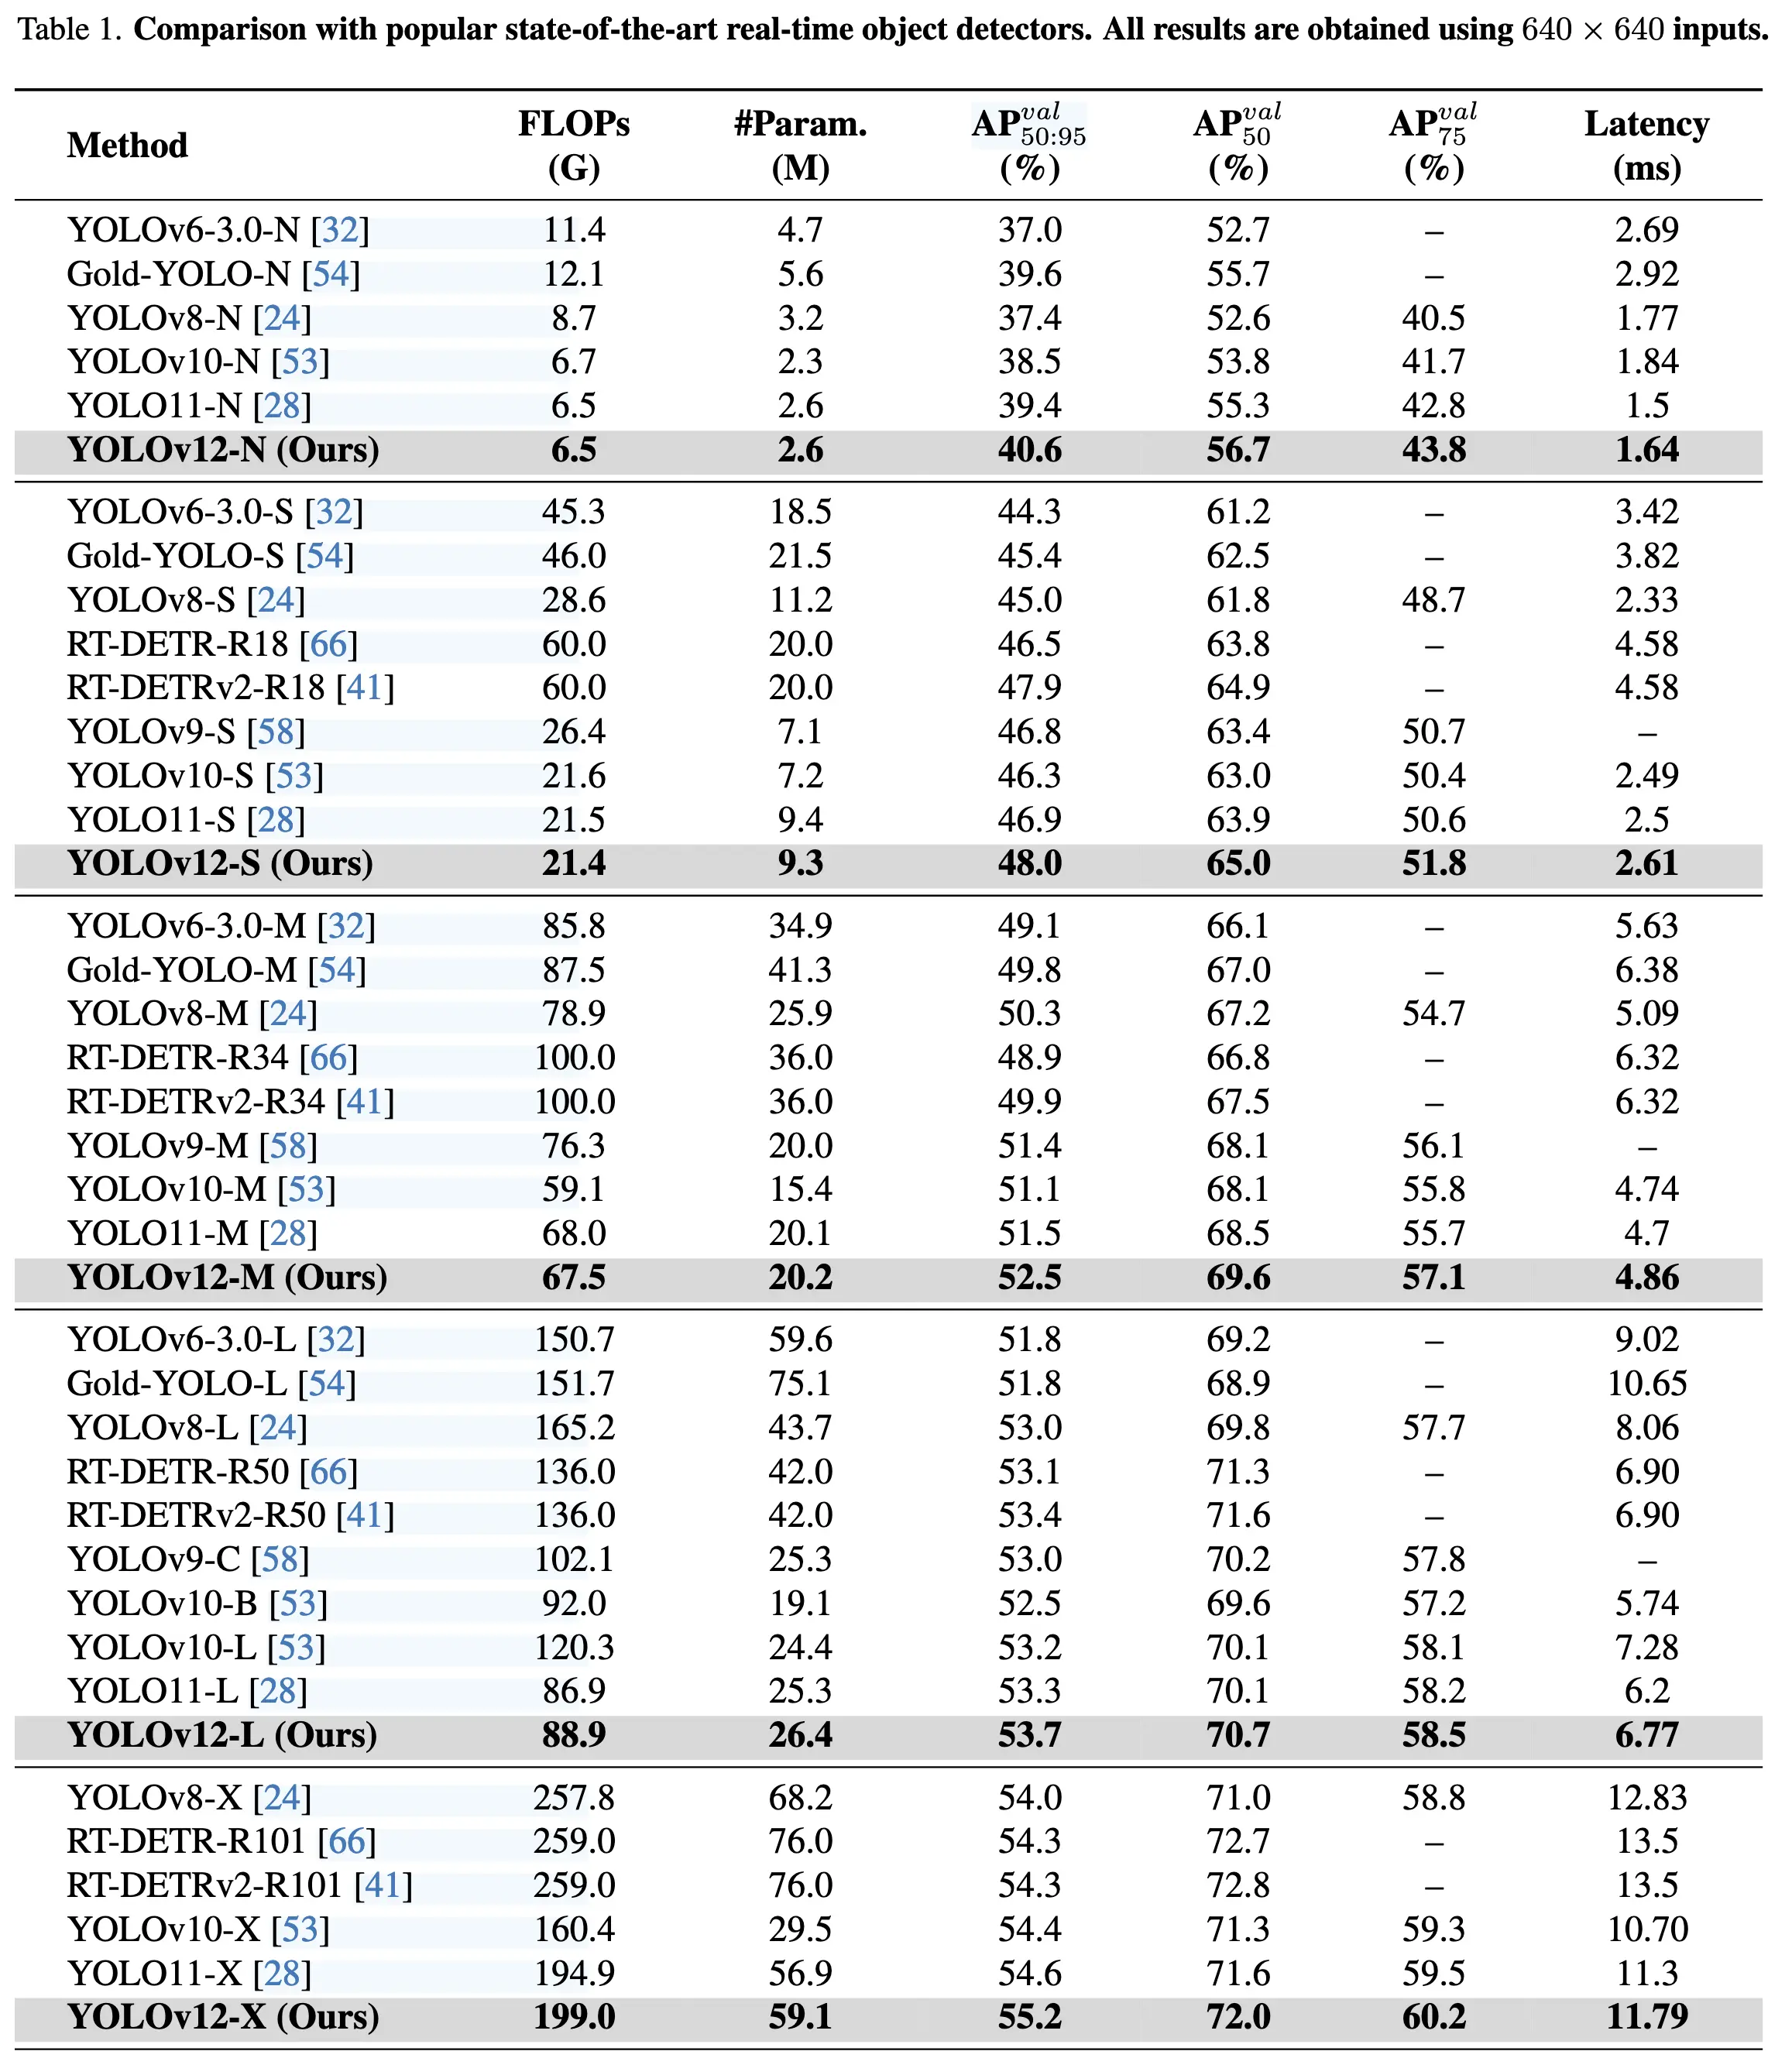
YOLOv12 surpasses all popular real-time object detectors in accuracy with competitive speed. For example, YOLOv12-N achieves 40.6% mAP with an inference latency of 1.64 ms on a T4 GPU, outperforming advanced YOLOv10-N / YOLOv11-N by 2.1%/1.2% mAP with a comparable speed. This advantage extends to other model scales. YOLOv12 also surpasses end-to-end real-time detectors that improve DETR, such as RT-DETR / RTDETRv2: YOLOv12-S beats RT-DETR-R18 / RT-DETRv2R18 while running 42% faster, using only 36% of the computation and 45% of the parameters.
Methods
效率分析
注意力机制虽然在捕捉全局依赖关系和促进自然语言处理与计算机视觉等任务方面非常有效,但其本质上比 CNN 慢。
复杂性
首先,自注意力操作的计算复杂度随输入序列长度呈二次方增长。具体来说,对于长度为、特征维度为的输入序列,注意力矩阵的计算需要次操作,因为每个标记都需要关注其他所有标记。相比之下,CNN中卷积操作的复杂度在空间或时间维度上是线性的,即,其中是卷积核大小,通常远小于。因此,自注意力在计算上变得不可行,特别是对于高分辨率图像或长序列等大规模输入。
此外,另一个重要因素是,大多数基于注意力的视觉 Transformer 由于其复杂的设计(例如 Swin Transformer 中的窗口划分/反转)和额外模块的引入(例如位置编码),逐渐累积了速度开销,导致整体速度比 CNN 架构更慢。在本文中,设计模块采用简单且干净的操作来实现注意力,最大限度地确保效率。
计算
其次,在注意力计算过程中,内存访问模式相比CNN效率较低。具体来说,在自注意力过程中,中间映射(如注意力映射和 Softmax 映射)需要从高速 GPU SRAM(实际计算位置)存储到高带宽 GPU 内存(HBM),并在计算过程中重新读取,而前者的读写速度是后者的 10 倍以上,从而导致显著的内存访问开销和实际运行时间增加。此外,与 CNN 相比,注意力中的不规则内存访问模式进一步引入了延迟,而 CNN 利用结构化和局部化的内存访问。CNN 受益于空间受限的卷积核,由于其固定的感受野和滑动窗口操作,能够实现高效的内存缓存和减少延迟。
这两个因素——二次计算复杂性和低效的内存访问——共同导致注意力机制比 CNN 更慢,特别是在实时或资源受限的场景中。解决这些限制已成为一个关键的研究领域,例如稀疏注意力机制和内存高效近似(如 Linformer 或 Performer)等方法旨在缓解二次方扩展问题。
区域注意力
降低原始注意力计算成本的一种简单方法是使用线性注意力机制,它将原始注意力的复杂度从二次方降低到线性。对于一个维度为的视觉特征,其中是 token 数量,是头数,是头大小,线性注意力将复杂度从降低到,由于,计算成本得以减少。然而,线性注意力存在全局依赖退化、不稳定性和分布敏感性等问题。此外,由于低秩瓶颈,在输入分辨率为的 YOLO 中应用时,其速度优势有限。
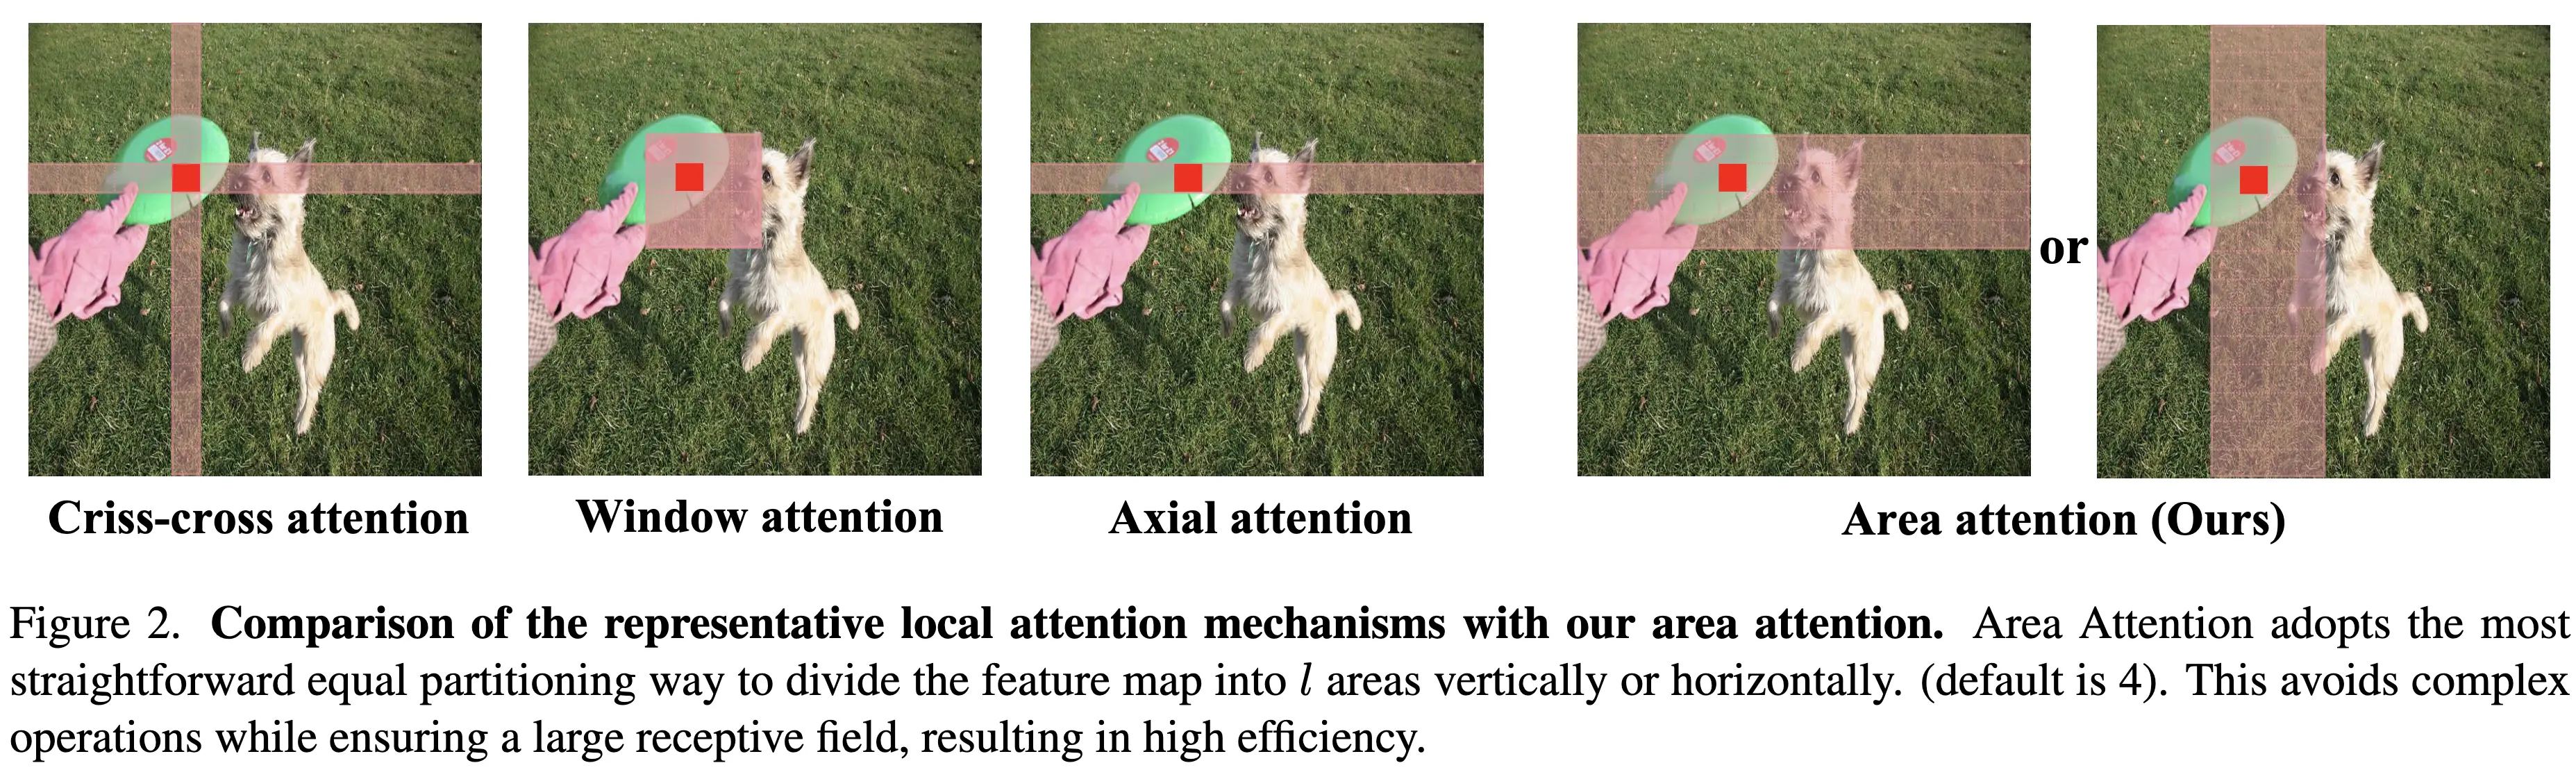
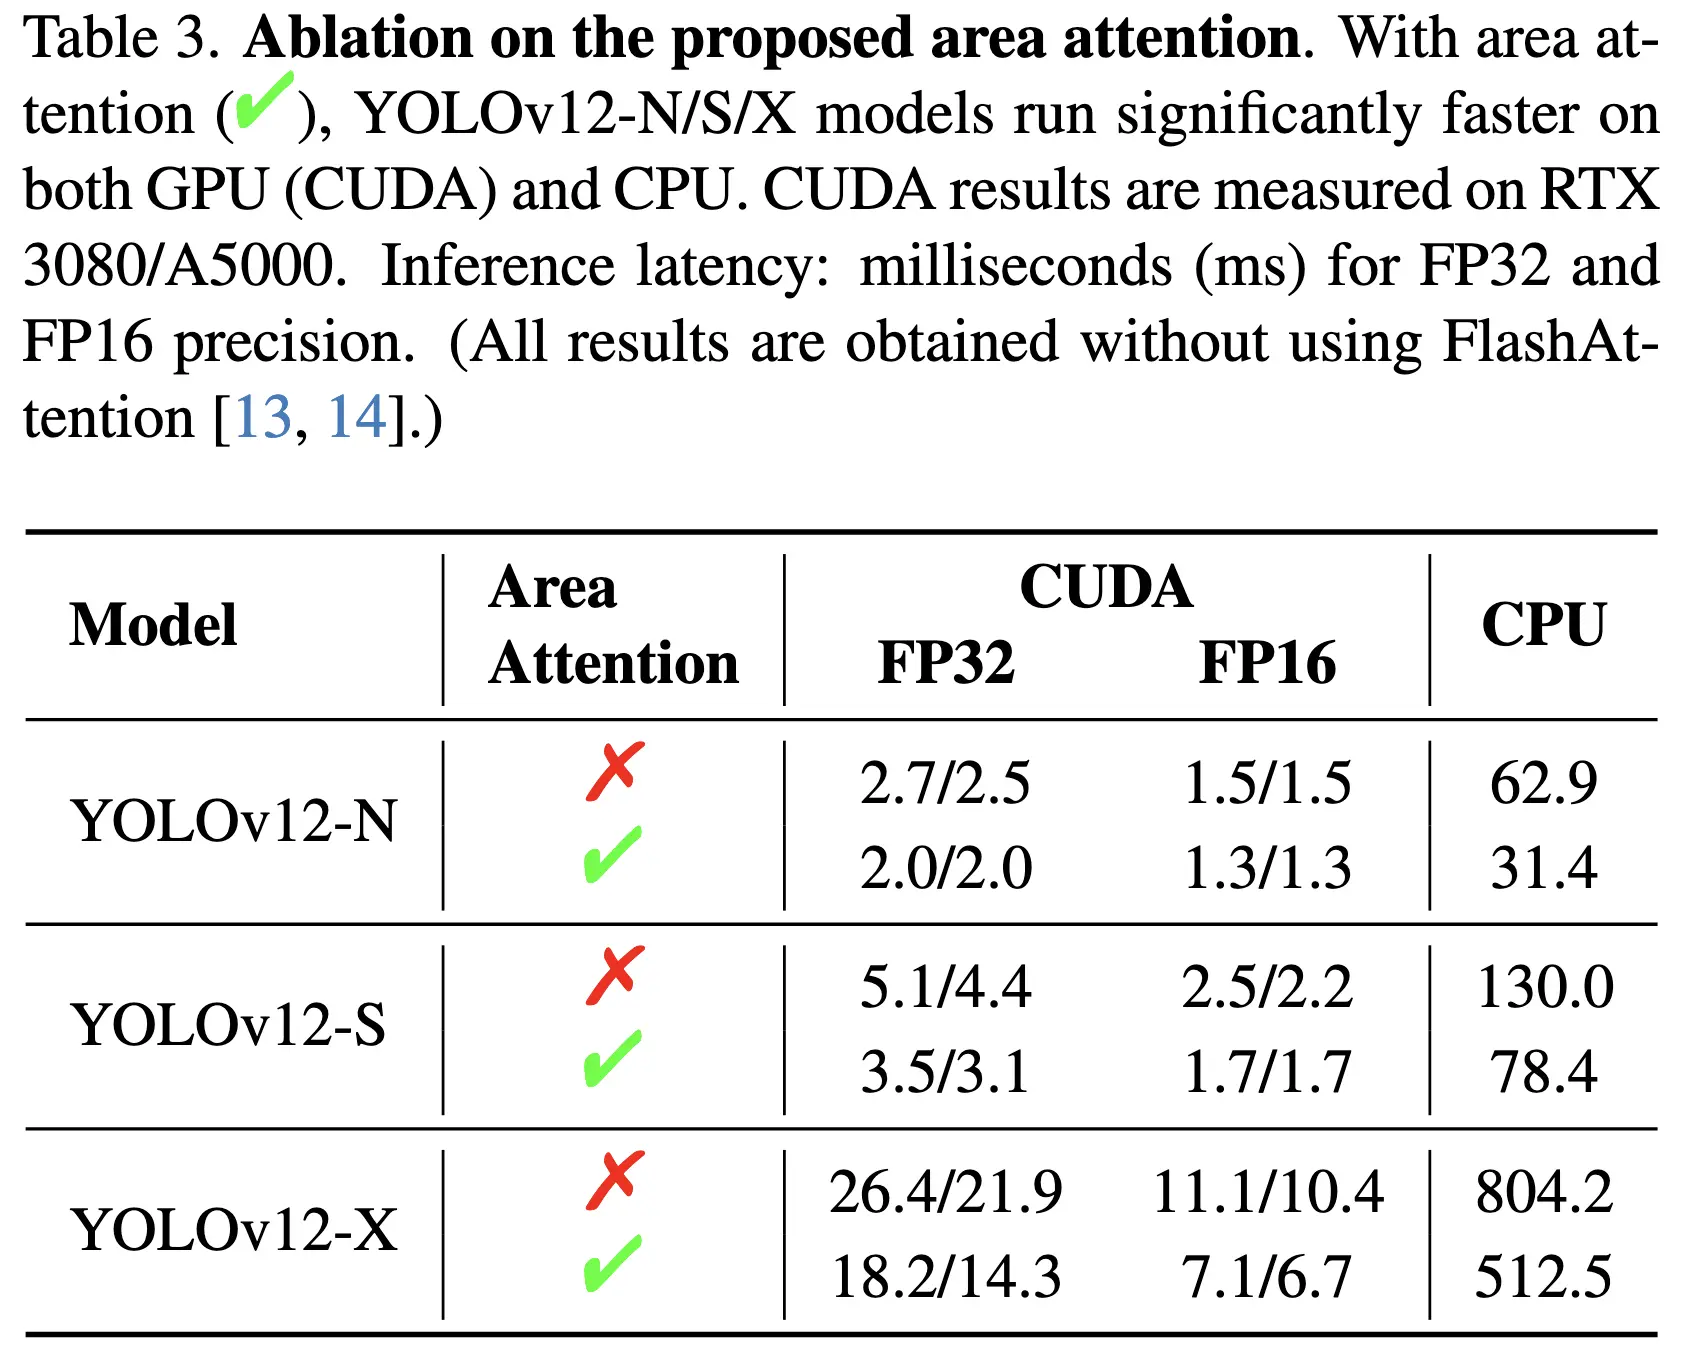
另一种有效降低复杂性的方法是局部注意力机制(例如 Shift window、交叉注意力和轴向注意力),如图 2 所示,它将全局注意力转化为局部注意力,从而降低计算成本。然而,将特征图划分为窗口可能会引入开销或减少感受野,影响速度和准确性。在本研究中,我们提出了一种简单而高效的区域注意力模块。如图 2 所示,分辨率为的特征图被划分为个大小为或的片段。这种方法消除了显式的窗口划分,仅需简单的重塑操作,从而实现了更快的速度。我们通过实验将的默认值设为 4,将感受野减少到原来的,但仍保持了较大的感受野。通过这种方法,注意力机制的计算成本从降低到。我们表明,尽管复杂度为,但当固定为 640 时(如果输入分辨率增加,也会增加),这仍然足够高效以满足YOLO系统的实时需求。有趣的是,我们发现这种修改对性能的影响很小,但显著提高了速度。
残差高效层聚合网络
高效层聚合网络(ELAN)旨在改进特征聚合。如图 3(b) 所示,ELAN 将过渡层(1×1卷积)的输出分割,通过多个模块处理其中一个分割部分,然后将所有输出拼接并应用另一个过渡层(1×1卷积)以对齐维度。然而,这种架构可能会引入不稳定性。我们认为,这种设计会导致梯度阻塞,并且缺乏从输入到输出的残差连接。此外,我们围绕注意力机制构建网络,这带来了额外的优化挑战。实验表明,即使使用 Adam 或 AdamW 优化器,L 尺度和 X 尺度模型要么无法收敛,要么仍然不稳定。
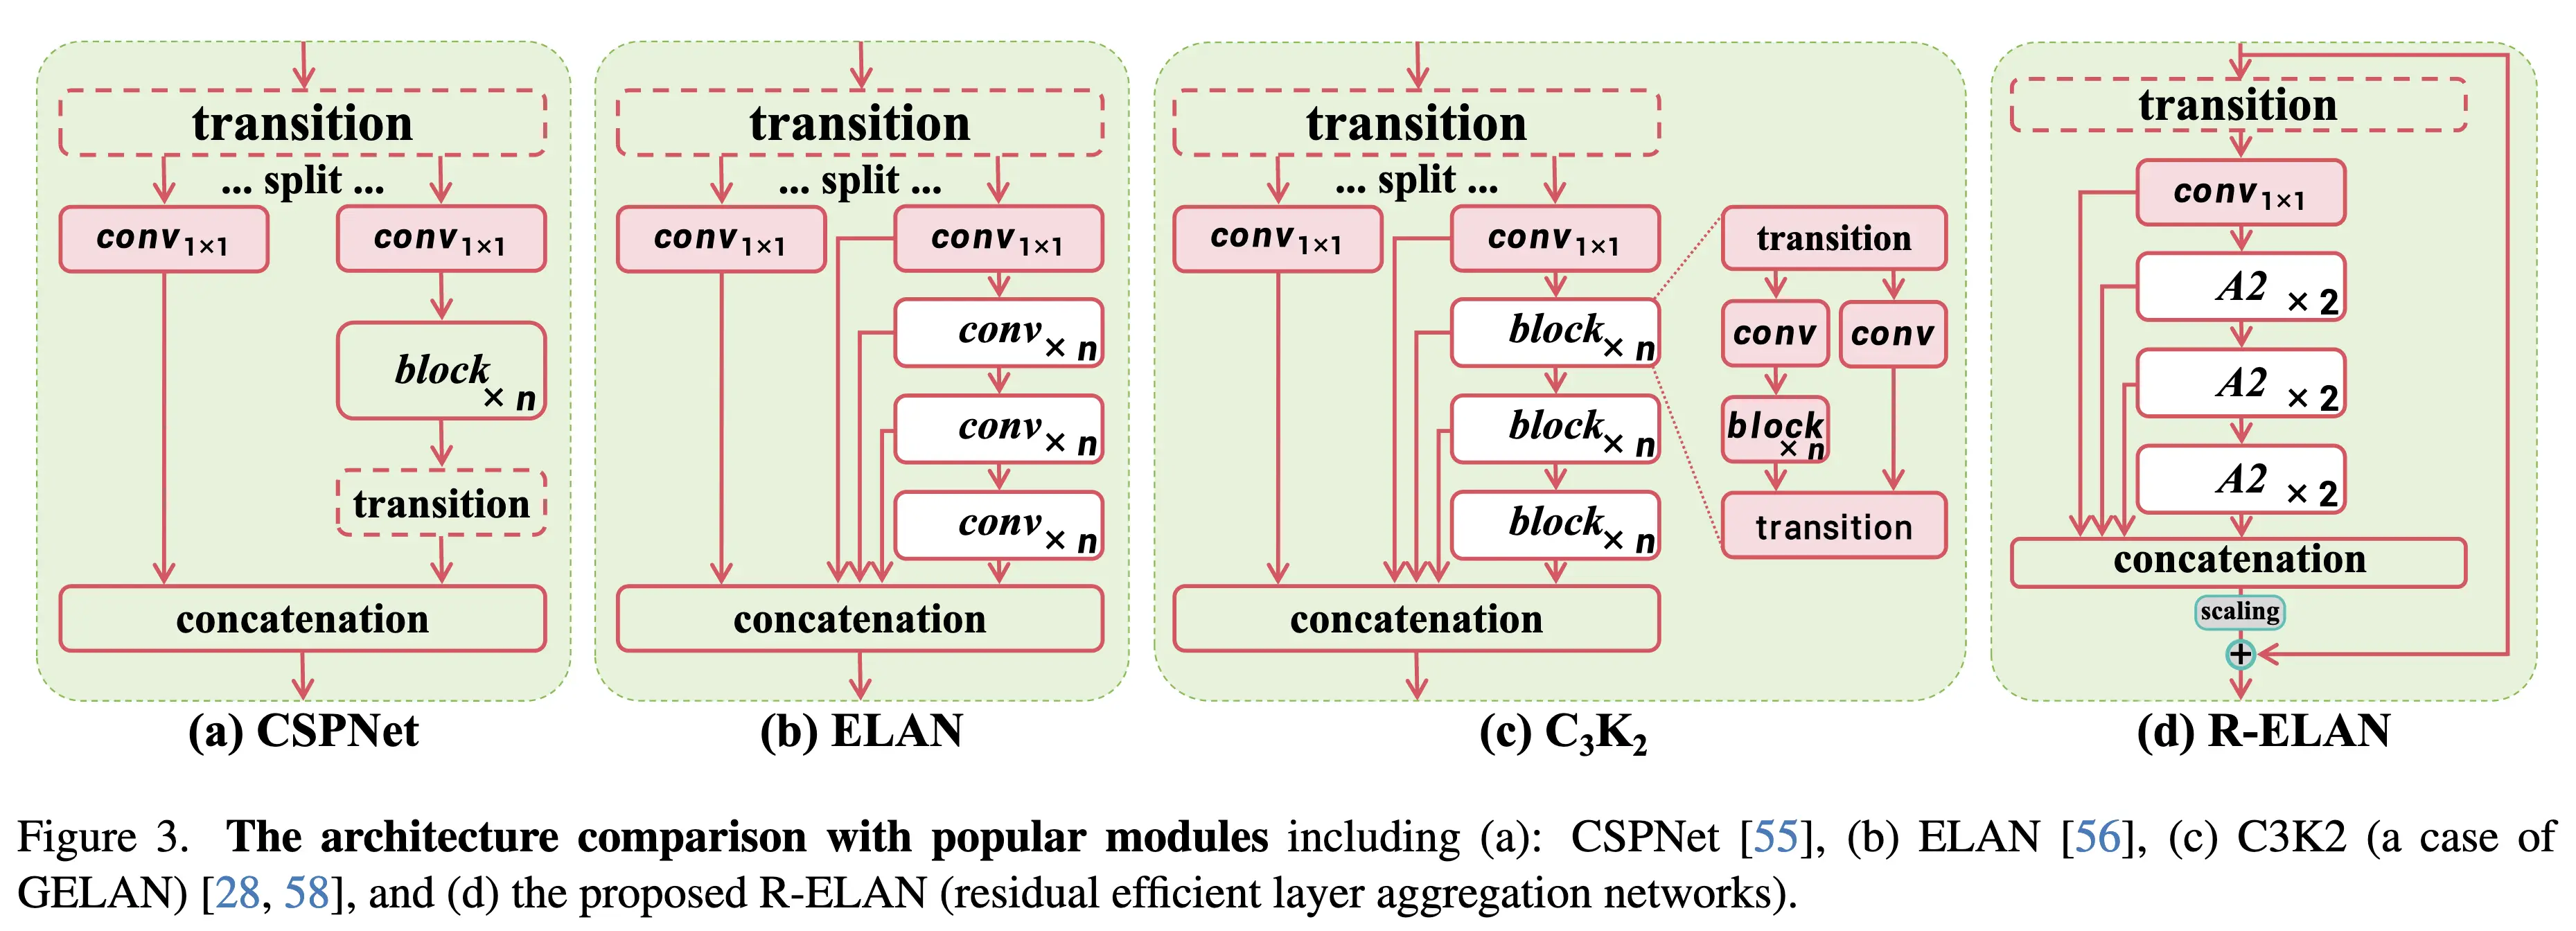
为了解决这个问题,我们提出了残差高效层聚合网络(R-ELAN),如图 3(d) 所示。相比之下,我们在整个块中引入了从输入到输出的残差连接,并带有缩放因子(默认值为0.01)。这种设计与层缩放类似,后者用于构建深层 ViT。然而,对每个区域注意力应用层缩放并不能解决优化挑战,并且会引入延迟。这表明,注意力机制的引入并不是收敛问题的唯一原因,ELAN 架构本身也存在问题,这验证了我们 R-ELAN 设计的合理性。
我们还设计了一种新的聚合方法,如图 3(d) 所示。原始的ELAN层通过首先将模块的输入传递到过渡层来处理,然后将其分割为两部分。一部分通过后续块进一步处理,最后将两部分拼接以生成输出。相比之下,我们的设计应用过渡层来调整通道维度并生成单一特征图。然后,该特征图通过后续块处理并进行拼接,形成 Bottleneck 结构。这种方法不仅保留了原始的特征整合能力,还减少了计算成本和参数/内存使用量。
架构改进 许多以注意力为核心的 ViT 采用平面式架构设计,而我们保留了先前 YOLO 系统的分层设计,并将证明这种设计的必要性。我们移除了在骨干网络最后阶段堆叠三个块的设计,这种设计出现在最近的版本中。相反,我们仅保留一个 R-ELAN 块,减少了总块数并有助于优化。我们从 YOLOv11 继承了骨干网络的前两个阶段,并未使用提出的 R-ELAN。
此外,我们修改了原始注意力机制中的一些默认配置,以更好地适应 YOLO。这些修改包括将 MLP 比率从 4 调整为 1.2(对于 N-/S-/M 尺度模型为 2),以更好地分配计算资源以获得更好的性能;采用 nn.Conv2d + BN 代替 nn.Linear+LN,以充分利用卷积算子的效率;移除位置编码;并引入大尺寸可分离卷积(7×7)(称为位置感知器)以帮助区域注意力感知位置信息。
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# YOLO12 object detection model with P3/8 - P5/32 outputs
# Model docs: https://docs.ultralytics.com/models/yolo12
# Task docs: https://docs.ultralytics.com/tasks/detect

# Parameters
nc: 80 # number of classes
scales: # model compound scaling constants, i.e. 'model=yolo12n.yaml' will call yolo12.yaml with scale 'n'
  # [depth, width, max_channels]
  n: [0.50, 0.25, 1024] # summary: 272 layers, 2,602,288 parameters, 2,602,272 gradients, 6.7 GFLOPs
  s: [0.50, 0.50, 1024] # summary: 272 layers, 9,284,096 parameters, 9,284,080 gradients, 21.7 GFLOPs
  m: [0.50, 1.00, 512] # summary: 292 layers, 20,199,168 parameters, 20,199,152 gradients, 68.1 GFLOPs
  l: [1.00, 1.00, 512] # summary: 488 layers, 26,450,784 parameters, 26,450,768 gradients, 89.7 GFLOPs
  x: [1.00, 1.50, 512] # summary: 488 layers, 59,210,784 parameters, 59,210,768 gradients, 200.3 GFLOPs

# YOLO12 backbone
backbone:
  # [from, repeats, module, args]
  - [-1, 1, Conv, [64, 3, 2]] # 0-P1/2
  - [-1, 1, Conv, [128, 3, 2]] # 1-P2/4
  - [-1, 2, C3k2, [256, False, 0.25]]
  - [-1, 1, Conv, [256, 3, 2]] # 3-P3/8
  - [-1, 2, C3k2, [512, False, 0.25]]
  - [-1, 1, Conv, [512, 3, 2]] # 5-P4/16
  - [-1, 4, A2C2f, [512, True, 4]]
  - [-1, 1, Conv, [1024, 3, 2]] # 7-P5/32
  - [-1, 4, A2C2f, [1024, True, 1]] # 8

# YOLO12 head
head:
  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 6], 1, Concat, [1]] # cat backbone P4
  - [-1, 2, A2C2f, [512, False, -1]] # 11
  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 4], 1, Concat, [1]] # cat backbone P3
  - [-1, 2, A2C2f, [256, False, -1]] # 14
  - [-1, 1, Conv, [256, 3, 2]]
  - [[-1, 11], 1, Concat, [1]] # cat head P4
  - [-1, 2, A2C2f, [512, False, -1]] # 17
  - [-1, 1, Conv, [512, 3, 2]]
  - [[-1, 8], 1, Concat, [1]] # cat head P5
  - [-1, 2, C3k2, [1024, True]] # 20 (P5/32-large)
  - [[14, 17, 20], 1, Detect, [nc]] # Detect(P3, P4, P5)
实验
对比实验
消融实验
R-ELAN
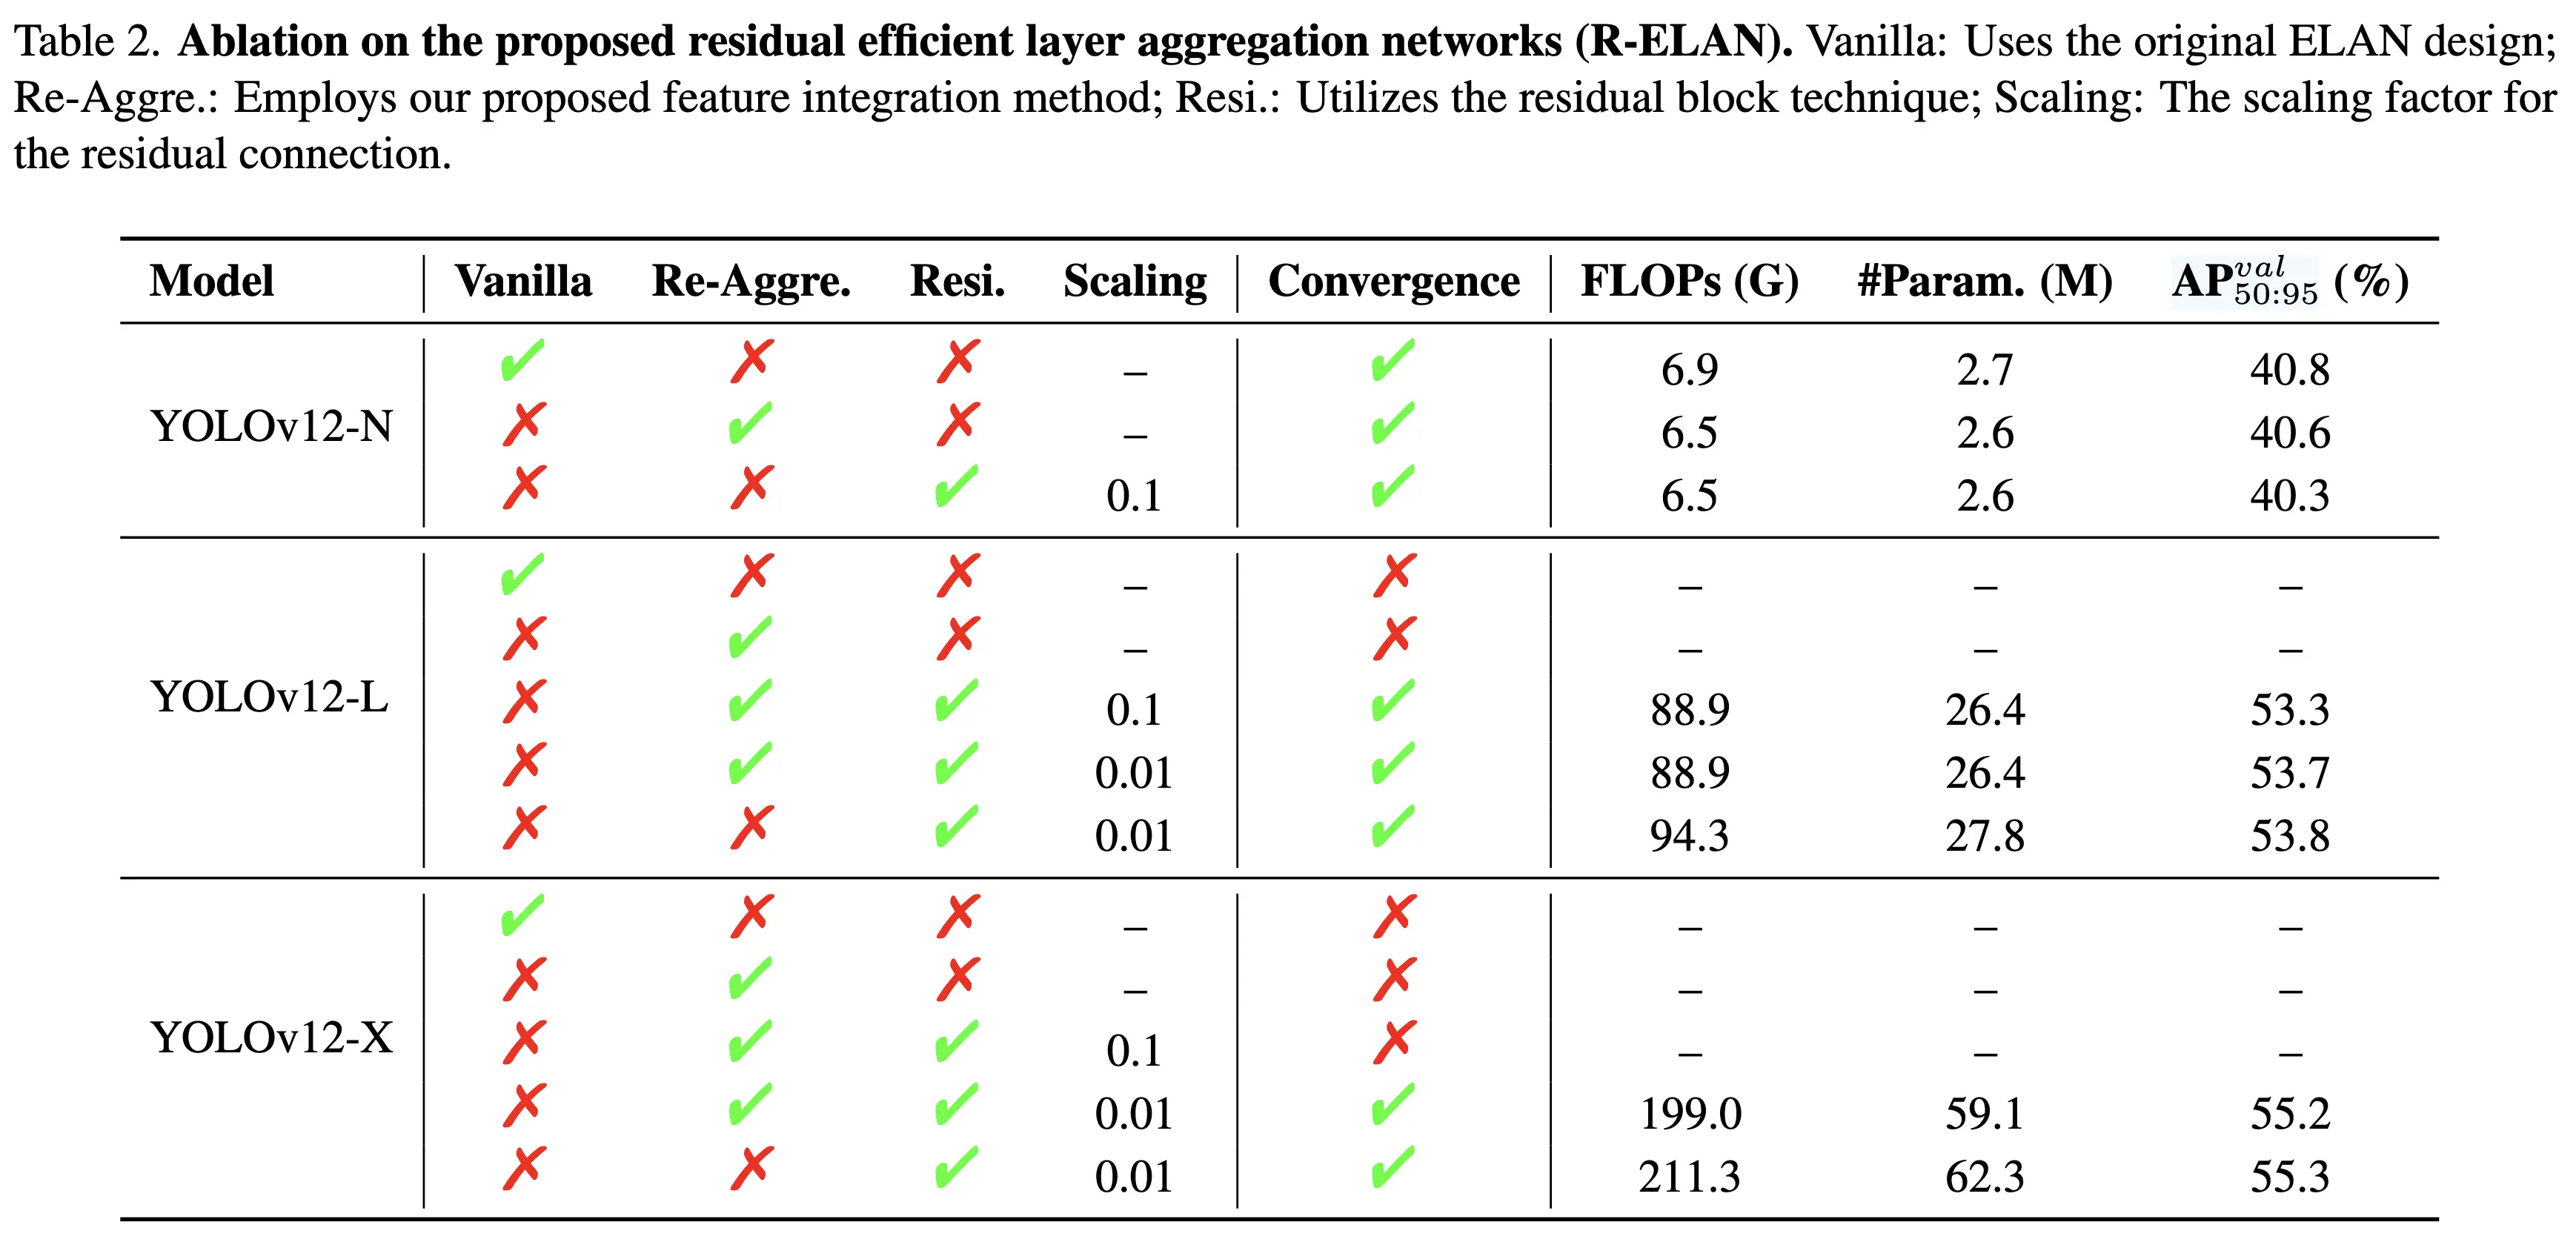
- 对于像 YOLOv12-N 这样的小模型,残差连接不会影响收敛,但会降低性能。相比之下,对于较大的模型(如YOLOv12-L/X),残差连接对于稳定训练至关重要。特别是,YOLOv12-X 需要一个最小的缩放因子(0.01)来确保收敛。
- 所提出的特征整合方法有效降低了模型的 FLOPs 和参数复杂度,同时仅以微小的性能下降保持了可比的表现。
区域注意力
可视化