SST: Self-training with self-adaptive thresholding for semi-supervised learning
Abstract
得益于丰富的高质量标注数据,神经网络在监督学习中展现出卓越的性能。然而,在实际场景中获取此类数据成本高昂且耗时费力。半监督学习 (SSL) 通过利用少量标注数据和大量未标注数据,为这一问题提供了解决方案。近期研究,例如 Semi-ViT 和 Noisy Student,采用了一致性正则化或伪标注,并取得了显著成果。然而,它们仍然面临挑战,尤其是在准确选择足够多的高质量伪标注方面,因为它们依赖于固定阈值。近期方法,例如 FlexMatch 和 FreeMatch,引入了灵活或自适应的阈值技术,极大地推动了 SSL 研究。然而,它们在每次迭代中更新阈值的过程被认为耗时、计算密集,并且可能没有必要。为了解决这些问题,我们提出了一种新颖、有效且高效的 SSL 框架——基于自适应阈值的自训练 (SST)。 SST 融合了监督学习(Super-SST)和半监督学习(Semi-SST)。SST 引入了一种创新的自适应阈值 (SAT) 机制,可根据模型的学习进度自适应地调整特定类别的阈值。SAT 确保选择高质量的伪标记数据,从而降低伪标记不准确和确认偏差(模型在训练过程中强化自身错误)的风险。具体而言,SAT 可以防止模型过早地合并低置信度的伪标记,从而减少错误强化并提升模型性能。 大量实验表明,SST 实现了当前最佳性能,并在各种架构和数据集上展现出卓越的效率、泛化能力和可扩展性。值得注意的是,Semi-SST-ViT-Huge 在竞争性 ImageNet-1K SSL 基准测试(无外部数据)上取得了最佳结果,仅使用 1%/10% 的标记数据,Top-1 准确率就达到了 80.7%/84.9%。与使用 100% 标记数据实现 84.8% Top-1 准确率的全监督 DeiT-III-ViTHuge 相比,我们的方法仅使用 10% 的标记数据就展现出卓越的性能。这意味着人工标注成本降低了十倍,显著缩小了半监督和全监督方法之间的性能差距。这些进步为 SSL 的进一步创新以及获取标记数据具有挑战性或成本高昂的实际应用铺平了道路。
Introduction
得益于丰富的高质量标注数据,神经网络在各种监督学习任务中展现出卓越的性能。然而,在实际场景中获取充足的高质量标注数据既成本高昂又耗费人力。因此,如何从少量标注样本中进行学习并有效利用丰富的未标注数据已成为一项紧迫的挑战。半监督学习 (SSL) 通过利用少量标注数据和大量未标注数据,为这一问题提供了一种解决方案。
一致性正则化、伪标记和自训练是主要的 SSL 方法。一致性正则化能够使模型在各种扰动下对同一未标记样本产生一致的预测,从而提升模型性能。伪标签和自训练在 SSL 中密切相关。伪标签为未标记数据分配标签,而自训练则迭代地使用这些伪标签来增强模型性能。
近期的一些研究,例如 Semi-ViT,采用了一致性正则化、伪标签或自训练,并取得了显著的成果。然而,它们仍然面临挑战,尤其是在准确选择足够多的高质量伪标签方面,因为它们依赖于固定阈值。近期的一些方法,例如 FlexMatch 和 FreeMatch,引入了灵活或自适应的阈值技术,极大地推动了 SSL 研究。然而,它们在每次迭代时更新阈值的过程被认为耗时、计算密集,并且可能没有必要。此外,FlexMatch 和 FreeMatch 都是基于仍在训练中的模型来预测未标记数据并更新阈值,而不是基于高精度收敛的模型。在训练的早期阶段,使用性能较低的模型预测未标记数据不可避免地会引入更多不准确的伪标签,从而导致不准确性不断增加的反馈循环。这会在训练过程中放大并强化确认偏差,最终导致性能不佳。
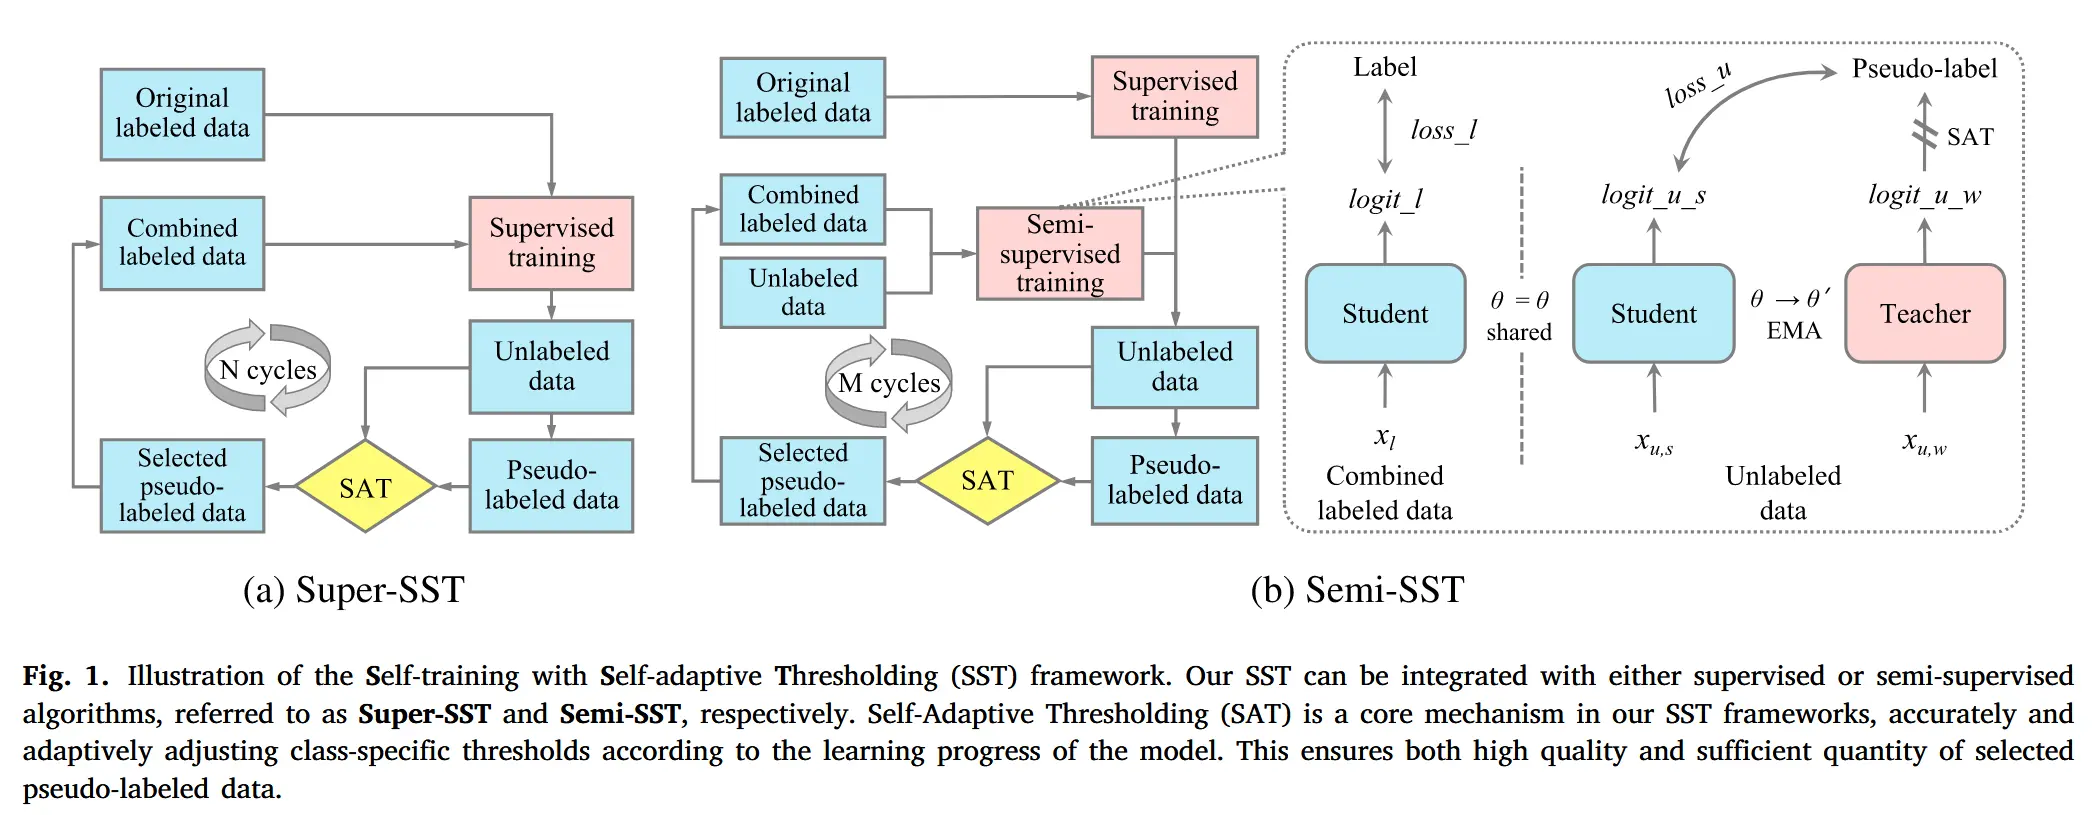
为了解决上述问题,我们提出了自适应阈值(SST)的自我训练,这是一个新颖,有效且有效的 SSL 框架,可显着发展 SSL 领域。如图 1 所示,我们的 SST 框架可以与监督或半监督算法集成。我们将监督训练和 SST 的组合称为 Super-SST,将半监督训练和 SST 组合为 Semi-SST。我们的 SST 引入了创新的自适应阈值(SAT)机制,该机制可以根据模型的学习进度准确和适应地调整特定于类的阈值。这种方法可确保高质量和足够数量的伪标记数据,从而减轻不准确的伪标签的风险和确认偏见,从而增强整体模型性能。
SAT 与现有的动态阈值方法(如 FlexMatch 和 FreeMatch)在三个关键方面有所不同:
- 阈值推导:SAT 采用基于置信度的方法,应用截止值 C 来滤除每个类别的低置信度概率,然后对剩余概率取平均值,并按因子 S 缩放以得出特定于类别的阈值。与依赖于基于预测无标记样本数量和全局阈值的课程学习的 FlexMatch 不同,SAT 避免了此类依赖。与使用指数移动平均线 (EMA) 和全局阈值(不进行低置信度过滤)的 FreeMatch 不同,SAT 引入了截止机制,同时省去了 EMA 和全局阈值。
- 阈值更新:SAT 使用训练好的模型,每个训练周期更新一次阈值,并将更新限制为个位数。这显著降低了计算开销并减轻了确认偏差。相比之下,FlexMatch 和 FreeMatch 使用仍在训练中的模型,在每次迭代(例如超过 1,000,000 次更新)中更新阈值,这会产生大量的计算成本,并加剧早期训练中的确认偏差。
- 实证优势:大量的实证评估证明了 SAT 在多个基准测试中的优势。例如,在包含 400、2500 和 10000 个标签的 CIFAR-100 数据集上,FreeMatch 使用约 240 个 GPU 小时实现了 28.71% 的平均错误率。相比之下,基于 SAT 机制的 Super-SST 和 Semi-SST 分别实现了 22.74% 和 20.50% 的平均错误率,仅需 3 和 4 个 GPU 小时,速度分别提升 80 倍和 60 倍。
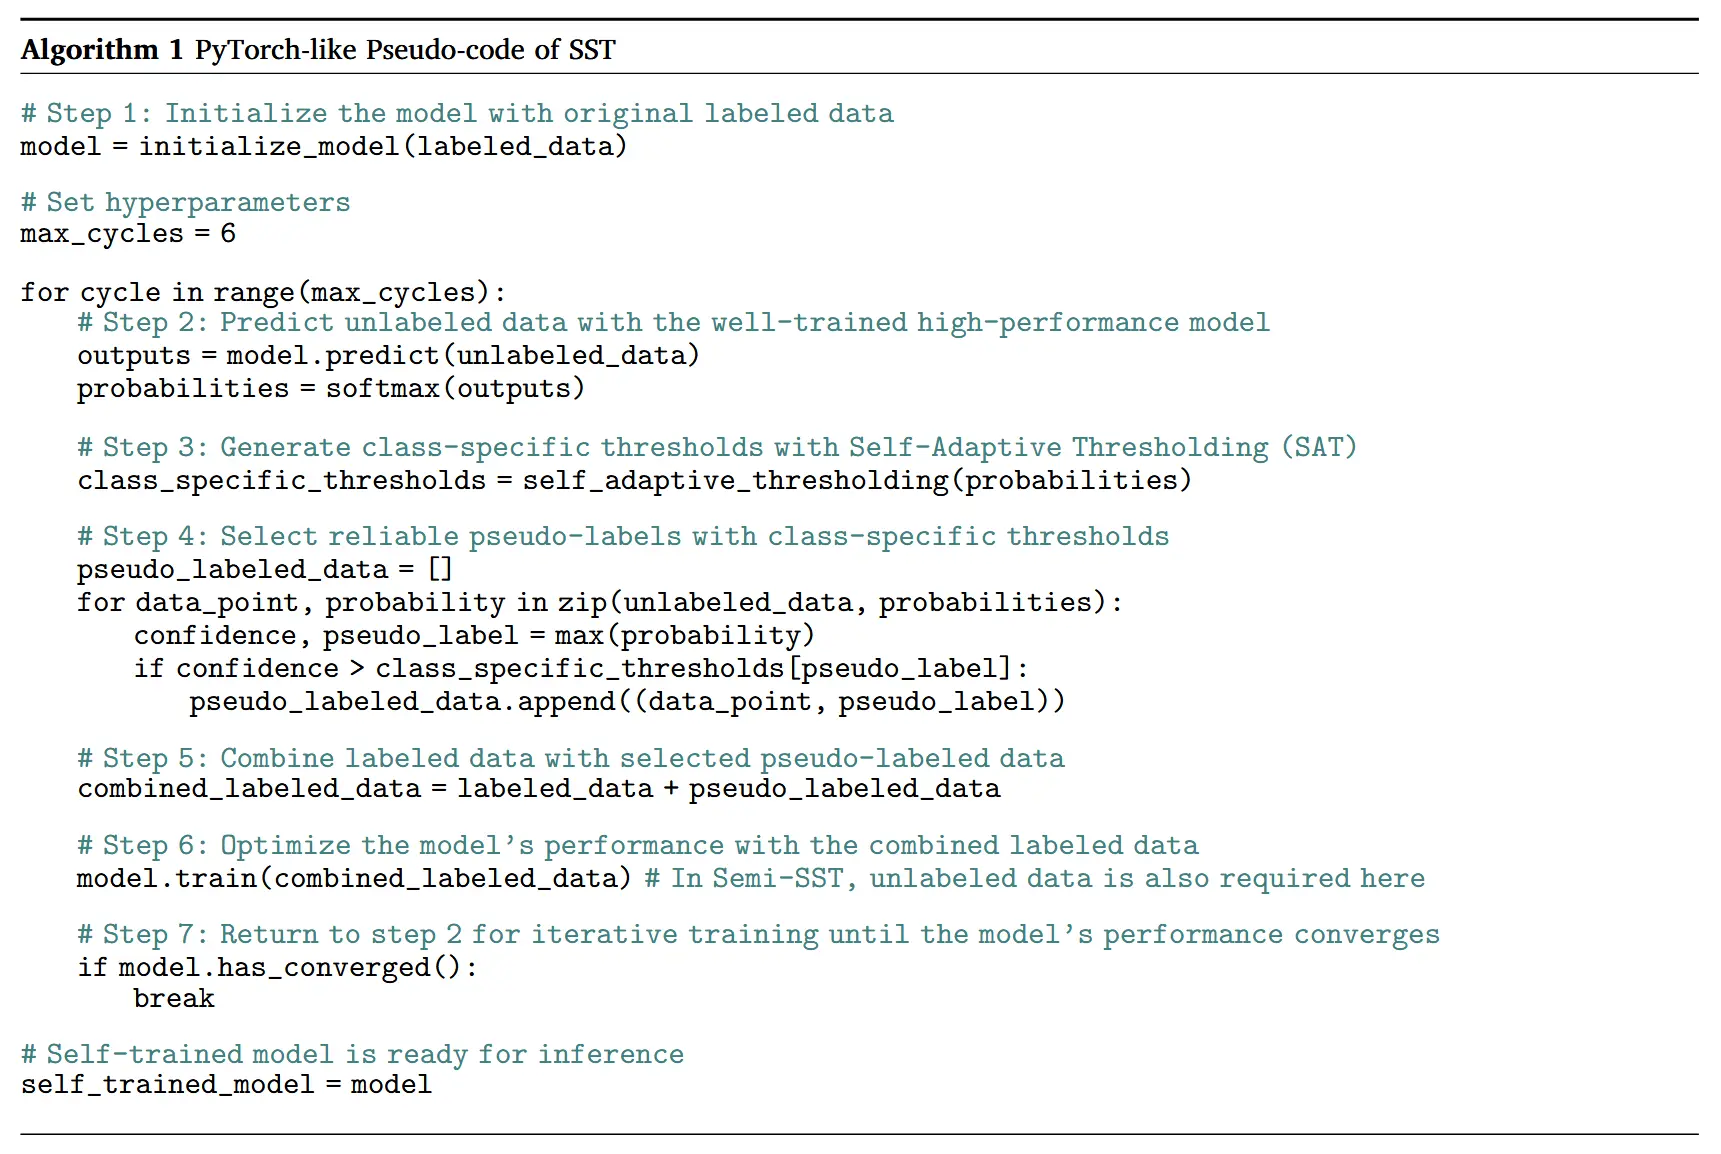
Super-SST 流程如图 1(a) 所示,包含以下几个步骤:(1)使用原始标记数据初始化模型。(2)利用训练好的高性能模型预测未标记数据。(3)应用自适应阈值 (SAT) 准确生成或调整类别特定阈值。(4)使用类别特定阈值选择高置信度和可靠的伪标签,减少不准确的伪标签并减轻确认偏差。(5)通过将原始标记数据与精心选择的伪标记数据合并并平等对待它们来扩展标记训练集。(6)使用组合后的标记数据优化模型性能。(7)通过返回步骤 2 进行迭代训练,在多个循环中不断完善模型,直到其性能收敛。
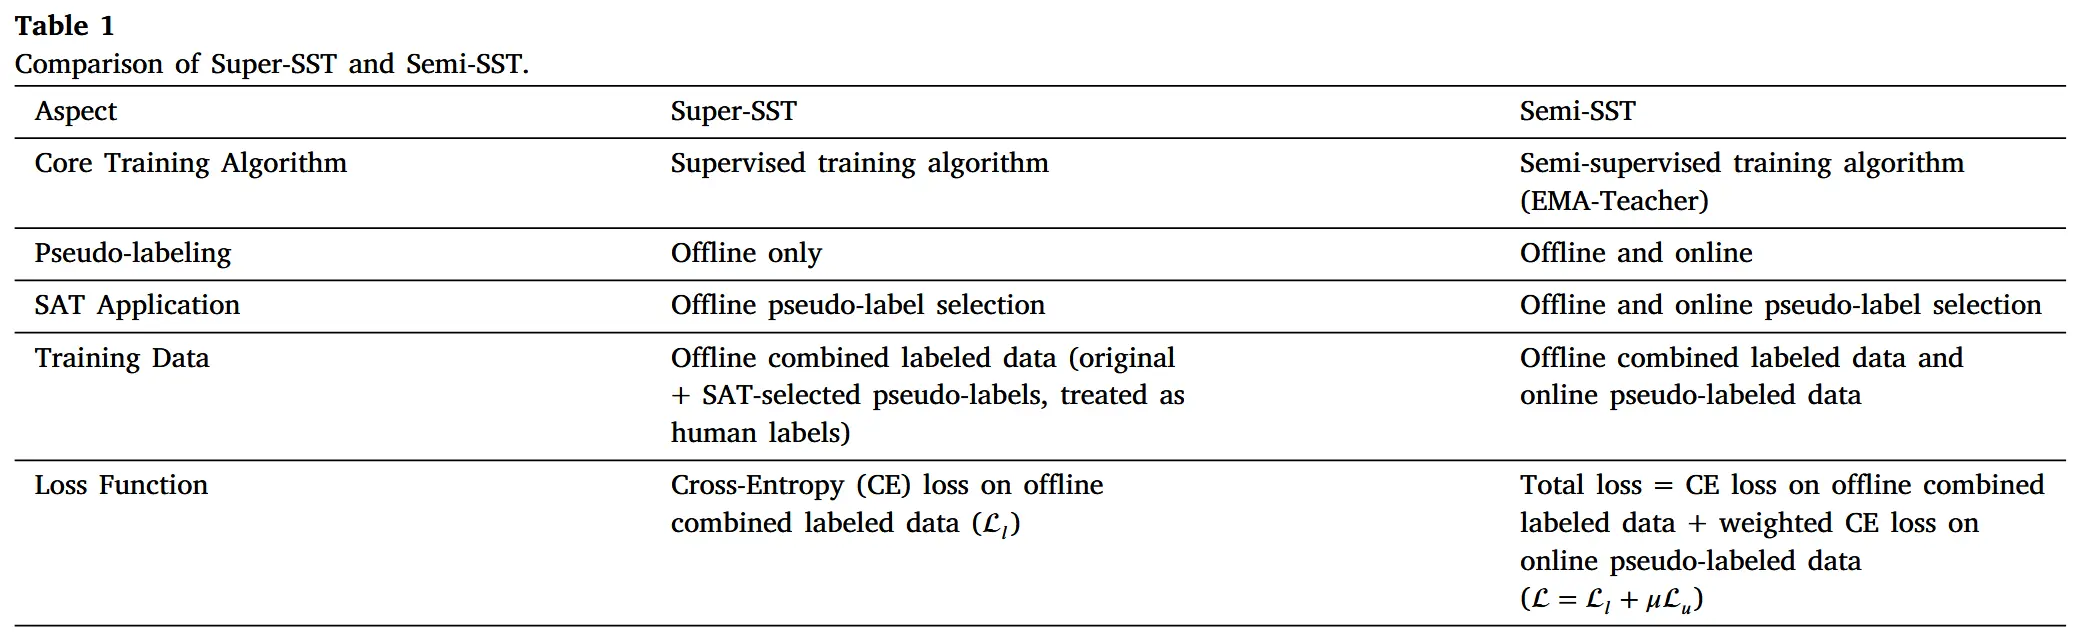
如图 1(b) 所示,Semi-SST 通过集成 EMA-Teacher 模型增强了 Super-SST 的离线伪标记流程,引入动态在线伪标记来补充离线流程。具体而言,在 EMA-Teacher 中,教师模型在线动态生成伪标记,而学生模型则使用离线组合标记数据和在线伪标记数据进行训练。因此,Semi-SST 同时采用了离线和在线伪标记机制,并在两种情况下都应用了 SAT 算法,以确保选择高置信度的伪标记。表 1 概述了 Super-SST 和 Semi-SST 的主要区别。
大量实验和结果强有力地证实了我们的方法在基于 CNN 和 Transformer 的架构以及各种数据集(包括 ImageNet-1K、CIFAR-100、Food-101 和 iNaturalist)上的有效性、效率、泛化性和可扩展性。与监督和半监督基准相比,我们的方法仅使用 1%(10%)的标记数据,Top-1 准确率就实现了 0.7%–20.7%(0.2%–12.1%)的相对提升。值得注意的是,Semi-SST-ViT-Huge 在竞争性 ImageNet-1K SSL 基准(无外部数据)上取得了最佳效果,仅使用 1%(10%)的标记数据,Top-1 准确率就达到了 80.7%(84.9%)。与全监督的 DeiT-III-ViT-Huge(使用 100% 标注数据实现 84.8% 的 Top-1 准确率)相比,我们的方法仅使用 10% 的标注数据就展现出卓越的性能。这意味着人工标注成本降低了十倍,显著缩小了半监督方法与全监督方法之间的性能差距。此外,我们的 SST 方法不仅实现了高性能,还展现出卓越的效率,从而带来了卓越的性价比。此外,在 ImageNet-1K 基准测试中,Super-SST 的准确率分别比 FlexMatch 和 FreeMatch 高出 6.27% 和 4.99%,且仅需 3 次阈值更新,而 FlexMatch 和 FreeMatch 则需要超过 1,000,000 次阈值更新。
总而言之,我们的贡献是三个方面:
- 我们提出了一种创新的自适应阈值自训练 (SST) 框架,以及它的两种变体:Super-SST 和 Semi-SST,显著推动了 SSL 领域的发展。
- SST 引入了一种新颖的自适应阈值 (SAT) 技术,可以根据模型的学习进度,精准地自适应调整特定类别的阈值。该机制确保了所选伪标签数据的质量和数量,从而降低了伪标签不准确和确认偏差的风险,从而提升了模型的整体性能。
- SST 在各种架构和数据集上都达到了 SOTA 水平,同时展现出卓越的效率,从而实现了卓越的性价比。此外,SST 显著降低了对人工标注的依赖,弥合了半监督学习和全监督学习之间的差距。
Research objectives
之前第一节讨论的 SSL 方法要么依赖于固定阈值,要么使用成本高昂且性能受限的动态阈值技术来选择伪标签。这两种方法都倾向于在训练初期引入更多噪声标签,从而形成反馈循环,增加不准确性并强化确认偏差,最终导致性能不佳。为了克服这些挑战,我们提出了 SST 框架及其核心组件 SAT 机制。这些创新旨在在训练过程中准确地选择高质量且充足的伪标签数据,最大限度地降低不准确性和确认偏差的风险,从而提升模型的整体性能。我们希望本文能够启发未来的研究,并为获取标记数据具有挑战性或成本高昂的实际应用提供经济高效的解决方案。
Methodology
图 1 提供了 SST 的直观概览,算法 1 则展示了其伪代码实现。该算法分为几个不同的步骤:
初始化
我们使用原始标记样本初始化模型参数。此初始化阶段采用标准交叉熵损失公式来优化模型的初始参数,确保后续训练阶段有一个强大的起始检查点。
预测
我们使用训练好的高性能模型来预测所有未标记数据,输出个类别的概率。
此步骤生成一个概率矩阵,其中表示未标记样本的数量,表示类别总数。该矩阵中的每个元素对应于样本属于特定类别的预测概率。
自适应阈值(SAT)
利用生成的概率矩阵,我们开始应用 SAT 机制。SAT 机制是 SST 框架的关键组成部分,旨在根据模型的学习进度,精准、自适应地调整特定于类别的阈值。SAT 机制包含几个子步骤。
排序
给定概率矩阵,其中表示第个未标记样本属于第个类的预测概率。我们将每个类的概率按降序排列。令表示类的概率向量。
截止过滤
对于每个类别,我们滤除低于预定截止值(例如 0.5)的概率,以确保只保留更高、更可靠的概率。令表示类别的过滤概率。
平均值计算
我们计算每个类的剩余概率的平均值:
是类过滤概率的数量。
阈值缩放
然后,我们将每个类的平均值乘以缩放因子以获得特定于类的阈值
SAT 机制确保较低、不太可靠的概率不会影响阈值计算,从而保持伪标记过程的可靠性和质量。
选择
我们使用类别特定的阈值来选择高置信度且可靠的伪标签,从而减少不准确伪标签的引入并减轻确认偏差。对于每个未标记样本,伪标签由及其对应的置信度生成。如果,则未标记样本被选为伪标记数据点。
组合
我们将标记数据与精心挑选的高置信度伪标记数据相结合,从而扩展标记训练集。
优化
在 Super-SST 框架中,模型使用标准 CE 损失函数在离线组合标注数据上进行优化。如第一节所述,组合标注数据中包含的高置信度伪标注数据通过 SAT 离线选择,并被视为与人工标注数据同等可靠。相比之下,Semi-SST 构建于 EMA-Teacher 框架之上,其中教师模型在训练过程中动态生成伪标签,学生模型则同时在离线组合标注数据和在线伪标注数据上进行训练。我们使用总损失函数来优化学生模型的性能,该函数由离线组合标注数据的 CE 损失函数和在线伪标注数据的 CE 损失函数组成,并由一个权重因子加权以控制的贡献。该公式确保模型能够同时受益于高置信度离线伪标注和动态在线伪标注,并在两种情况下都应用 SAT 滤波来保持伪标注的可靠性。
其中是指示函数,是类的阈值。
迭代训练
返回预测步骤进行迭代训练,在多个循环中不断优化模型,直到其性能收敛。
Experiments and results
数据集
- ImageNet-1K
- Food-101
- iNaturalist
- CIFAR-100
- CIFAR-10
- SVHN
- STL-10
- Clothing-1M
对比实验
略过
消融实验
图 2 探讨了不同的截止值和缩放因子对多个训练周期内 Top-1 准确率的影响。每个子图关注一个特定变量,同时保持另一个变量不变,以观察它们对性能的各自影响。所有实验均使用相同的起始检查点(即 ViT-Small)进行,该检查点在 1% ImageNet-1K 标记数据上进行监督微调,实现 60.3% 的 Top-1 准确率。我们在 ImageNet-1K 上将 ViT-Small 的设置为 0.5,设置为 0.8,将 ViT-Huge 的设置为 0.9。
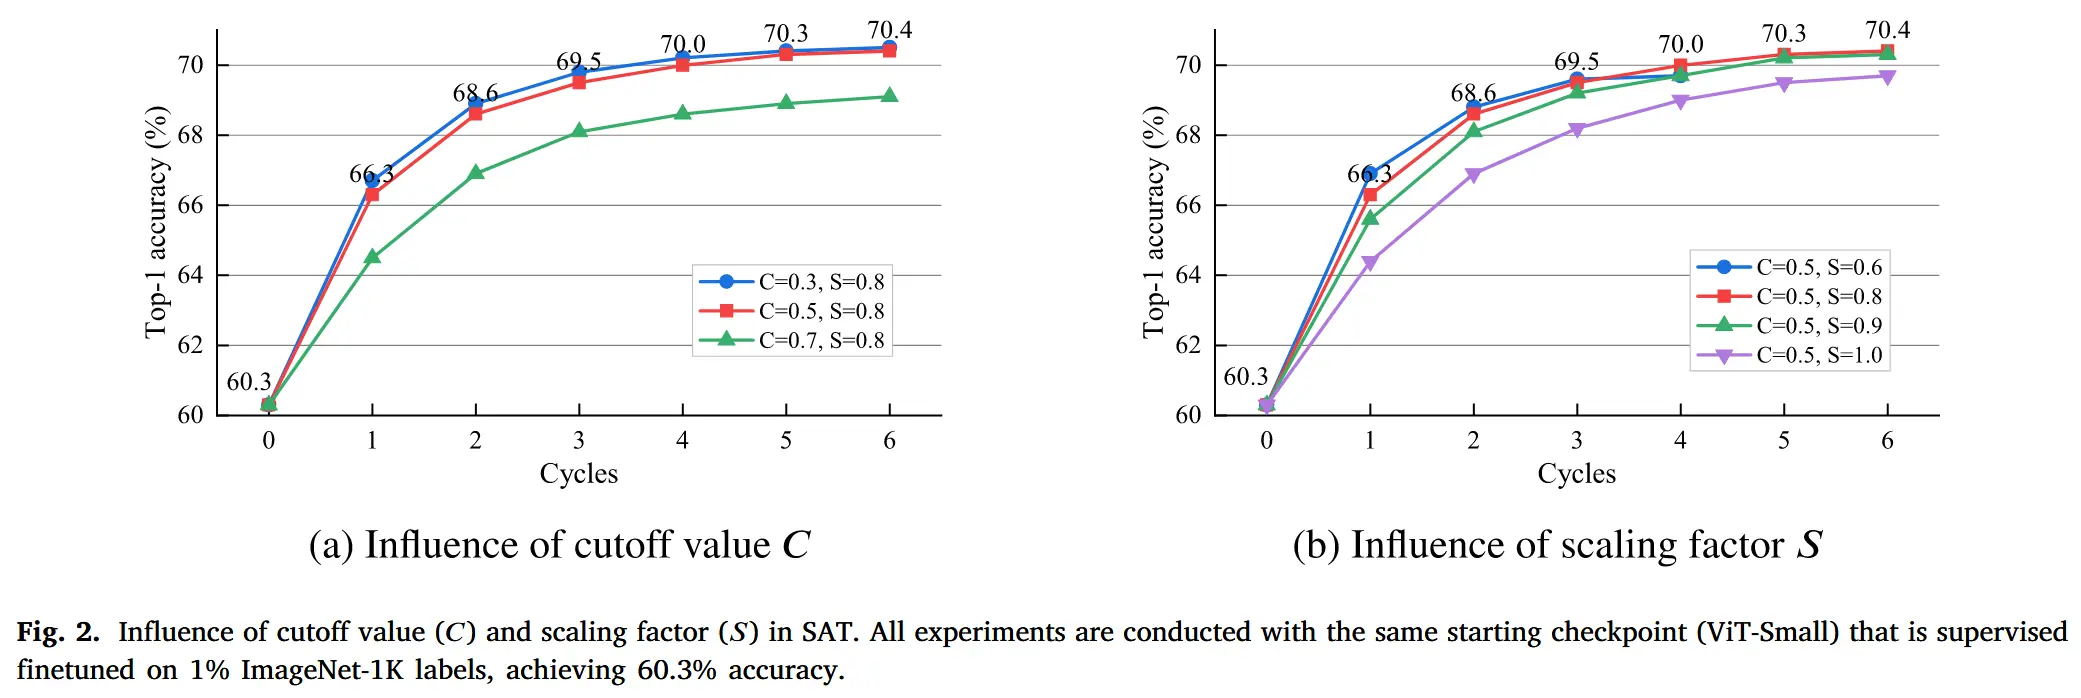
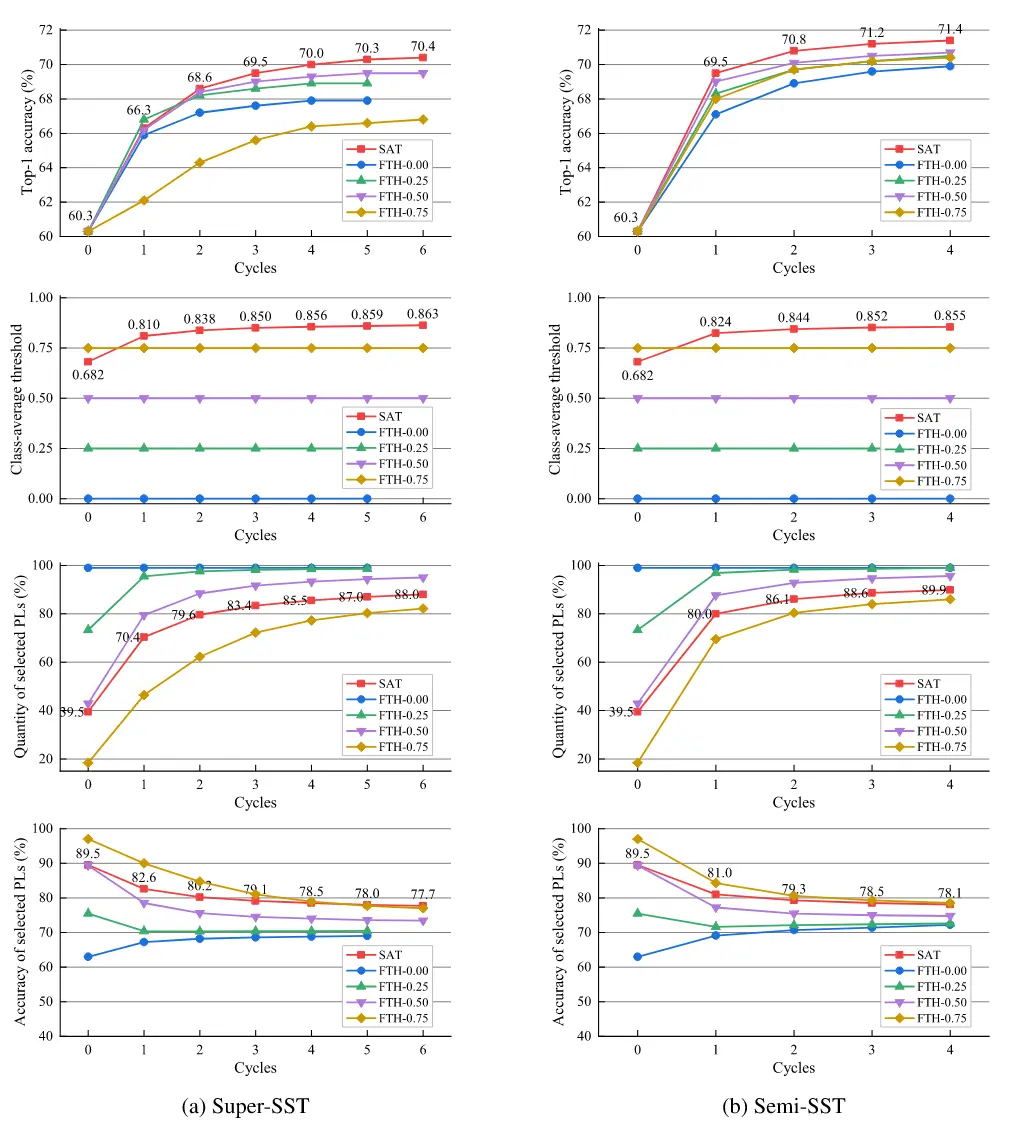
图 3 凸显了 SAT 在 Super-SST 和 Semi-SST 框架下均明显优于 FTH 方法。SAT 的动态阈值机制能够持续提升 Top-1 准确率,并有效平衡所选 PL 的高质量和充足数量,使其成为 SSL 任务的卓越选择。FTH 方法的静态特性意味着它们无法响应训练过程中不断变化的动态,导致 PL 选择要么过于保守,要么过于宽松,最终导致模型性能提升有限。
Limitation
尽管 Semi-SST 和 Super-SST 表现出了强劲的整体性能,但它们在极其有限的标记数据场景(例如,仅有 40 个标记样本的 SVHN)下表现出相对较高的错误率。这表明我们的方法在极低标记数据场景下可能面临挑战。这一局限性与 SSL 中更广泛的挑战相符,其中极端的标记稀缺性会放大对伪标记噪声和模型初始化的敏感性。未来的研究可以探索缓解此问题的策略。此外,我们的方法是专为计算机视觉任务设计的,目前尚未针对自然语言处理 (NLP) 基准进行配置。虽然在文本数据上的实验很有价值,但将我们的框架应用于 NLP 任务需要进行重大的架构修改。未来的研究可以探索如何将我们的方法推广到更广泛的模态,包括 NLP 和多模态学习。此外,虽然我们已经在 Clothing-1M (Xiao et al., 2015) 数据集上进行了实验并获得了相应的结果,但我们对噪声数据、类别不平衡和领域转移场景的研究仍然有限。由于计算资源的限制,我们对这些挑战的分析尚不全面。本研究的未来迭代将致力于系统地探索这些挑战,从而在更现实、更多样化的条件下对 SSL 的性能提供更深入的洞察。