Relation DETR: Exploring Explicit Position Relation Prior for Object Detection
Abstract
This paper presents a general scheme for enhancing the convergence and performance of DETR (DEtection TRansformer). We investigate the slow convergence problem in transformers from a new perspective, suggesting that it arises from the self-attention that introduces no structural bias over inputs. To address this issue, we explore incorporating position relation prior as attention bias to augment object detection, following the verification of its statistical significance using a proposed quantitative macrosopic correlation (MC) metric. Our approach, termed Relation-DETR, introduces an encoder to construct position relation embeddings for progressive attention refinement, which further extends the traditional streaming pipeline of DETR into a contrastive relation pipeline to address the conflicts between non-duplicate predictions and positive supervision. Extensive experiments on both generic and task-specific datasets demonstrate the effectiveness of our approach. Under the same configurations, Relation-DETR achieves a significant improvement (+2.0% AP compared to DINO), state-of-the-art performance (51.7% AP for 1× and 52.1% AP for 2× settings), and a remarkably faster convergence speed (over 40% AP with only 2 training epochs) than existing DETR detectors on COCO val2017. Moreover, the proposed relation encoder serves as a universal plug-in-and-play component, bringing clear improvements for theoretically any DETR-like methods. Furthermore, we introduce a class-agnostic detection dataset, SA-Det-100k. The experimental results on the dataset illustrate that the proposed explicit position relation achieves a clear improvement of 1.3% AP, highlighting its potential towards universal object detection.
Introduction
目标检测目标是解决 RoI 的 Bounding Box 回归和分类问题。最近的 DETR 消除了后处理步骤中的 NMS,以此来优雅地实现了端到端。但是基于此架构的模型大多都受阻于数据集的庞大和收敛较慢,其主要原因在于非重复预测和正向监督的冲突。DETR 在训练过程中使用匈牙利算法将单一正样本预测与每一个 GT 进行计算来获得唯一的结果。然而这样就会导致负样本预测在 loss 的计算中占据较高占比导致对正监督的不足,因此就需要更多的样本和迭代来收敛。以往的尝试通过引入 train-only 的架构(如查询去噪、多组查询、辅助查询、collaborative hybrid assignment training)进行额外监督,或将 hard mining 纳入损失函数(如 IA-BCE loss、position-supervised loss)来探讨这一问题。其他研究还提出了一些特定结构,以改善查询和特征图之间的互动(如 dynamic anchor query、cascade window attention),以及一些专注于高质量查询的技术(hierarchical filtering、dense distinct process 和 query rank layer)。尽管取得了这些进步,但从自注意机制的角度对这一问题的探讨却很少,而自注意机制被广泛应用于大多数 DETR 的 Decoder 中。
自注意机制的有效性在于它建立了序列嵌入之间的高维关系表征,这也是不同检测特征表征之间关系建模的关键组成部分。然而,这种关系是一种隐式表示,因为它假定输入不存在结构偏差,甚至位置信息也需要从训练数据中学习。因此,Transformer 的学习过程是数据密集型的,而且收敛速度较慢。这一分析促使我们引入特定任务偏置,以实现更快的收敛并减少对数据的依赖。
在这篇论文中,作者提出的 Relation-DETR 通过引入显式位置关系先验(explicit position relation prior)来提升 DETR 的检测性能。其首先建立了一种量化图像中位置关系的度量标准,并对其分布进行分析,以验证其统计意义。在此之上,引入了位置关系编码器,对两个边界框之间的所有成对交互进行建模,并采用渐进式注意力细化来实现跨层信息交互。为了保持端到端属性,同时提供足够的正监督,引入了对比关系策略,该策略利用一对一和一对多匹配,同时强调位置关系对重复数据删除的影响。
与之前的研究相比,Relation-DETR 的主要特点是整合了明确的位置关系。相比之下,之前的工作侧重于从训练数据中隐含学习注意力权重,导致收敛速度缓慢。直观地说,文章提出的位置关系可以被看作是一种即插即用的设计,有利于非重复预测,因为它建立了边界框对之间的相对位置表示(类似于 NMS 中的 IoU)。
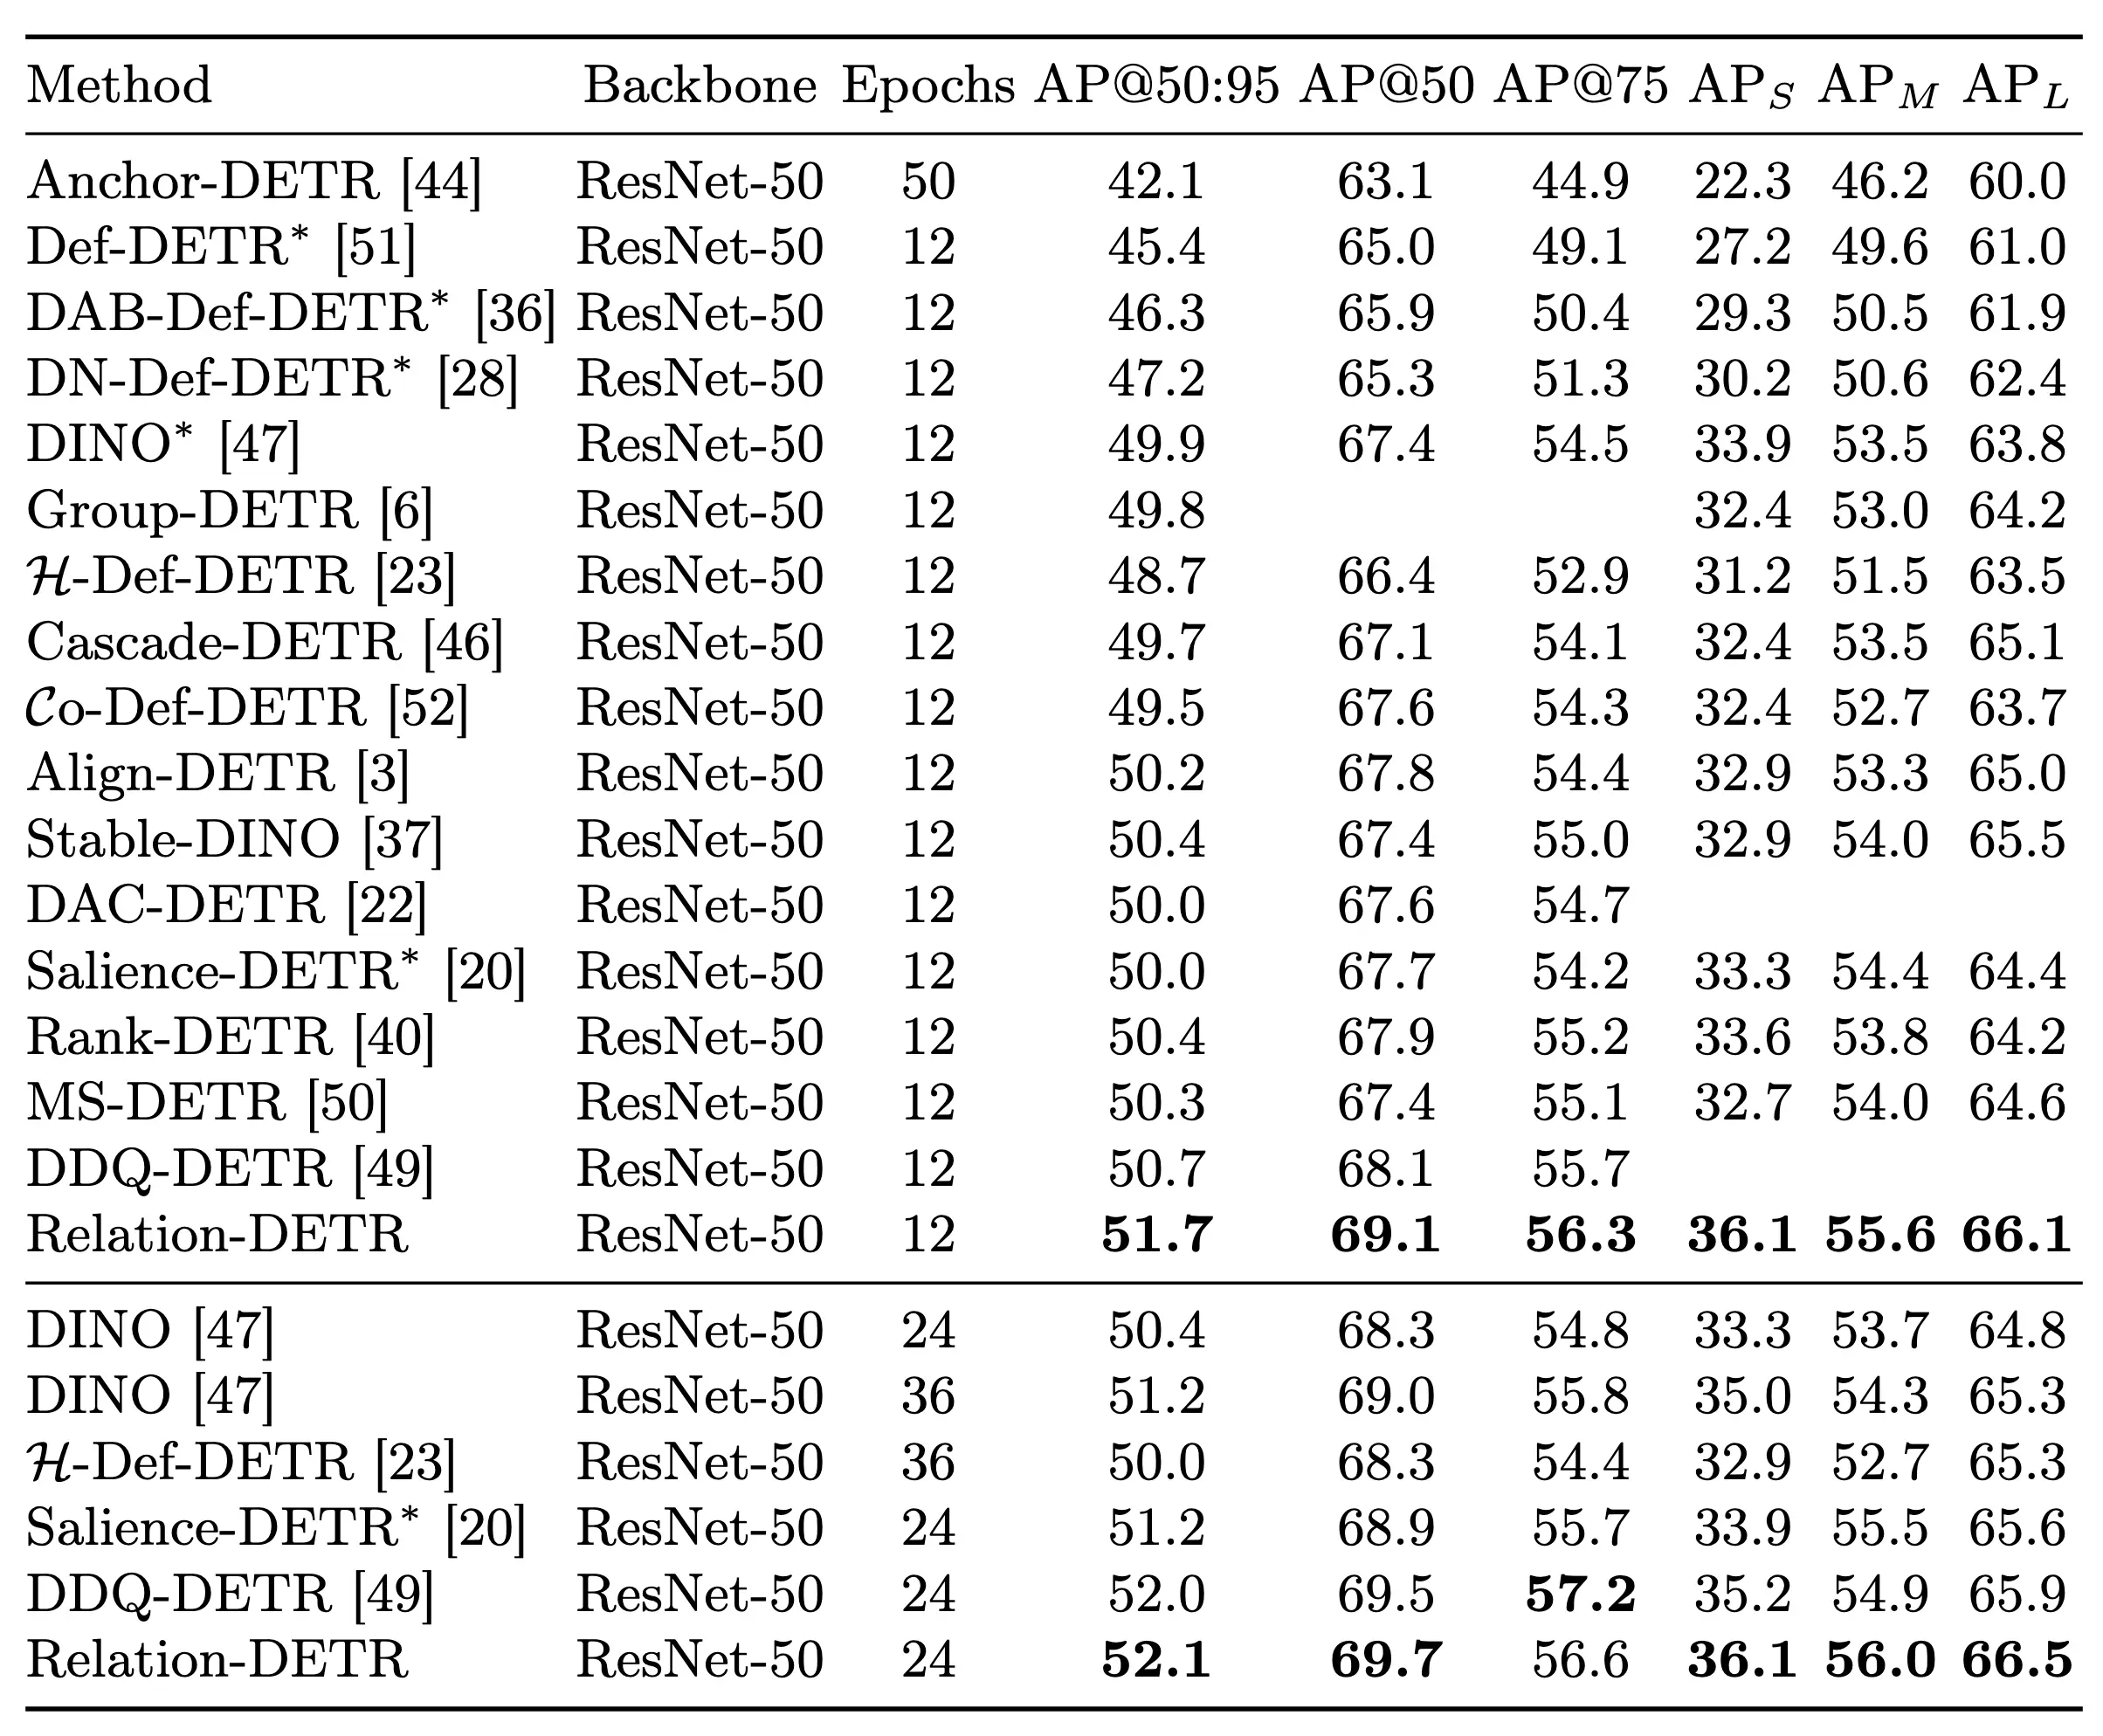
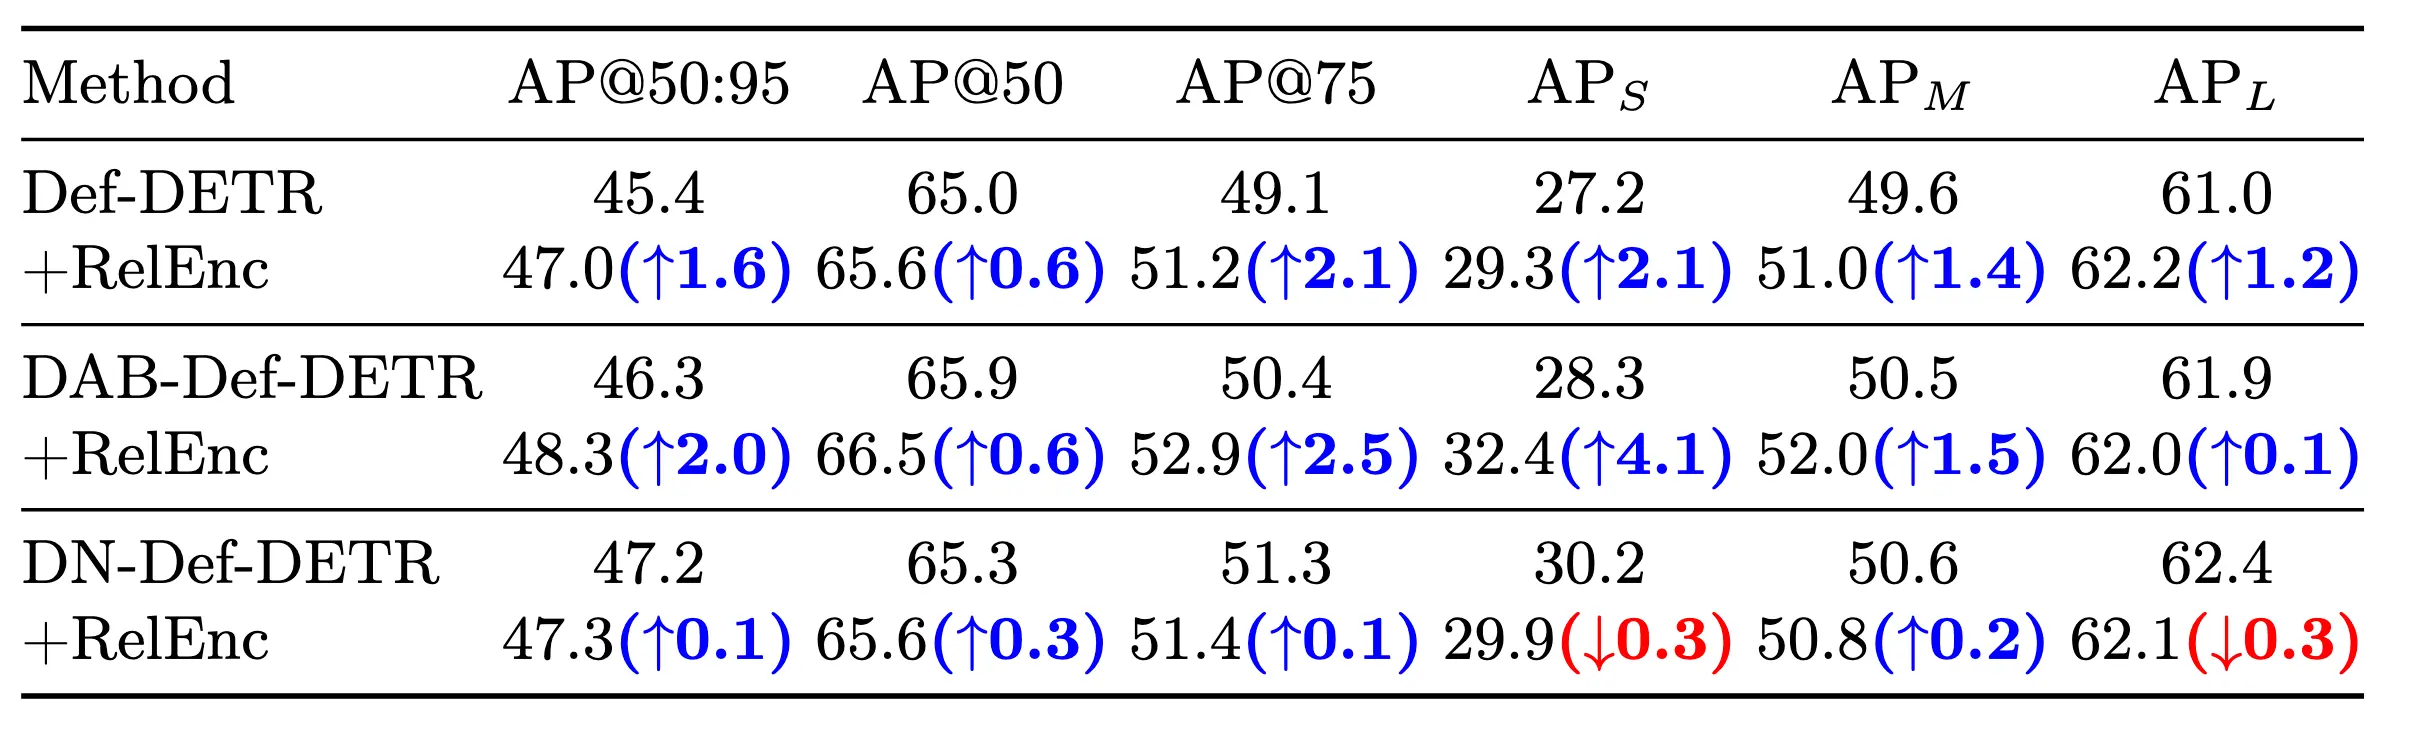
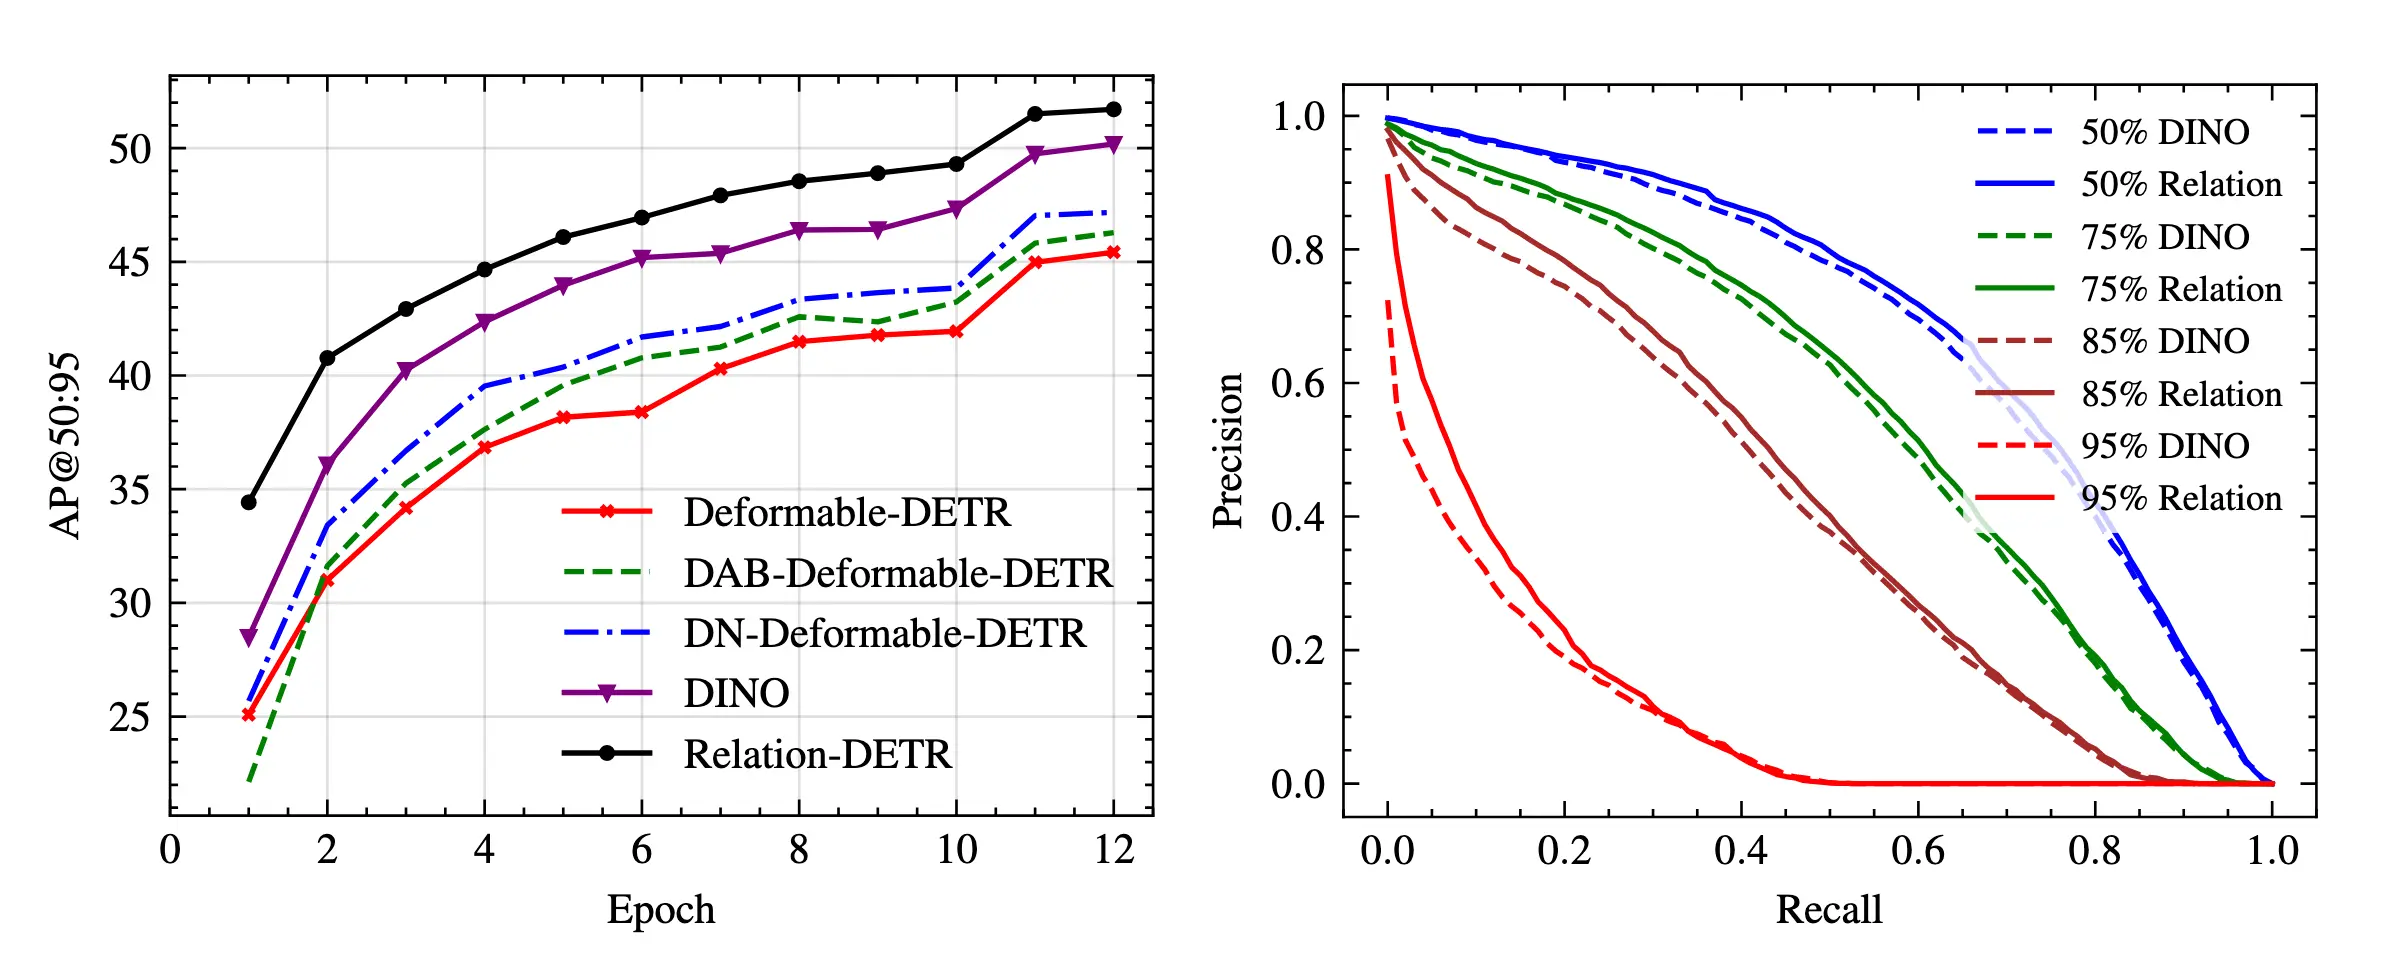
在 COCO 2017 以及几个特定任务数据集上评估了 Relation-DETR 的性能。实验结果证明了它的卓越性能,以明显的优势超越了以前最先进的 DETR 检测器。更具体地说,Relation-DETR 的收敛速度非常快。在 1× 训练配置下,以 ResNet50 为骨干,仅用 2 个epochs,它就成为第一个在 COCO 上达到 40% AP 的 DETR 检测器。此外,位置关系编码器结构设计简单,具有良好的可移植性。只需稍加修改,它就能轻松扩展到其他基于 DETR 的方法,从而实现性能的持续提升。这与现有的一些 DETR 检测器形成鲜明对比,后者的性能高度依赖于复杂的匹配策略或基于卷积的检测器开发的检测头。
Related Work
用于目标检测的 Transformer
大多数将 Transformer 应用于目标检测的尝试都集中在构建可并行处理的序列上,这些序列通常位于特征提取器或检测模块中。这些方法通常通过图像块生成 token 序列,并通过聚合局部特征或使用金字塔后处理技术提取多尺度特征。DETR 将提取的特征编码为目标查询,并将其解码为边界框和标签。然而,DETR 的自注意力机制对大规模数据集和大量训练迭代有较高要求,因为其收敛速度较慢。许多研究尝试通过结构化注意力、显式先验和额外的正监督来解决这个问题,但很少有研究从隐式先验的角度探讨这一问题。本文旨在通过关注位置关系来解决收敛缓慢的问题。
关系网络
与其在像素级别、patch 级别或图像级别处理视觉特征,关系网络则在实例级别捕捉关系特征。现有关于关系网络的研究分为基于类别和基于实例的两种方法。基于类别的方法通过关系数据集(如 Visual Genome)或自适应地从类别标签中学习,构建概念或统计关系(如共现概率)。然而,这些方法由于实例与类别之间的分配问题增加了复杂性。相比之下,基于实例的方法直接基于目标特征构建精细的图结构,将目标特征作为节点,将它们之间的关系作为边集。因此,在训练过程中对图结构的推理可以自然地确定显式关系权重。通常,这种权重表示高维空间中每对目标实例之间的参数化距离,如外观相似性、proposal 距离,甚至是自注意力权重。由于仅从训练数据中学习自注意力权重而没有结构偏置会增加对数据集规模和迭代次数的要求,文章探讨了显式位置关系作为先验,以减少这些要求。
分类损失 Hard mining
在目标检测训练中,分配给 GT 的正预测远少于负预测,导致监督不平衡和收敛缓慢。针对分类任务,Focal Loss 引入了一个权重参数以聚焦在难样本上,这一方法后来被扩展为多种变体,如 Generalized Focal Loss(GFL)和 Vari Focal Loss(VFL)。此外,在目标检测任务中,基于回归指标的调制项损失(如TOOD、IA-BCE、Position-supervised loss)能够进一步提高分类与回归任务之间的高质量对齐。
物体位置关系的统计意义
作者提出了一种基于皮尔逊相关系数(Pearson Correlation Coefficient - PCC)的定量宏观相关性(Macroscopic Correlation - MC)度量来测量单个图像中对象之间的位置相关性。假设图像中的对象形成节点集,每对边界框注释之间的 PCC 作为其对应的边缘权重。我们可以构造一个具有连续值的无向图。最后,可以使用图强度计算每个图像的宏观相关性,公式为:
其中表示对象的数量,即节点的数量,表示数据集中边界框的位置注释。仅当所有对象完全线性相关时,,而如果任何一对对象之间不存在位置相关性,则。
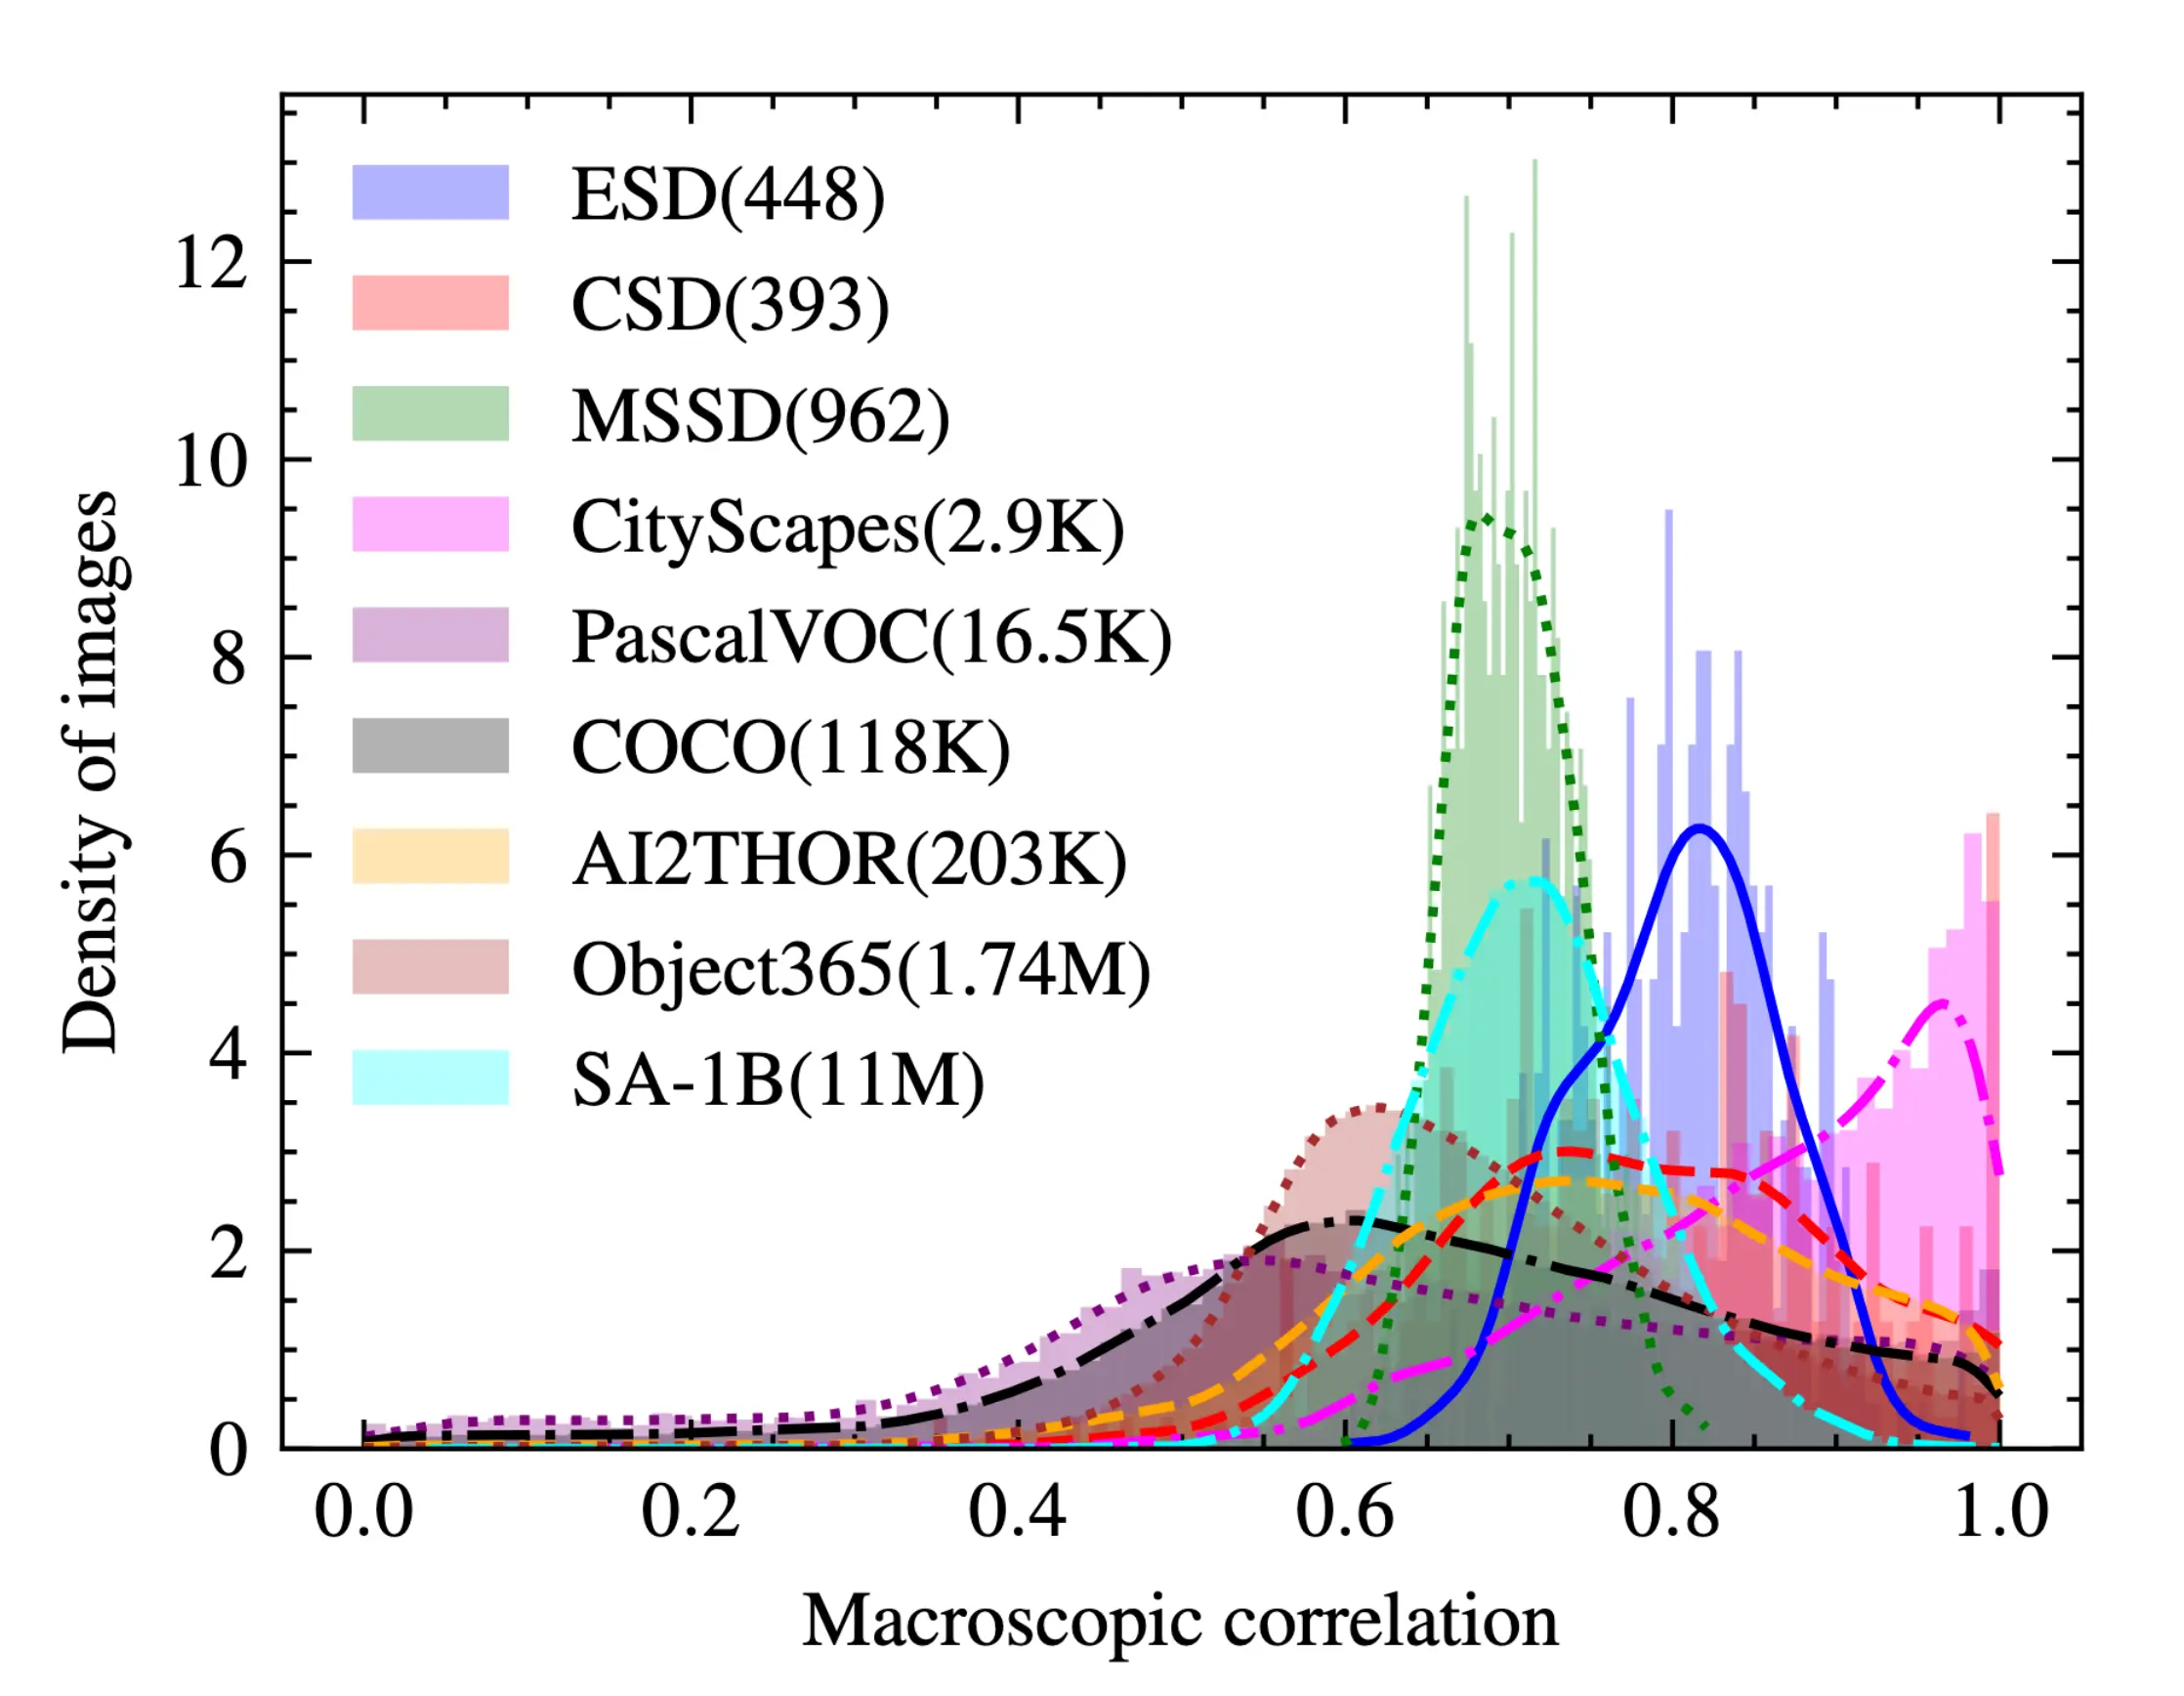
所有这些数据集都表明,MC 的分布集中在高数值附近,分布中心更接近上限。这表明了物体位置关系的存在和统计意义。具体来说,特定任务数据集在高维特征空间中显示出更多的先验知识和更清晰的聚类模式,从而导致 MC 值高于 COCO 等通用数据集。
Relation-DETR
Position relation encoder
在卷积网络中关系有效性早已被证明,近来在 DETR 方法中,通过使用类索引从类别级关系进行索引来构造实例级关系,作为对比,所提方法通过一个简单的位置编码器直接地构造实例级关系。
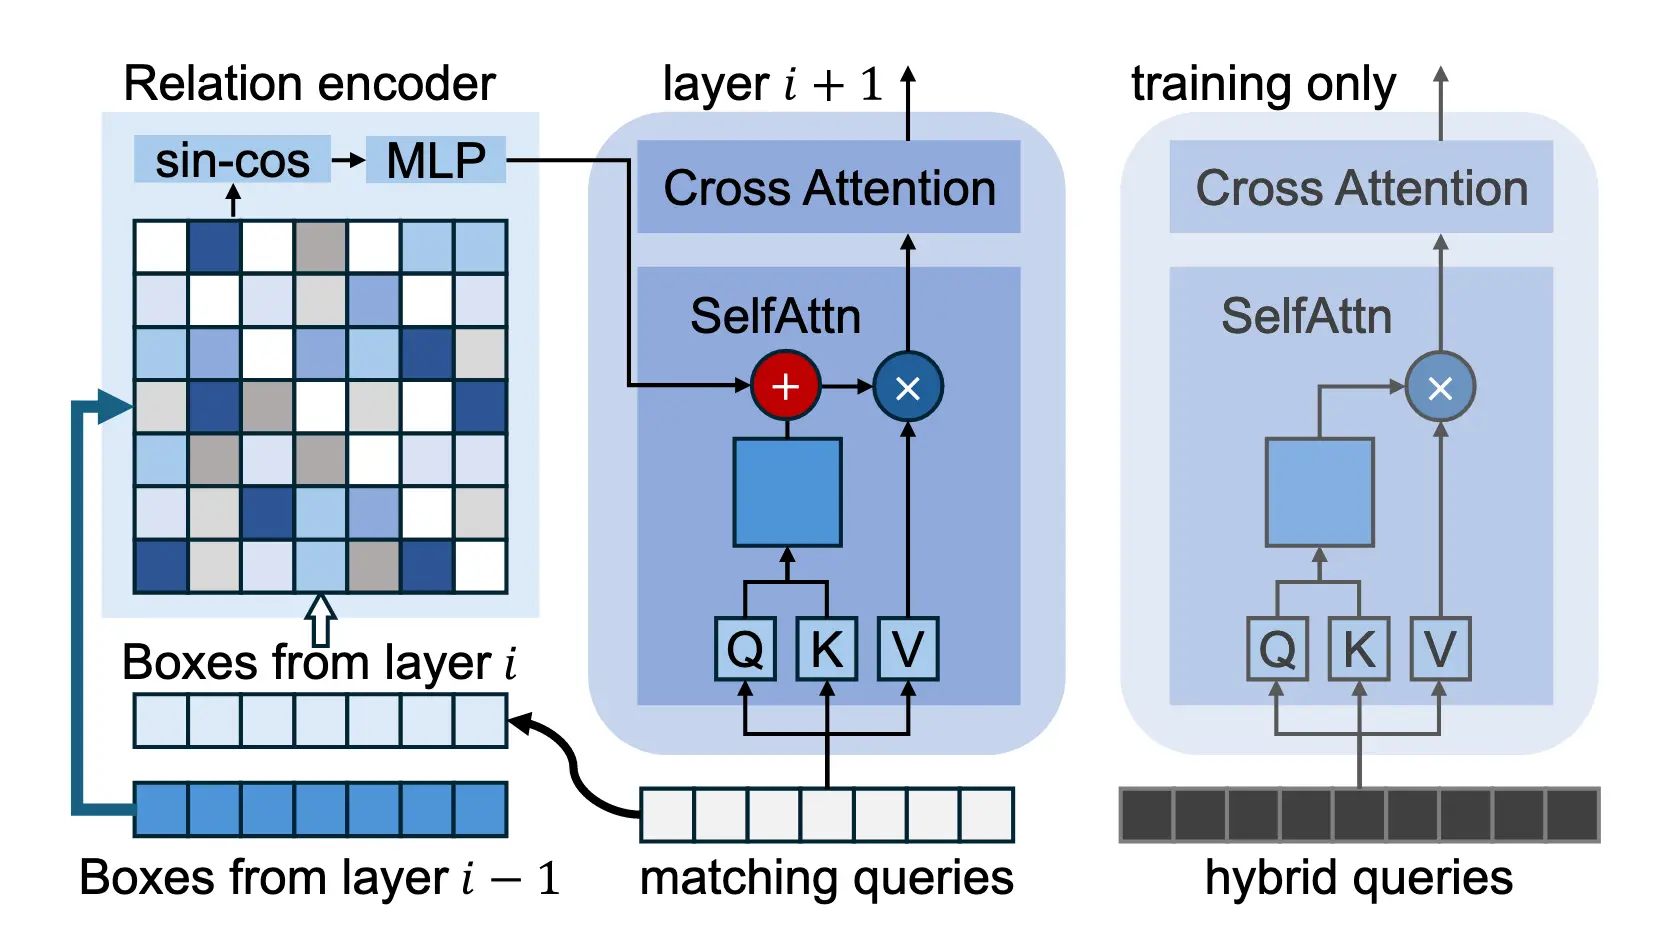
所提出的位置关系编码器将高维关系嵌入作为 Transformer 中自注意力的显式先验。这种嵌入是根据每个解码器层的预测边界框(表示为)计算出来的。为确保关系对平移和缩放变换保持不变,我们根据归一化的相对几何特征对其进行编码:
该位置关系是未偏置的,因为时。关系矩阵(其中 )通过正弦余弦编码进一步转化为高维嵌入。
其中关系嵌入的形状,、和是编码参数。最后,嵌入经过线性变换以获得个标量权重,其中表示注意力头的数量。
其中确保关系为正值来避免在集成到自注意力时在之后梯度消失,。
Progressive attention refinement with position relation
Deformable-DETR 提出的迭代边界框细化方法已在高质量边界框回归中显示出其有效性。在此基础上,作者提出了一种渐进式注意力细化方法,将位置关系引入到 DETR 的流式流水线中。具体来说,第层的位置关系由第层和第层的边界框确定,并进一步整合到自注意力中,以生成第层的边界框。
其中,表示 DETR 变换器中第层解码器的查询,表示存储器,即来自 Transformer 编码器的增强图像特征。
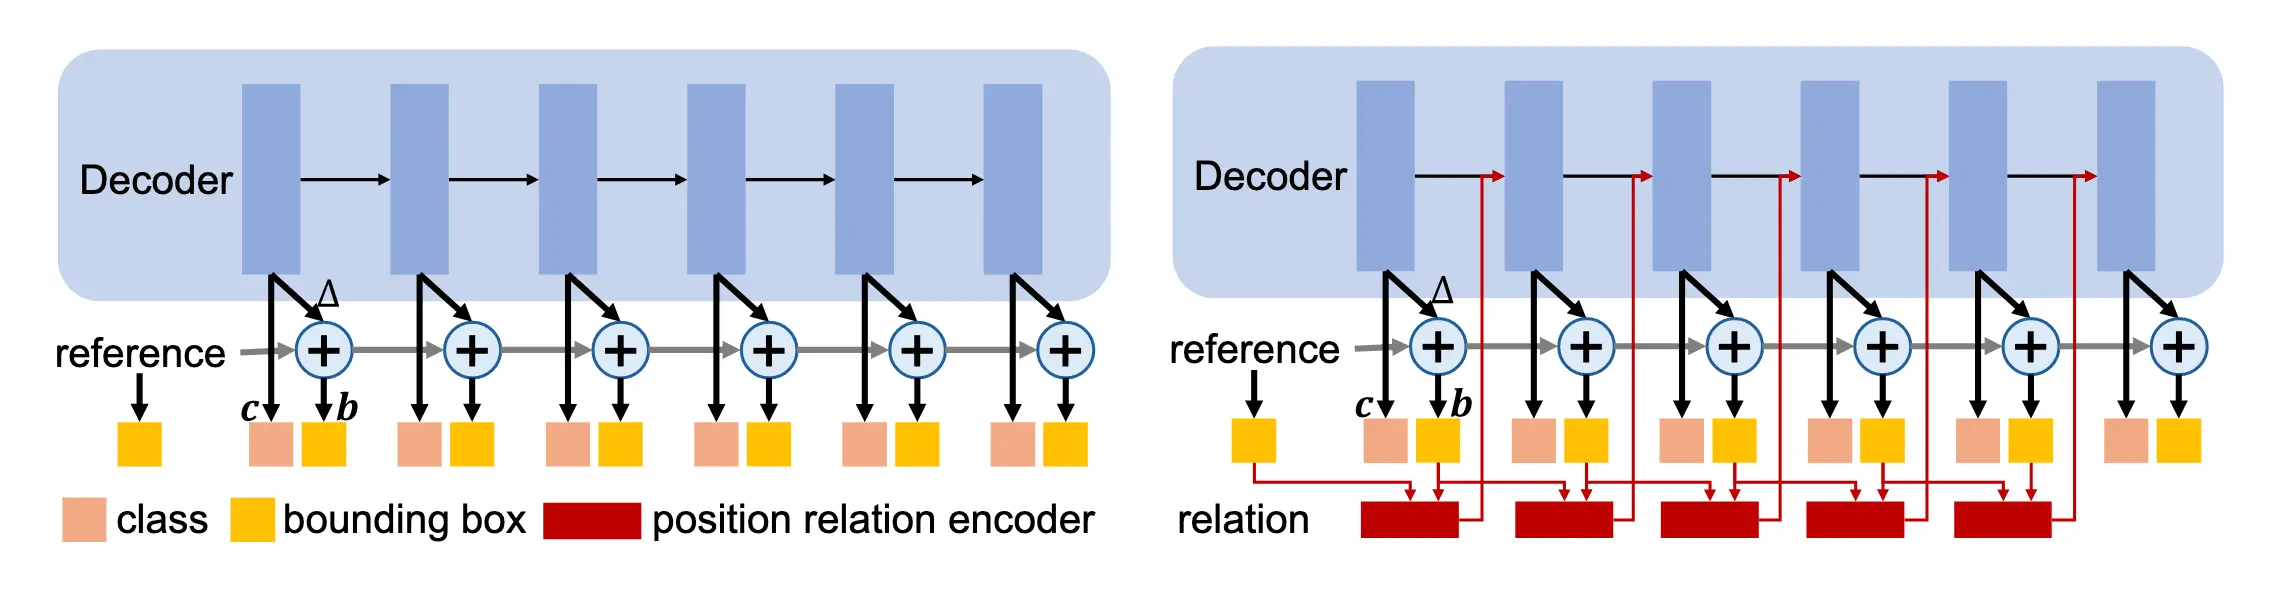
如图,引入一个横向分支来计算位置关系。因此,位置关系和渐进式注意力细化是简单明了的,可以与现有 DETR 检测器中的自我注意力进行即插即用的整合,从而实现一致的性能改进。
Contrast relation pipeline
思考现有的重复去除方法的机制,这些过程在很大程度上都依赖于 IoU(intersection over Union),而 IoU 在某种程度上表示边界框之间的位置关系。因此可以假设,在自注意力中整合查询之间的位置关系有助于在物体检测中进行非重复预测。
DETR 的工作流程必须进行一对一匹配和一对多匹配,这就造成了非重复预测和充分正向监督之间的冲突。为了克服这一局限性,通过将其扩展为基于位置关系的对比 Pipeline。具体来说,通过构建了两个并行查询集,即匹配查询和混合查询。两者都输入到 Transformer 解码器,但经过不同的处理。在处理匹配查询时,会结合位置关系进行自注意,以生成非重复预测:
而混合查询由相同的解码器解码,但跳过了位置关系的计算,以探索更多潜在候选。它们对应的预测值分别表示为和。
假设表示 GT,对于,我们采用一对一匹配方案来强调不重复属性,损失计算类似于原始DETR方法:
而对于,则采用一对多的匹配方案,以形成更多潜在的正例候选。只需遵循 H-DETR,重复 GT次,表示为,进行损失计算:
其中,表示匈牙利损失,表示解码器层数。混合查询只在训练过程中进行,因此不会给推理带来额外的计算负担。
实验结果和讨论
与 SOTA 的比较
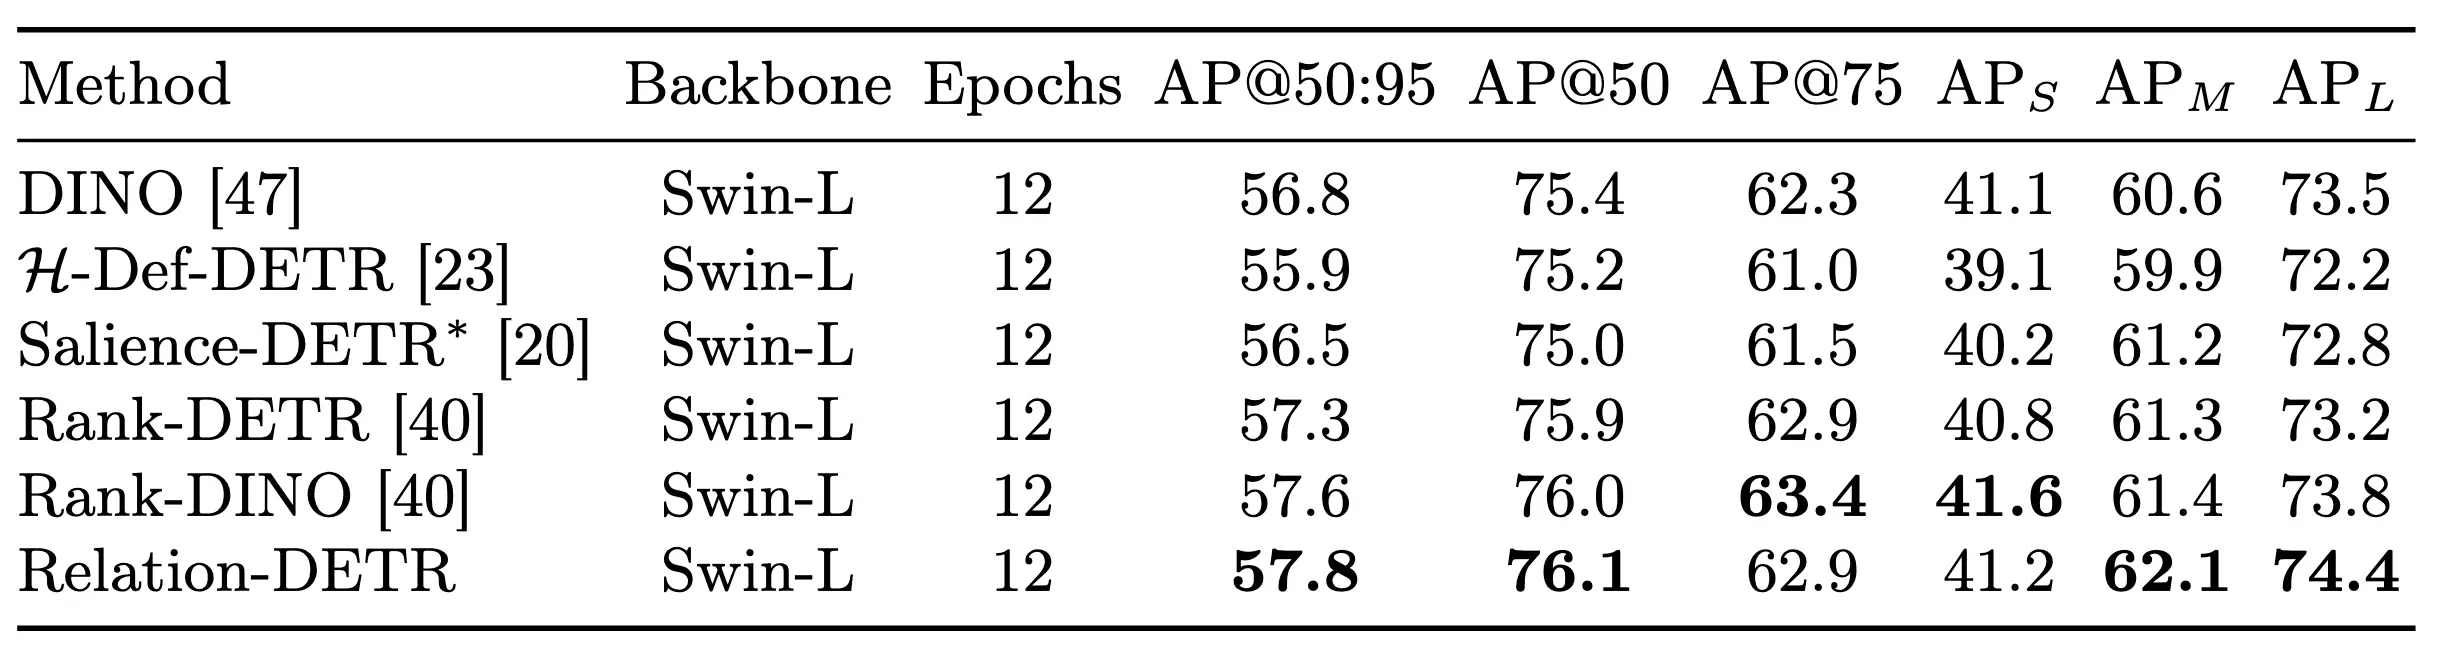
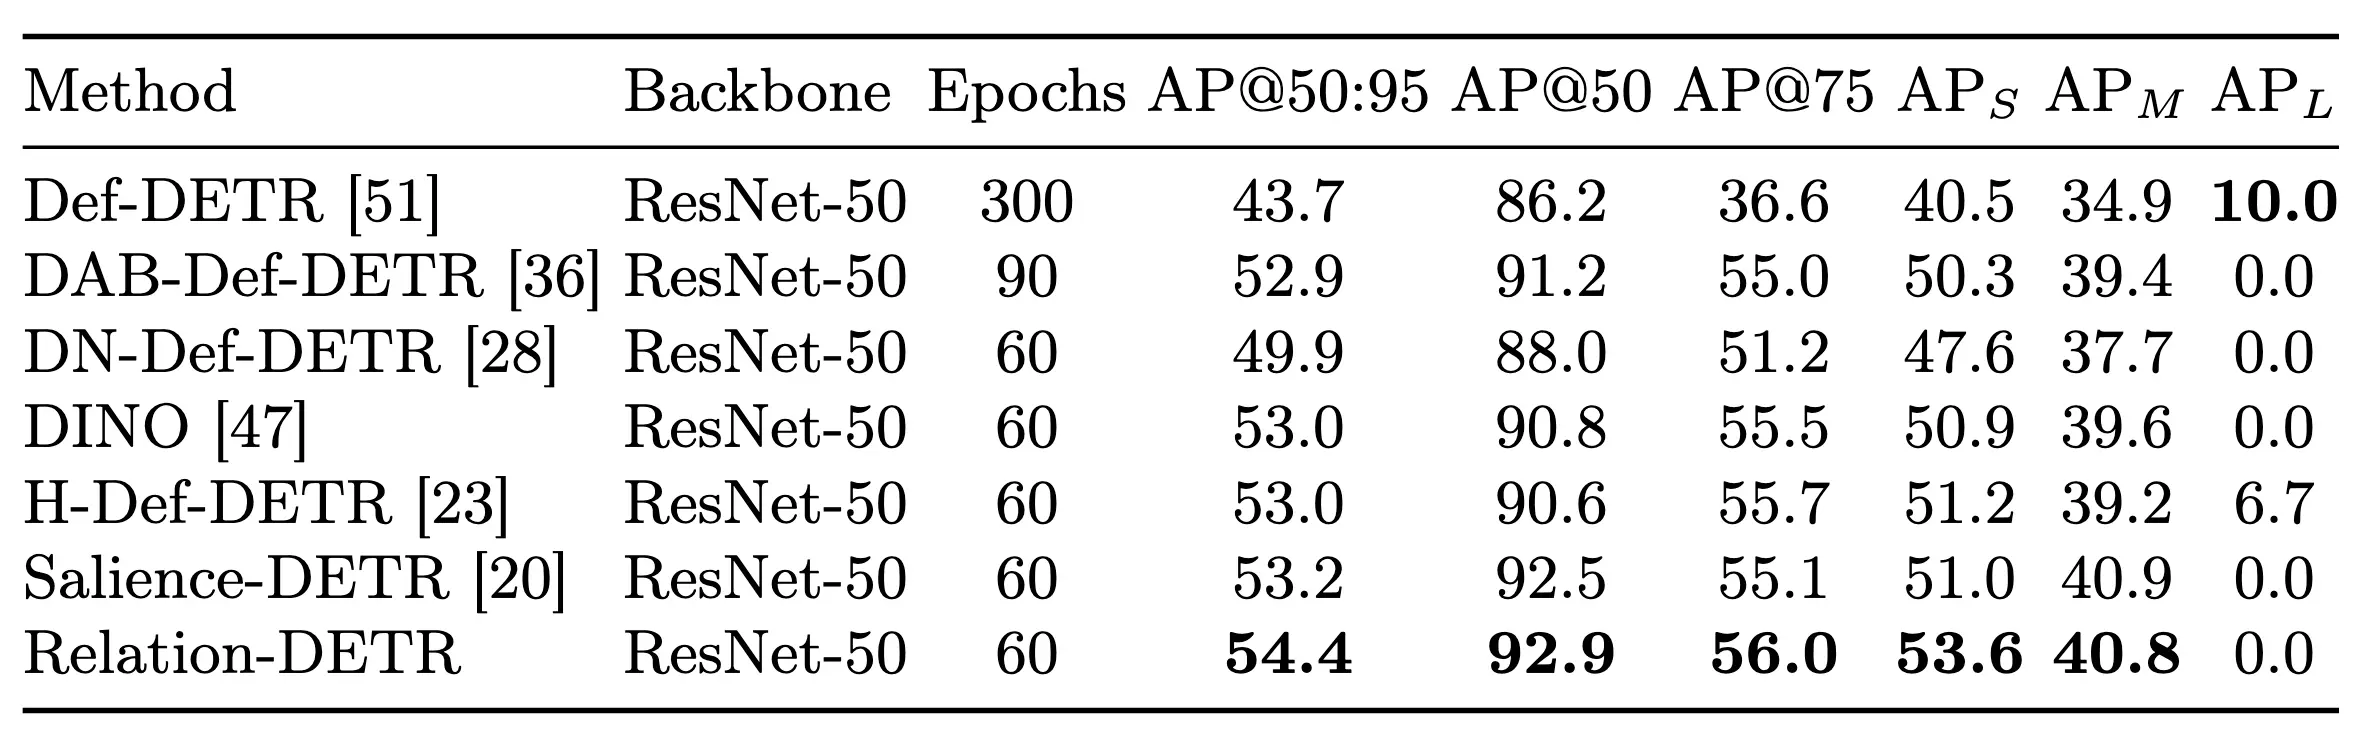
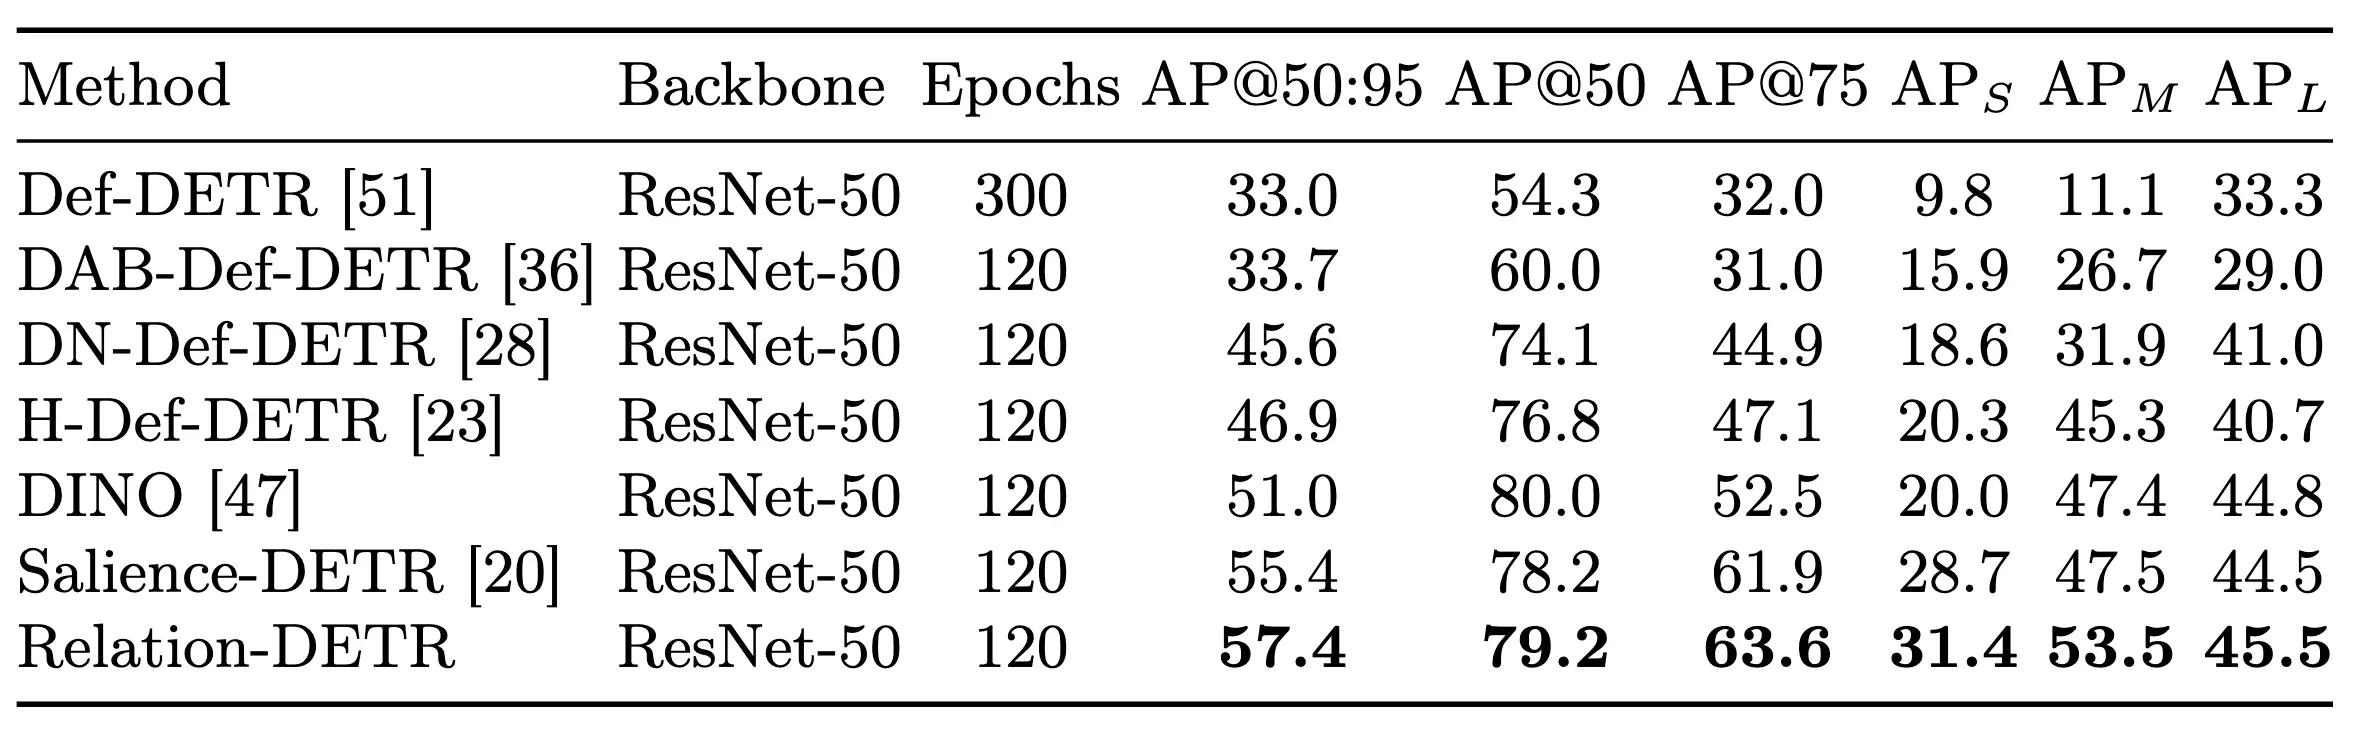
消融实验
位置关系的可迁移性
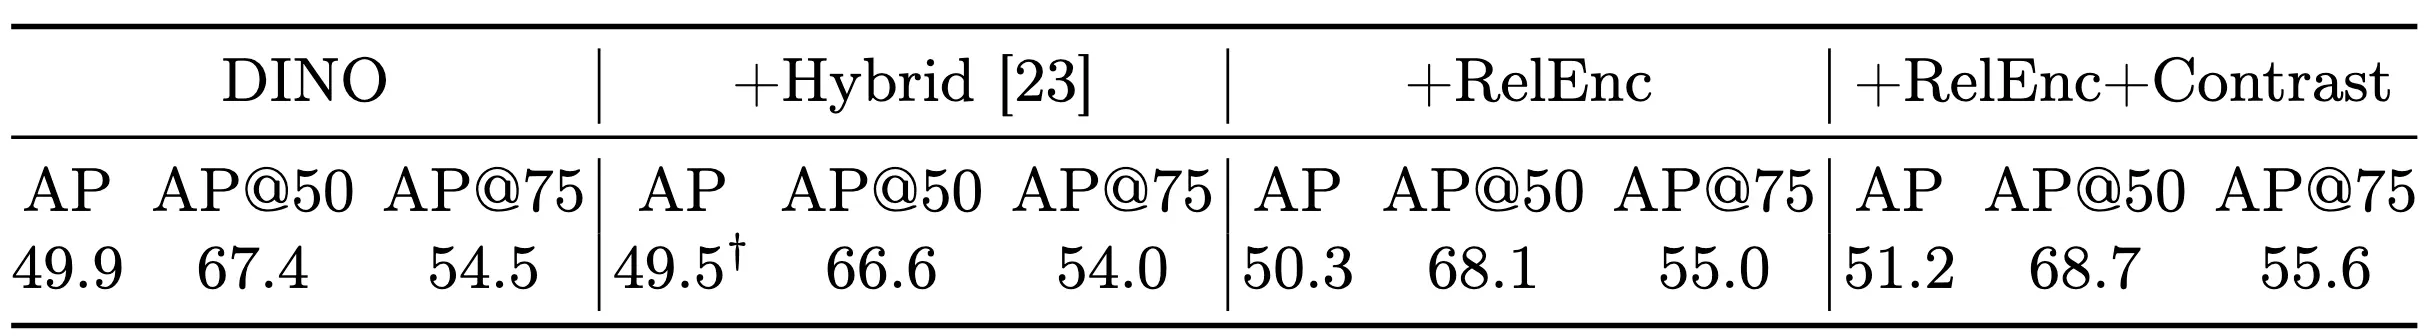
直观性能比较
可视化
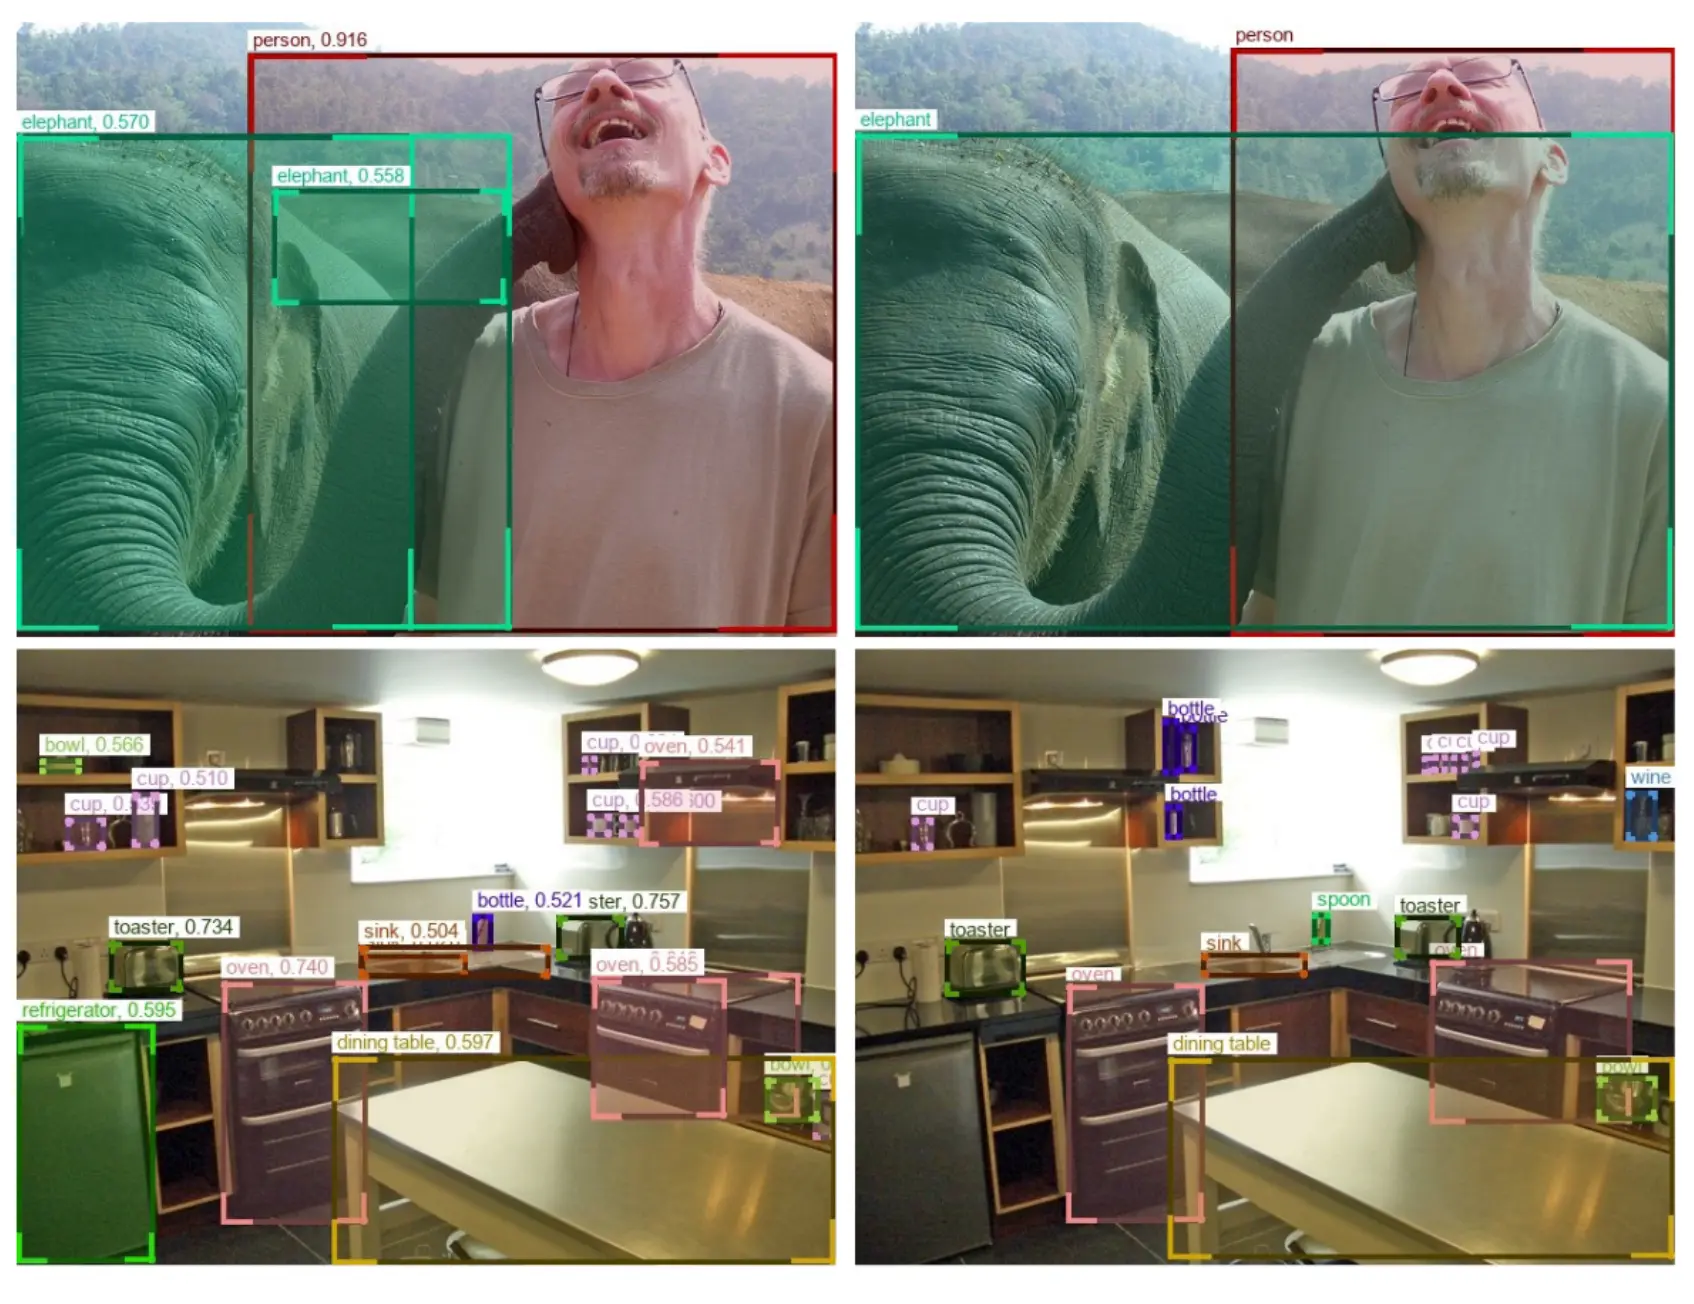
为了更直观地了解关系机制,下图展示了在给定查询对象时具有高关系权重的代表性对象。可视化显示,无论是通用数据集还是特定任务数据集,关系都有助于根据给定的对象查询识别其他候选检测对象。此外,小尺寸对象由于缺乏自身的语义信息,往往会与其他对象建立更多的关系连接。因此,构建关系对于小型物体的检测至关重要。
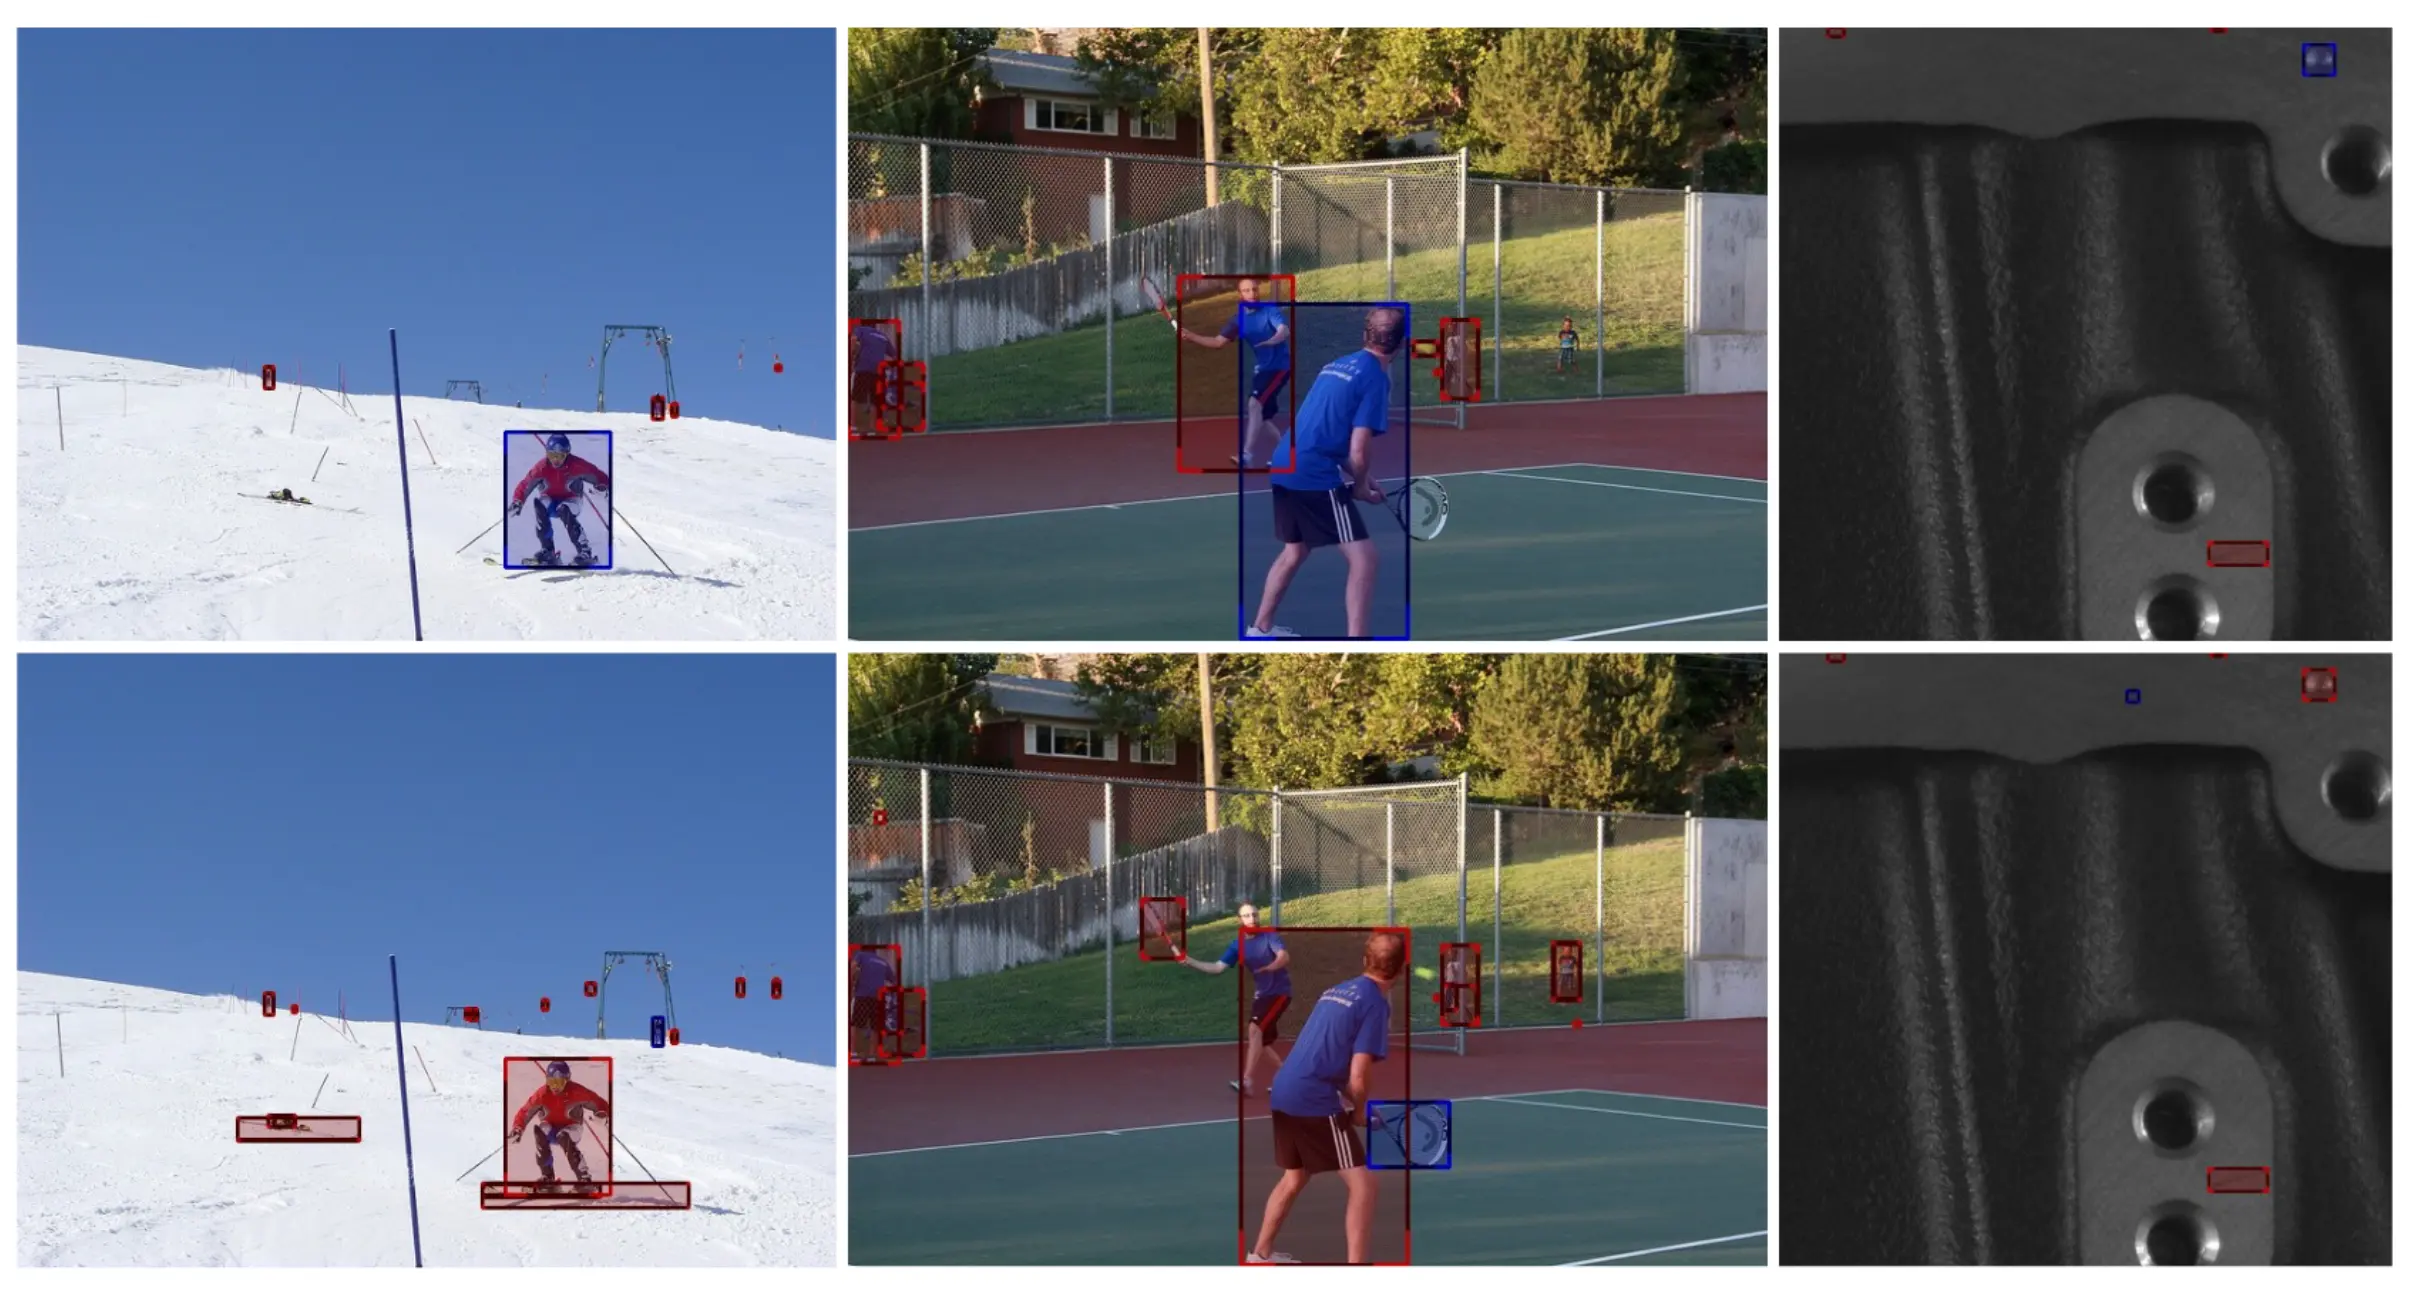
下图进一步直观展示了 Relation-DETR 的一些失败案例,表明所提出的模型可以通过考虑更复杂的关系(如遮挡和语义关系),从具有误导性语义差异的遮挡物体和密集物体中获益。
迈向通用目标检测
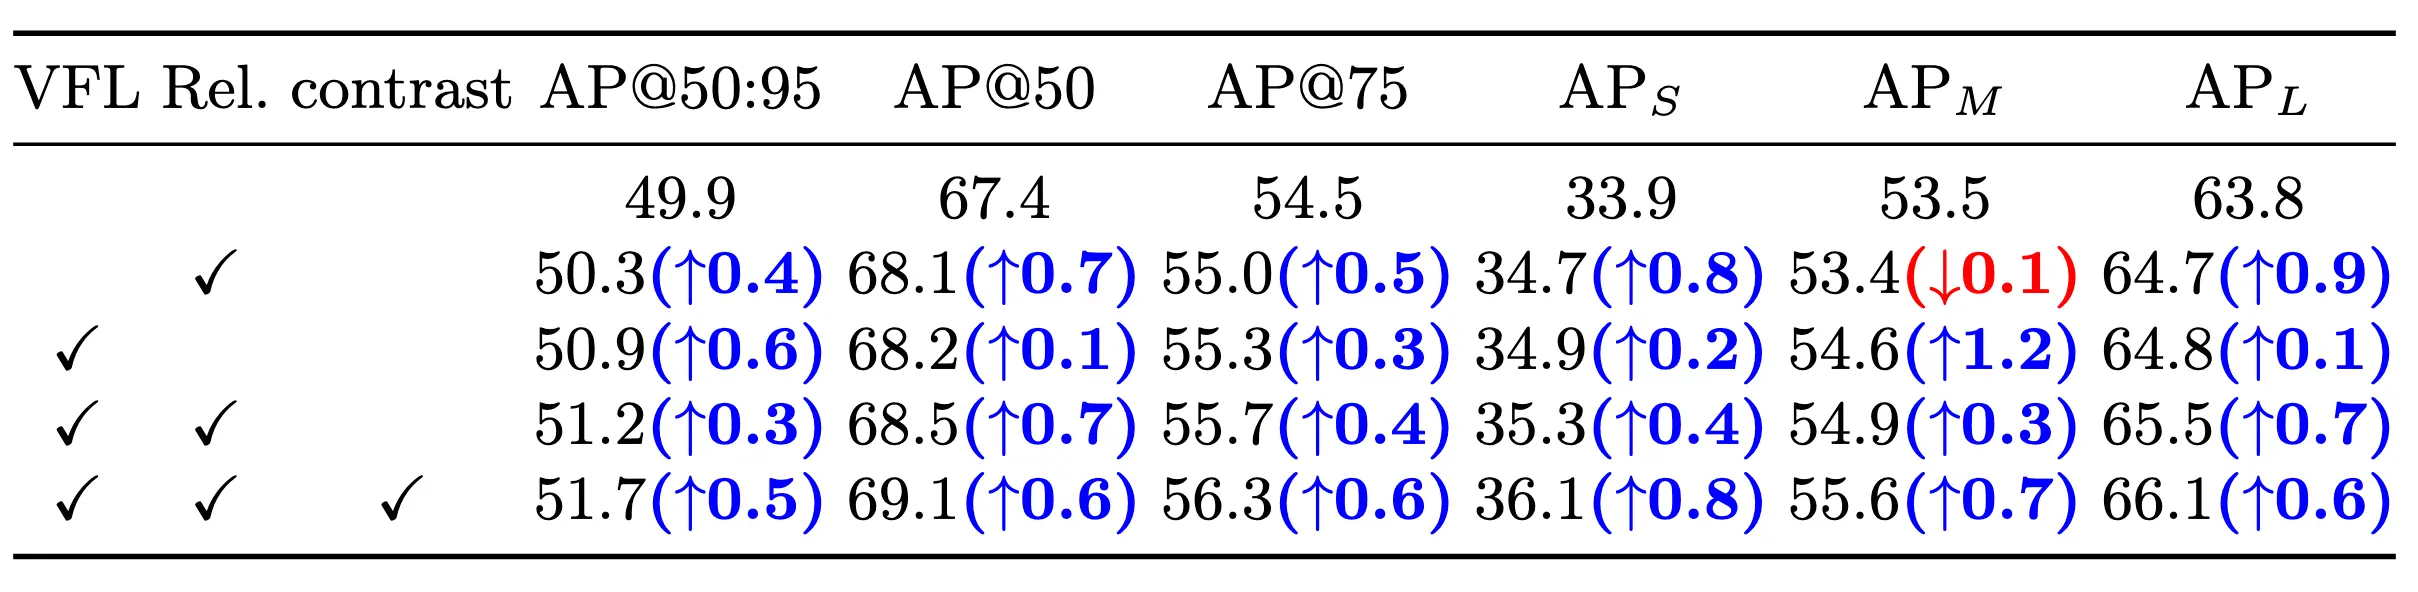
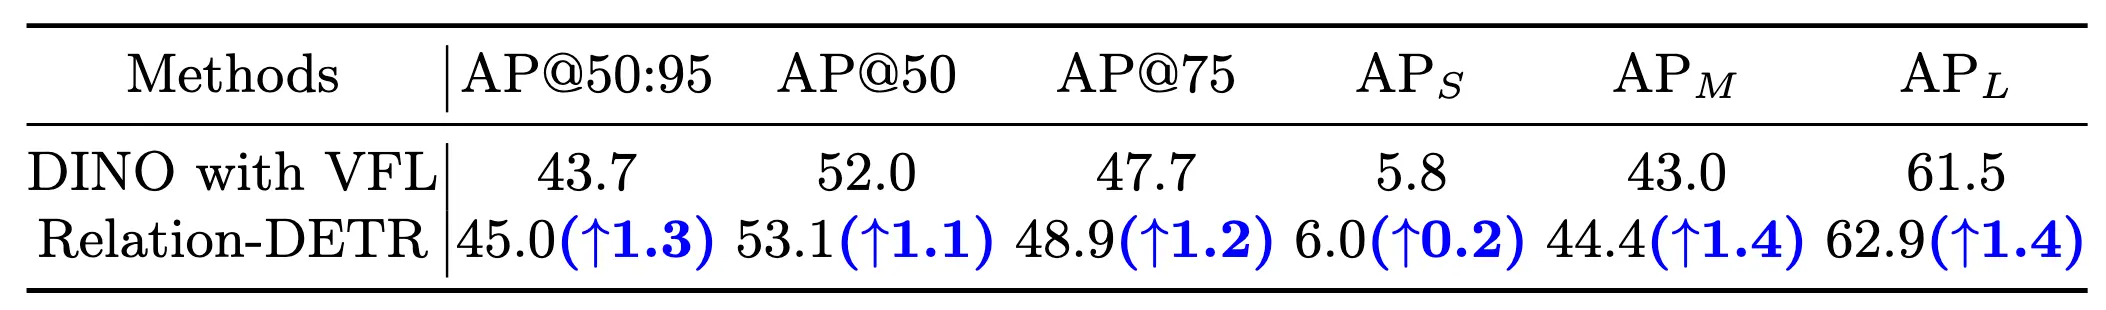
位置关系先验知识对于涵盖更多场景和物体的数据集是否仍然有效?为了探索这一点,作者从 SA-1B 中抽取了一个子集,构建了一个包含约 100000 张图像的大规模类别无关检测数据集,称为 SA-Det-100k,SA-1B 是 Segment Anything 中提出的规模最大的分割数据集之一。然后,在该数据集上比较了 Relation-DETR 与使用 VFL 的 DINO 的性能。下表中的结果显示,Relation-DETR 的 AP 明显提高了 1.3%,证明了所提出的位置关系先验的可扩展性。
结论
本文探讨了明确的位置关系先验,以提高 DETR 检测器的性能和收敛性。以归一化的相对几何特征为基础,提出了一种新颖的位置关系,它能克服规模偏差,实现渐进式注意力细化。为了解决 DETR 框架中的非重复预测和充分的正向监督之间的矛盾,基于所提出的位置关系将流式管道扩展为对比管道。将这些组件结合起来,就产生了最先进的检测器,称为 Relation-DETR。大规模消融研究和实验结果表明,所提出的检测器性能优越,收敛速度更快,并具有良好的可移植性。此外,Relation-DETR 对一般检测任务和特定任务的检测任务都具有显著的通用性。作者相信,这项工作将激励未来对 DETR 检测器的关系和结构偏差的研究。