Abstract
尽管伪标签方法在半监督目标检测任务中取得了显著的成功,但本文揭示了该方法存在的一些显著局限性。具体而言,伪标签方法往往会放大检测器的固有优势,同时突出其弱点,这体现在伪标签的遗漏,尤其是在小型和尾部类别物体上。
为了克服这些挑战,本文提出了一种名为Mixed Pseudo Labels(MixPL)的方法,包括Mixup和Mosaic用于伪标签数据,以减轻伪标签遗漏的负面影响,并使模型在不同的物体尺度上学习平衡。此外,通过与相关实例重新采样标记数据,提高了模型在尾部类别上的检测性能。
值得注意的是,MixPL始终改进了各种检测器的性能,并在COCO-Standard和COCO-Full基准测试上,与Faster R-CNN,FCOS和DINO相比,获得了新的最先进的结果。此外,MixPL在大模型上也表现出良好的可扩展性,将DINO Swin-L的mAP提高了2.5%,并在COCO val2017基准测试上,无需额外标注,实现了新的记录(60.2% mAP)。
Introduction
在深度学习时代,目标检测取得了显著的进展,但高度依赖昂贵的人工标注。因此,半监督学习越来越受到研究兴趣的青睐,它利用未标注数据来提高检测器性能,而不只是依赖标注。
半监督学习方法包括从模型预测中生成伪标签,用于未标注数据,并使用它们训练学生模型。这种范式在图像分类方面取得了广泛成功,但在目标检测方面面临显著挑战。因为目标检测器需要在图像中检测大小和数量不同的目标,其预测结果,后来用作伪标签,可能会遗漏目标,或者包含背景区域的边界框。此外,检测器在检测不同尺度和类别目标时具有不同的能力,导致伪标签和 GT 之间的目标分布存在显著差异。因此,伪标签在识别大型目标和突出类别方面取得了显著改进,但对于识别小目标和尾部类别仍提供有限帮助。
在半监督目标检测(SSOD)的前期方法中,通过增强检测器特定组件来提高伪标签质量或学习效率,但这些方法在不同模型之间缺乏通用性。相比之下,作者的方法通过针对不同尺度和类别进行调整,利用伪标签与 GT 之间的差异,在普遍意义上提升模型性能。
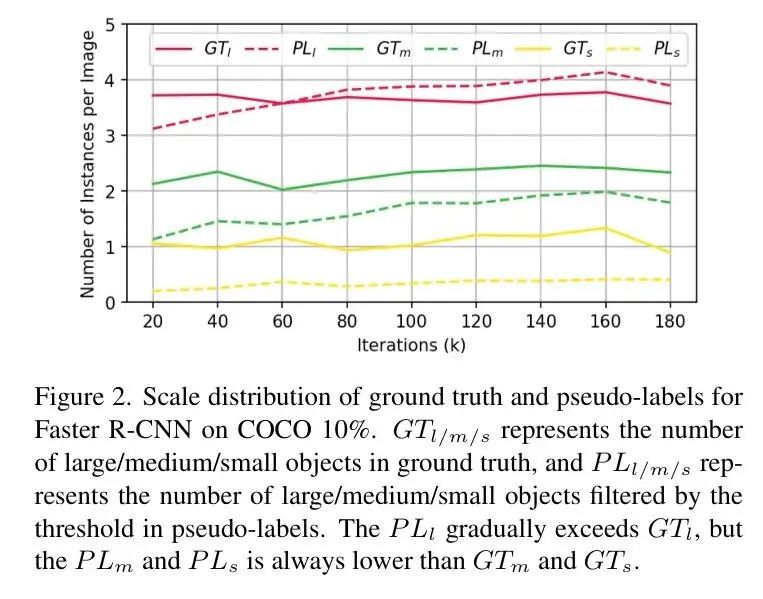
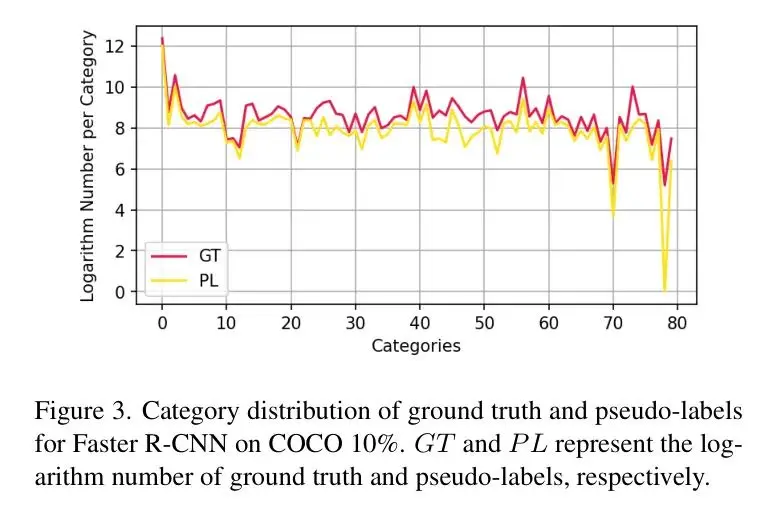
为了实现这一目标,作者首先总结了一个检测 MeanTeacher 框架。与图像分类中的 MeanTeacher 类似,DetMeanTeacher 在概念上简单,适用于所有类型的目标检测器。尽管 MeanTeacher 被用作前期 SSOD 方法的基本框架,但作者发现它在实际应用中使 DetMeanTeacher 在不同的目标检测器上运行具有挑战性,尤其是在一阶段检测器上。这些检测器需要过滤掉没有伪标签的图像,因为它们与 GT 存在显著偏差。这启发作者利用 DetMeanTeacher 测量伪标签与 GT 之间的数量、尺度和类别差异。如图2和图3所示,作者基于 DetMeanTeacher 对 Faster R-CNN 生成的伪标签进行统计分析,并提出了 Mixed Pseudo Labels(MixPL)以及带标记重采样,以提高检测器的半监督性能。
数量
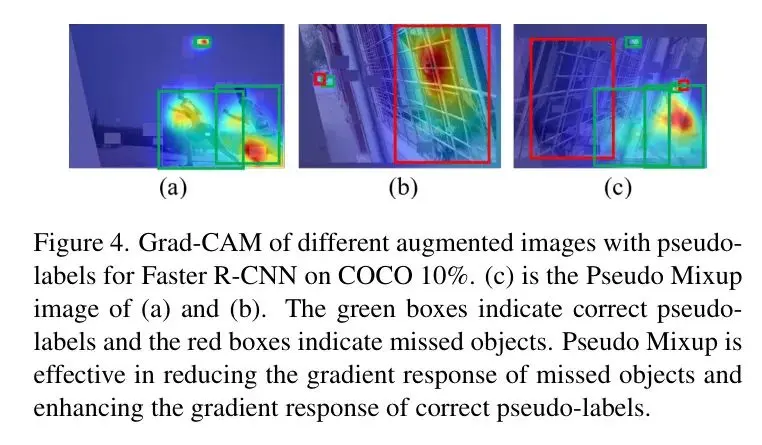
在早期训练中,伪标签的数量明显低于 GT 值。实际上,由于背景-前景样本不平衡,模型倾向于将样本标记为背景。伪标签通过优化未标注数据中的遗漏前景,加强了将样本分类为背景的偏差。尽管遗漏检测难以避免,作者提出了 Pseudo Mixup 以减少负面影响。这种技术涉及将两个伪标签图像以像素方式叠加,通过使它们更类似于实际负样本,有效地减轻了错误负样本的整体负面影响。
尺度
在整个训练过程中,伪标签中的大型物体数量逐渐超过 GT 值,而小和中型物体始终落后于 GT 值。检测器在处理小型物体上存在困难,伪标签在未标注数据优化过程中,将它们视为背景,进一步加剧了这一问题。然而,模型在检测大型物体方面表现出色,因此作者提出了Pseudo Mosaic,将伪标签中的大型物体转换为小型物体。Pseudo Mosaic 将4个下采样伪标签图像结合在一起,为小和中型物体提供更多标签,并增强跨尺度检测能力。
类别
在训练后,头类别伪标签的数量与 GT 值相匹配,而某些尾类别存在缺陷。与尺度问题类似,检测器在处理尾类别物体上存在困难,伪标签在未标注数据优化过程中,将这些物体视为背景,甚至导致某些尾类别检测性能下降。与解决尺度问题不同,作者无法将头类别伪标签转换为尾类别。因此,作者提出带标记重采样,在标记数据中过采样尾类别。尽管这可能减少头类别样本,但模型可以从未标注数据中有效提取头类别伪标签,确保所有类别上的性能。
Detection MeanTeacher
在这项研究中,作者旨在探索适用于不同目标检测器的有效SSOD方法。因此,本文从分析MeanTeacher框架开始,该框架是最近SSOD方法中共享的核心框架。
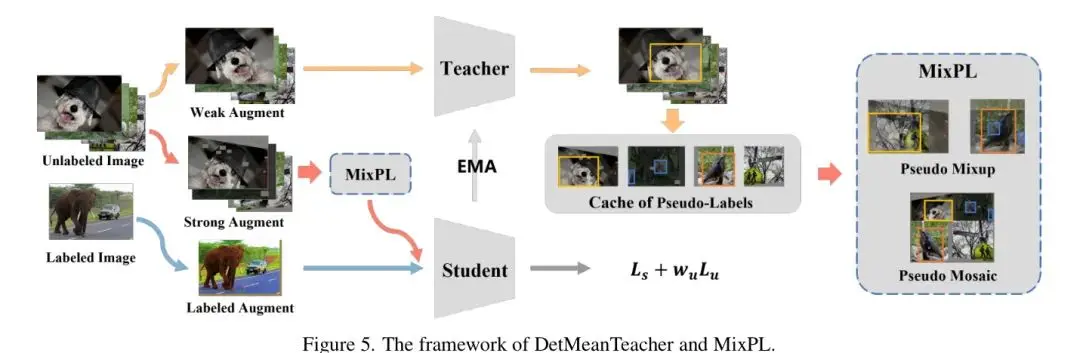
MeanTeacher框架包含一个教师模型和一个学生模型,它们具有相同的结构。在每个训练迭代中:
- 标记图像和未标注图像按照给定的比例随机采样,形成一个批次。
- 每个未标注图像通过弱增强和强增强进行增强,以获得两个视图,教师模型在弱增强的图像上预测伪标签。
- 伪标签通过置信度阈值进行过滤,并转换为强视图,形成具有强增强的伪标签数据。
- 学生模型通过优化基于标记和伪标签数据的监督损失和无监督损失进行更新,而教师模型则使用学生的 EMA 进行更新。
从理论上讲,MeanTeacher 框架不假设特定的检测器结构,因此应适用于所有类型的检测器。为了验证这一点并了解MeanTeacher对不同检测器的影响,作者分别以单阶段检测器 RetinaNet 和两阶段检测器 Faster R-CNN 为例,应用 MeanTeacher 进行半监督学习。分析在 COCO 数据集上进行,其中 10% 的数据标记,其余 90% 的数据未标注 。在 COCO 10% 标记数据上的 Faster R-CNN 和 RetinaNet 的监督 Baseline 分别为 26.6% AP 和 27.2% AP。Faster R-CNN 和 RetinaNet 用于过滤伪标签的置信度阈值分别为0.7和0.4。
过滤没有伪标签的图像
Faster R-CNN 在监督 Baseline (34.7% vs. 26.6% AP)上获得了合理的改进。相比之下,RetinaNet 甚至无法超越其监督 Baseline ,仅实现17.9% AP。作者实际发现,在RetinaNet的训练过程中,一些图像(简称为空图像)实际上没有包含任何伪标签。这是因为教师模型并非完美,其中一些预测的边界框具有低置信度,将被置信度阈值过滤掉。由于一阶段检测器中正负样本之间的差异是一种固有问题,这些问题在这些空图像上可能会被显著加剧,从而使训练不稳定。为了解决这个问题,作者在训练中过滤这些空图像,即学生模型不会在这些空图像上学习。这种简单的策略带来了 RetinaNet 的 90.5% 相对提升,达到了 34.1% AP。
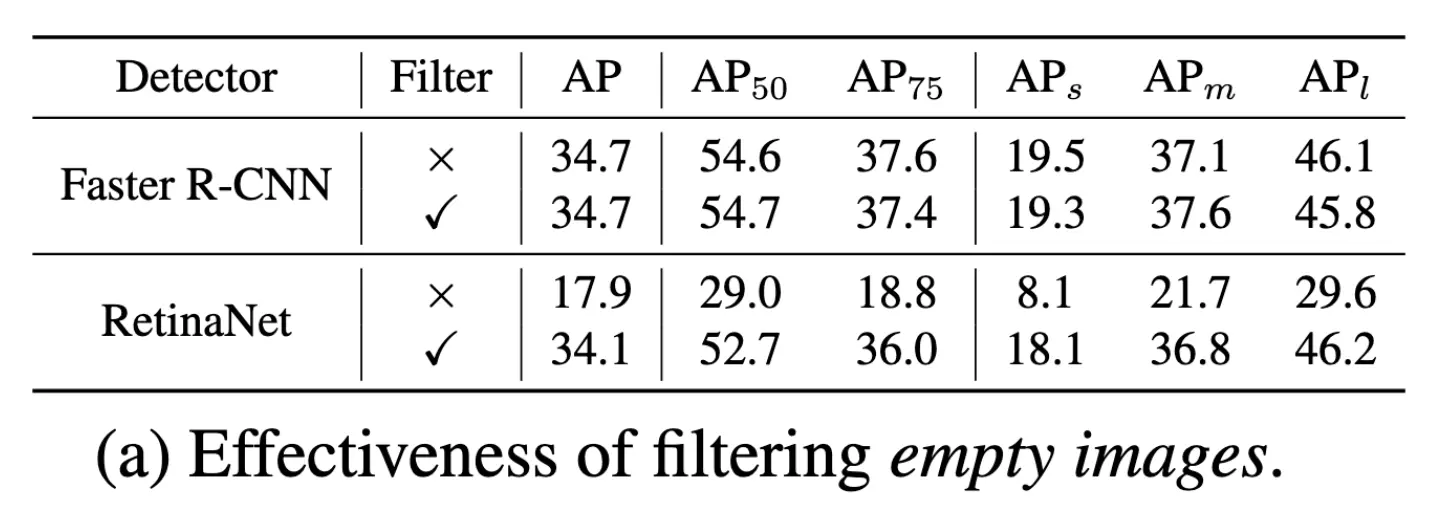
平衡伪标签的精度和召回率
作者研究了使用过滤空图像策略来稳定训练的影响。RetinaNet 和 Faster R-CNN 各自具有其最优置信度阈值,其偏差会导致明显的性能下降。结果表明,对于 MeanTeacher 的有效性,需要一个合适的置信度阈值,这与特定的分类损失函数有关。
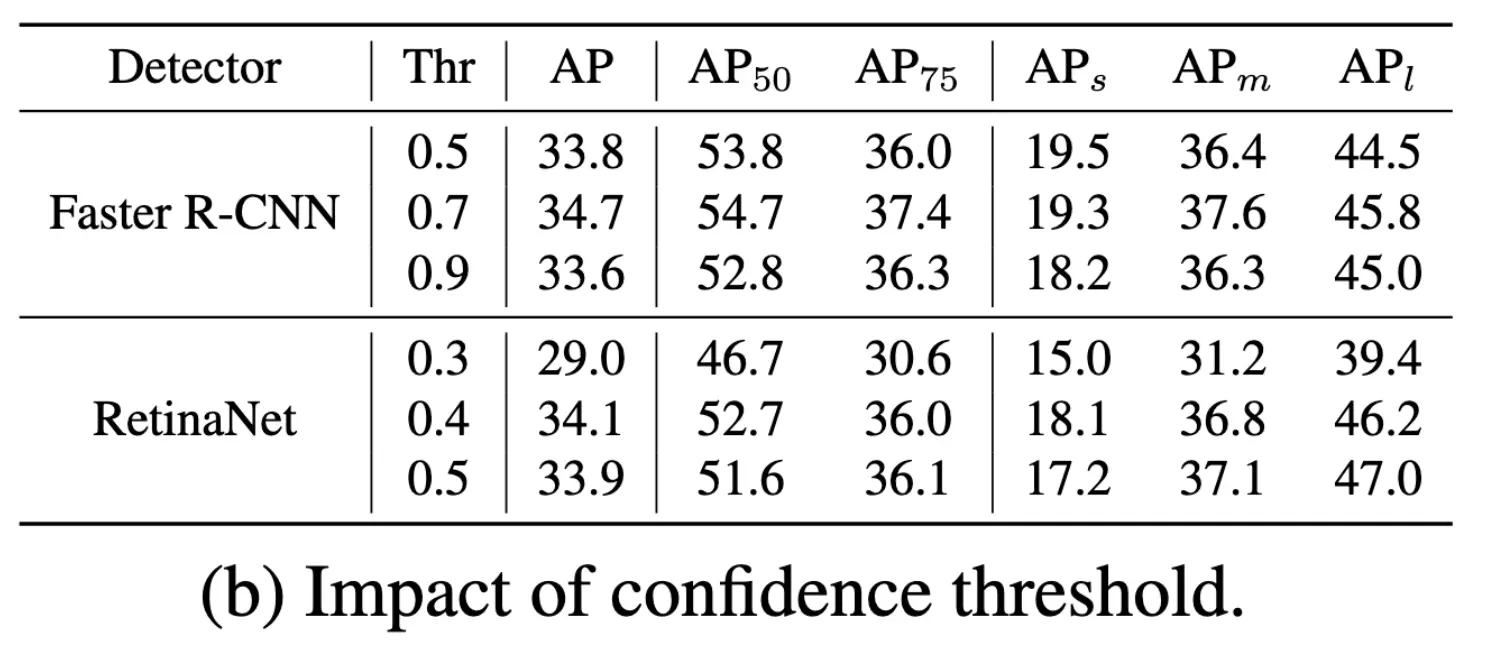
平衡标注数据和未标注数据的学习
作者研究了 MeanTeacher 中的的影响。观察到,在采用空图像过滤和较低置信度阈值时,RetinaNet 和 Faster R-CNN 的最优为2,而不是以前研究中使用的。
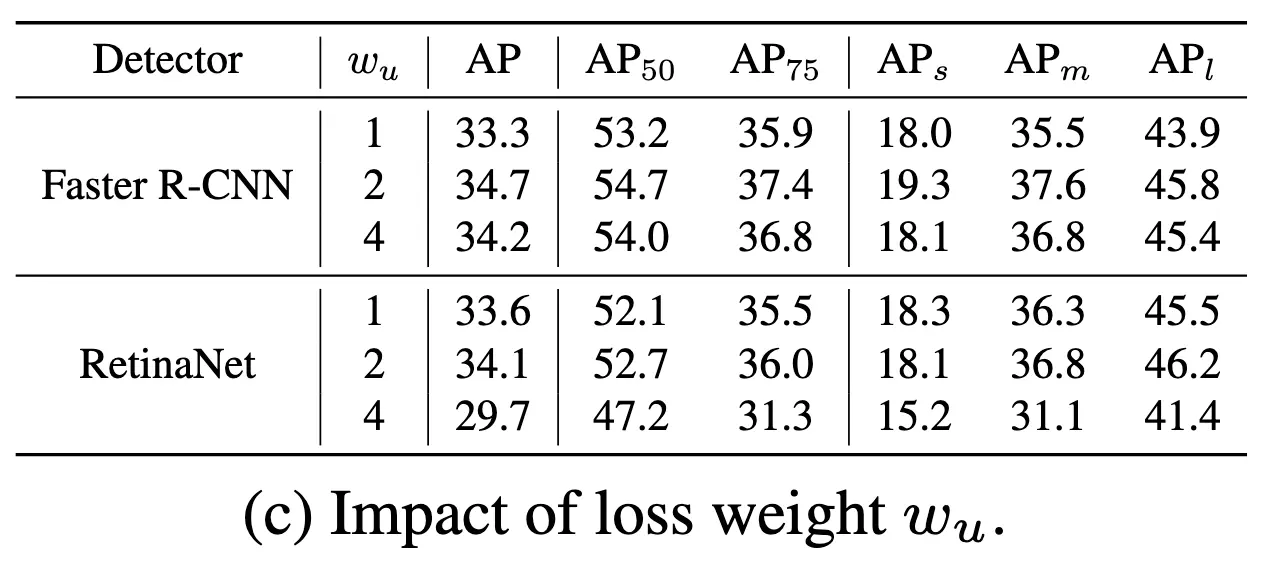
提出的修改导致了一个适用于 SSOD 的通用框架,称为 DetMeanTeacher,并采用了简单的策略来减少空图像的影响和伪标签的副作用。由于 DetMeanTeacher 简单而有效,与采用更复杂的设计的现有 SSOD 方法相比,在比较中具有竞争力。因此,作者将检测器与半监督学习框架解耦,使作者能够根据 DetMeanTeacher 观察到各种检测器之间伪标签与 GT 之间的差异的一致性。这一洞察启发了 MixPL 与标记重采样方法的提出。
Mixed Pseudo Labels
DetMeanTeacher 的研究促使作者考虑伪标签中的遗漏检测,因为空图像可以被视为遗漏检测的极端案例,意味着遗漏了所有目标。因此,置信度阈值在一定程度上反映了遗漏检测的程度,而旨在确保遗漏检测的干扰小于监督学习的信号。遗漏检测的内在原因是前景-背景不平衡,导致模型倾向于将样本分类为背景。同时,由于模型在检测小目标和尾部类别目标方面的不足,遗漏检测集中在这些元素上。
因此,作者提出了Mixed Pseudo Labels(MixPL),包括 Pseudo Mixup 和 Pseudo Mosaic,以消除错误负样本的负面影响并补充小和中型目标的训练样本。此外,作者还提出标记重采样有助于MixPL显著提高尾部类别的检测性能。
Pseudo Mixup
如 DetMeanTeacher 中所分析的,置信度阈值过滤了预测的置信度较低的边界框,这使得伪标签遗漏了一些感兴趣的目标,并在将阳性样本优化为阴性样本时,对模型的训练产生了持续的干扰。
考虑到遗漏检测是由于前景和背景样本之间的不平衡导致的,作者提出了 Pseudo Mixup。作者利用这种不平衡将两个伪标签图像叠加并合并它们的伪标签,确保一个阳性样本更有可能与一个阴性样本叠加。然后,由于阴性样本被叠加,因此这部分样本的整体负效应将显著降低。此外,作者还发现 Pseudo Mixup 可以作为引入强健扰动的有效手段,为准确的正样本增加梯度响应,这对模型训练有益。
Pseudo Mosaic
仔细观察表 1b 表明,在增加阈值时,Faster R-CNN 的始终减少,而 RetinaNet 的和随着阈值的增加而持续增加。这与预测框的大小和置信度之间存在强烈的相关性。作者计算了不同大小边界框的平均得分。观察到,随着边界框大小的增加,边界框的平均得分也在增加。这种相关性最终使得伪标签中目标大小的分布显著偏离 GT 值。
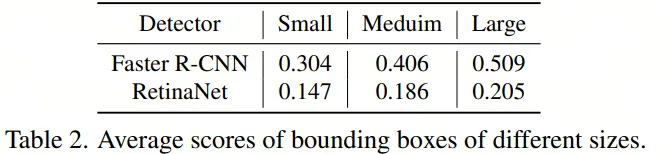
为了缓解这个问题,作者提出了 Pseudo Mosaic。具体来说,Pseudo Mosaic 选择4个伪标签图像并降低采样率,然后将它们组合成1张图像,其中包含原始图像中的所有伪标签。这样做不仅将图像中的伪标签数量增加到4倍,还从原始图像中降采样出更多的小和中等目标。因此,伪标签中目标大小的分布更加平衡。
标记重采样
作者提出了一种称为标记重采样(Labeled Resampling)的方法。具体来说,标记重采样结合半监督学习场景,从标记数据中过采样尾部类别,从而显著提高尾部类别的准确性。检测器从未标注数据中挖掘足够的 Head 类别伪标签,以平衡标记数据中 Head 类别的采样不足,从而提高所有类别上的模型性能。该过程如下所述。
首先,计算包含每个类别的标记数据的分数。然后,计算类别级重复因子,是一个超参数,值在。最后,计算每个图像的成像级重复因子。
实现方法
MixPL 在 DetMeanTeacher 获得强增强的未标注图像后应用。由于 MixPL 需要更多的伪标签图像进行混合,在每个迭代中,当前批次的未标注图像与来自伪标签缓存中最近一次迭代中采样的图像混合。例如,在每次训练迭代中,有1个标记图像和4个未标注图像。首先,从伪标签缓存中采样4个带有伪标签的新图像,并使用 Pseudo Mixup 获得4个混合图像。然后,作者使用 Pseudo Mosaic 随机组合8个图像中的4个,形成1个混合图像。这5个混合图像用于替换原始的4个未标注图像并训练学生模型。
分析
作者从梯度和正则化的角度分析了MixPL,揭示了该方法的有效性。
梯度
作者通过分析样本的梯度密度来揭示 MixPL 与弱增强和强增强的比较,具体而言,给定阈值过滤后的伪标签图像,伪标签图像通过弱增强、强增强、Pseudo Mixup 或 Pseudo Mosaic进行增强。然后,作者将增强后的伪标签图像输入到 RetinaNet 的学生模型中,并计算样本的梯度密度。梯度来自以下4种类型的样本,根据伪标签和真实值的分配结果,即True Positive (TP)、False Positive (FP)、True Negative (TN)和False Negative (FN)。
TP 和 TN 表示基于伪标签和真实值的样本分配是一致的,其梯度是干净且理想的,对于学生模型有益。相反,FP 和 FN 的样本是由于错误的伪标签导致的,它们将贡献导致错误优化的梯度。作者分析 TP 和 FN 的梯度密度,这暗示了伪标签中正确和错误目标的梯度密度。
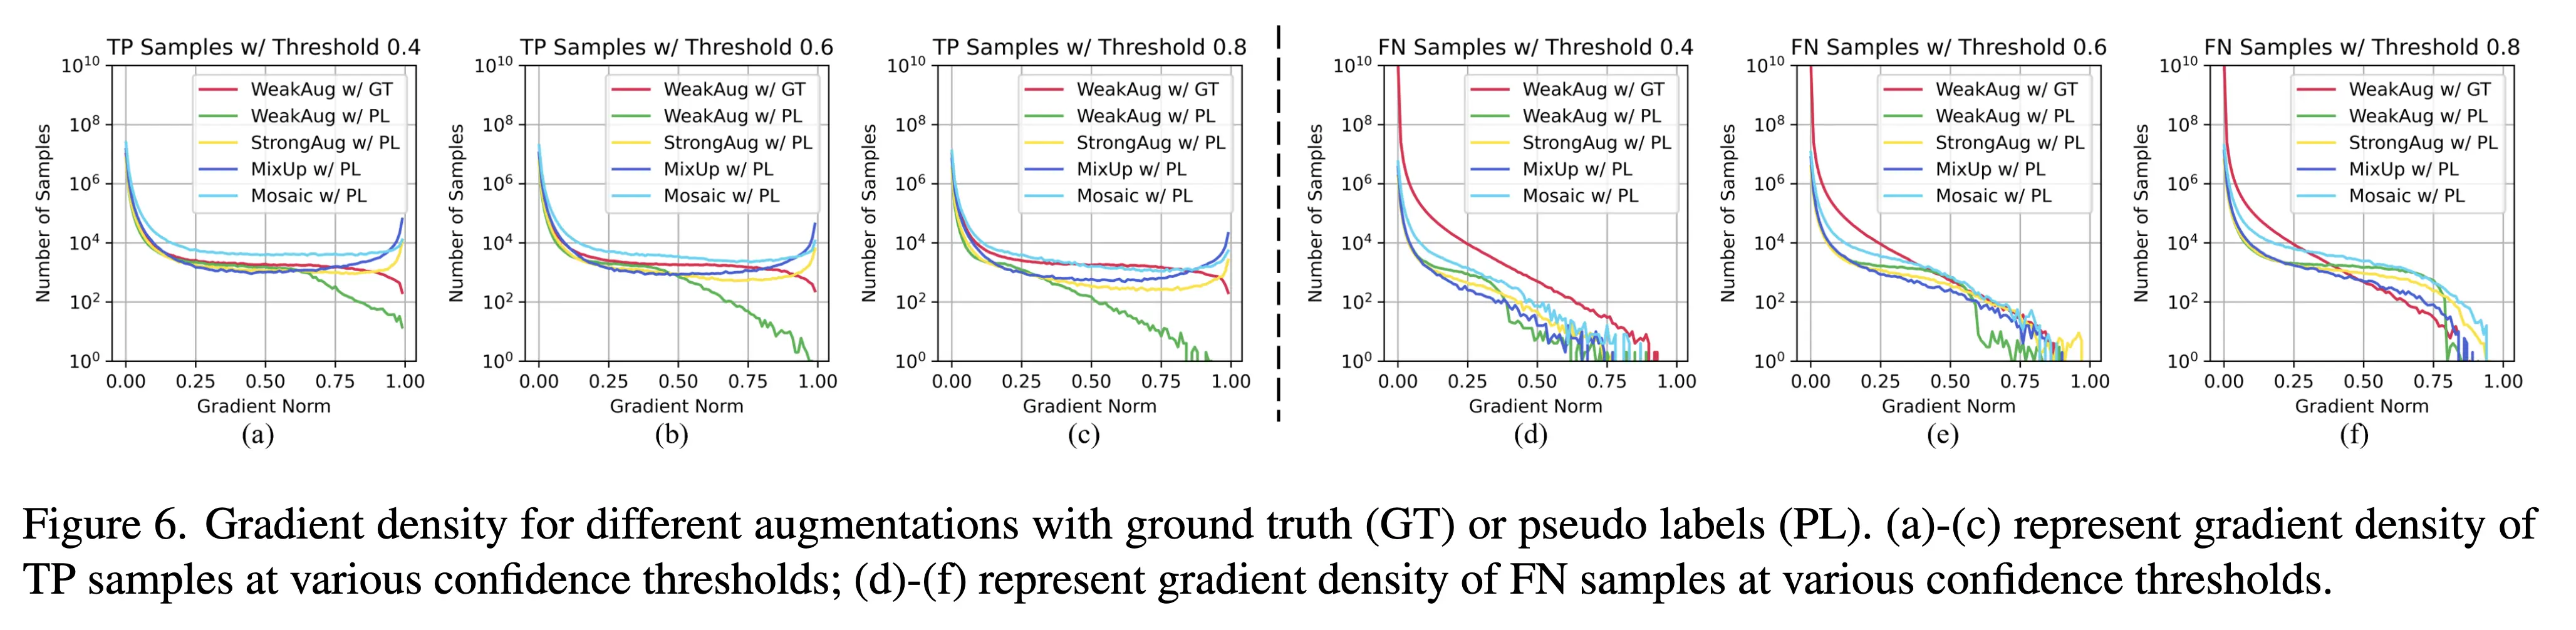
作者首先分析 Pseudo Mixup 的有效性,通过比较增强方法。当阈值增加时,伪标签中的阳性样本数量逐渐减少,导致 TP 的梯度密度逐渐减小。在这种情况下,如果使用弱增强,高范数的梯度密度会显著减小,说明弱增强不能像强增强那样用于训练学生模型。
相反,Pseudo Mixup 的梯度密度高于强增强,尤其是在高范数和高阈值区域。这种趋势验证了 Pseudo Mixup 在提供更多阳性样本方面的有效性,并在提供硬阳性示例方面优于强增强。首先,由于插值两个图像最终会使混合图像中的目标难以检测,Pseudo Mixup 不仅在 TP 中提供硬阳性示例,还减弱了缺失预测(FN)的影响。随着错漏目标的增加,Pseudo Mixup 的 FN 的梯度密度显著低于强增强,这意味着Pseudo Mixup 在减少伪标签中缺失目标的副作用方面具有优势。
过程
- 学生模型拿到有标签数据计算 loss 并进行 reweight_loss(权重为1)
- 教师模型拿到弱增强无标签数据得到伪标签
- 强增强无标签输入(image)不动,将强增强无标签数据覆盖为伪标签数据,并过滤伪标签框较小的实例
- erase 增广强增强无标签数据
- 从缓存中拿强增强无标签数据进行 mixup 增广
- 过滤置信度低的增强无标签数据
- 学生模型拿到强增强无标签数据计算 mixup 的无监督 loss
- 如强增强无标签数据实例为空,将此 loss 的权重置 0,否则为 2
- 从缓存中拿强增强无标签数据进行 mosaic 增广
- 过滤置信度低的增强无标签数据
- 学生模型拿到强增强无标签数据计算 mosaic 的无监督 loss
- 如强增强无标签数据实例为空,将此 loss 的权重置 0,否则为 1
- 将强增强无标签数据放置到缓存中
- 结束