MaTVLM: Hybrid Mamba-Transformer for Efficient Vision-Language Modeling
引言
随着RNN模型的线性复杂度优势逐渐显现,Transformer的二次复杂度问题有望被克服。Mamba-2作为新兴的RNN模型,已经在长序列任务中展现出与Transformer相媲美的性能。然而,RNN模型的顺序处理和梯度消失问题限制了其在长距离依赖捕捉上的能力,导致收敛速度慢、资源需求高,且在下游理解和复杂推理任务中表现不佳。本文提出了一种名为MaTVLM的混合模型,通过将预训练VLM中的部分Transformer解码器层替换为Mamba-2层,结合注意力机制与Mamba-2的内在联系,加速了模型的收敛速度,并通过单阶段蒸馏过程进一步提升了性能。
问题背景及相关工作
近年来,视觉语言模型(Vision-Language Models, VLMs)在多个领域取得了显著进展。这些模型通常基于Transformer架构,但由于Transformer的二次复杂度问题,VLMs在训练和推理过程中计算开销巨大。为了解决这一问题,研究者们开始探索基于RNN(Recurrent Neural Network)的模型,尤其是Mamba-2,它在长序列任务中表现出色,计算效率甚至超越了Transformer。
然而,Mamba-2虽然效率高,但其顺序处理和梯度消失问题限制了其在长距离依赖捕捉上的能力,导致模型在复杂推理任务中表现不佳。为此,本文提出了一种名为MaTVLM的混合模型,通过将预训练VLM中的部分Transformer解码器层替换为Mamba-2层,结合注意力机制与Mamba-2的内在联系,加速了模型的收敛速度,并通过单阶段蒸馏过程进一步提升了性能。
方法概述
MaTVLM的核心思想是将Mamba-2与Transformer结合,利用Mamba-2的线性复杂度优势,同时保留Transformer的全局上下文捕捉能力。具体来说,MaTVLM在预训练的VLM基础上,替换了部分Transformer解码器层为Mamba-2层,并通过知识蒸馏的方式,将预训练VLM的知识迁移到MaTVLM中。
为了加速Mamba-2层的收敛,MaTVLM采用了注意力权重初始化策略,将Mamba-2层的权重初始化为对应Transformer层的注意力权重。此外,MaTVLM还引入了单阶段蒸馏过程,通过概率分布蒸馏和层间蒸馏损失,进一步提升了模型的性能。
核心设计
MaTVLM的核心设计在于将Mamba-2与Transformer结合,利用Mamba-2的线性复杂度优势,同时保留Transformer的全局上下文捕捉能力。具体来说,MaTVLM在预训练的VLM基础上,替换了部分Transformer解码器层为Mamba-2层,并通过知识蒸馏的方式,将预训练VLM的知识迁移到MaTVLM中。
为了加速Mamba-2层的收敛,MaTVLM采用了注意力权重初始化策略,将Mamba-2层的权重初始化为对应Transformer层的注意力权重。此外,MaTVLM还引入了单阶段蒸馏过程,通过概率分布蒸馏和层间蒸馏损失,进一步提升了模型的性能。
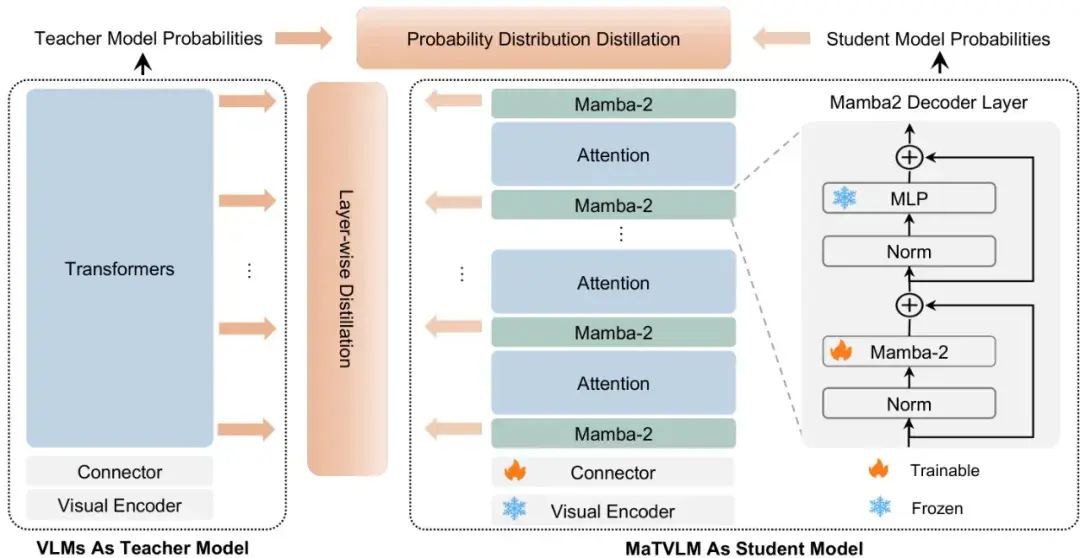
论文主体思路
MaTVLM的核心思路是通过将Mamba-2与Transformer结合,利用Mamba-2的线性复杂度优势,同时保留Transformer的全局上下文捕捉能力。具体来说,MaTVLM在预训练的VLM基础上,替换了部分Transformer解码器层为Mamba-2层,并通过知识蒸馏的方式,将预训练VLM的知识迁移到MaTVLM中。
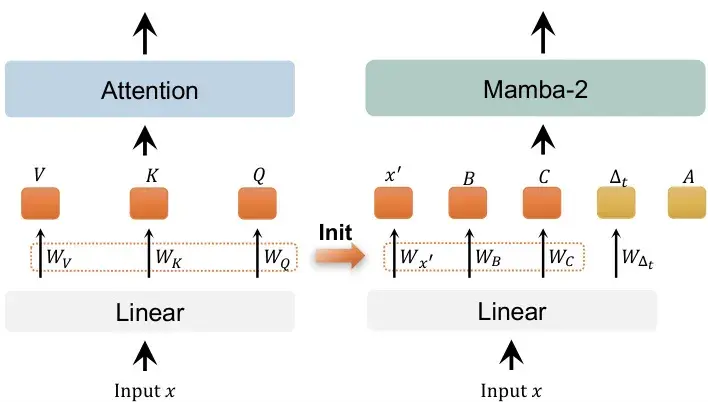
为了加速Mamba-2层的收敛,MaTVLM采用了注意力权重初始化策略,将Mamba-2层的权重初始化为对应Transformer层的注意力权重。此外,MaTVLM还引入了单阶段蒸馏过程,通过概率分布蒸馏和层间蒸馏损失,进一步提升了模型的性能。
主要创新点
- MaTVLM首次将Mamba-2与Transformer结合,既保留了Transformer的全局上下文捕捉能力,又利用了Mamba-2的线性复杂度优势。
- MaTVLM通过单阶段蒸馏过程,将预训练VLM的知识迁移到MaTVLM中,显著提升了模型的收敛速度和性能。
- MaTVLM通过将Mamba-2层的权重初始化为对应Transformer层的注意力权重,加速了Mamba-2层的收敛。
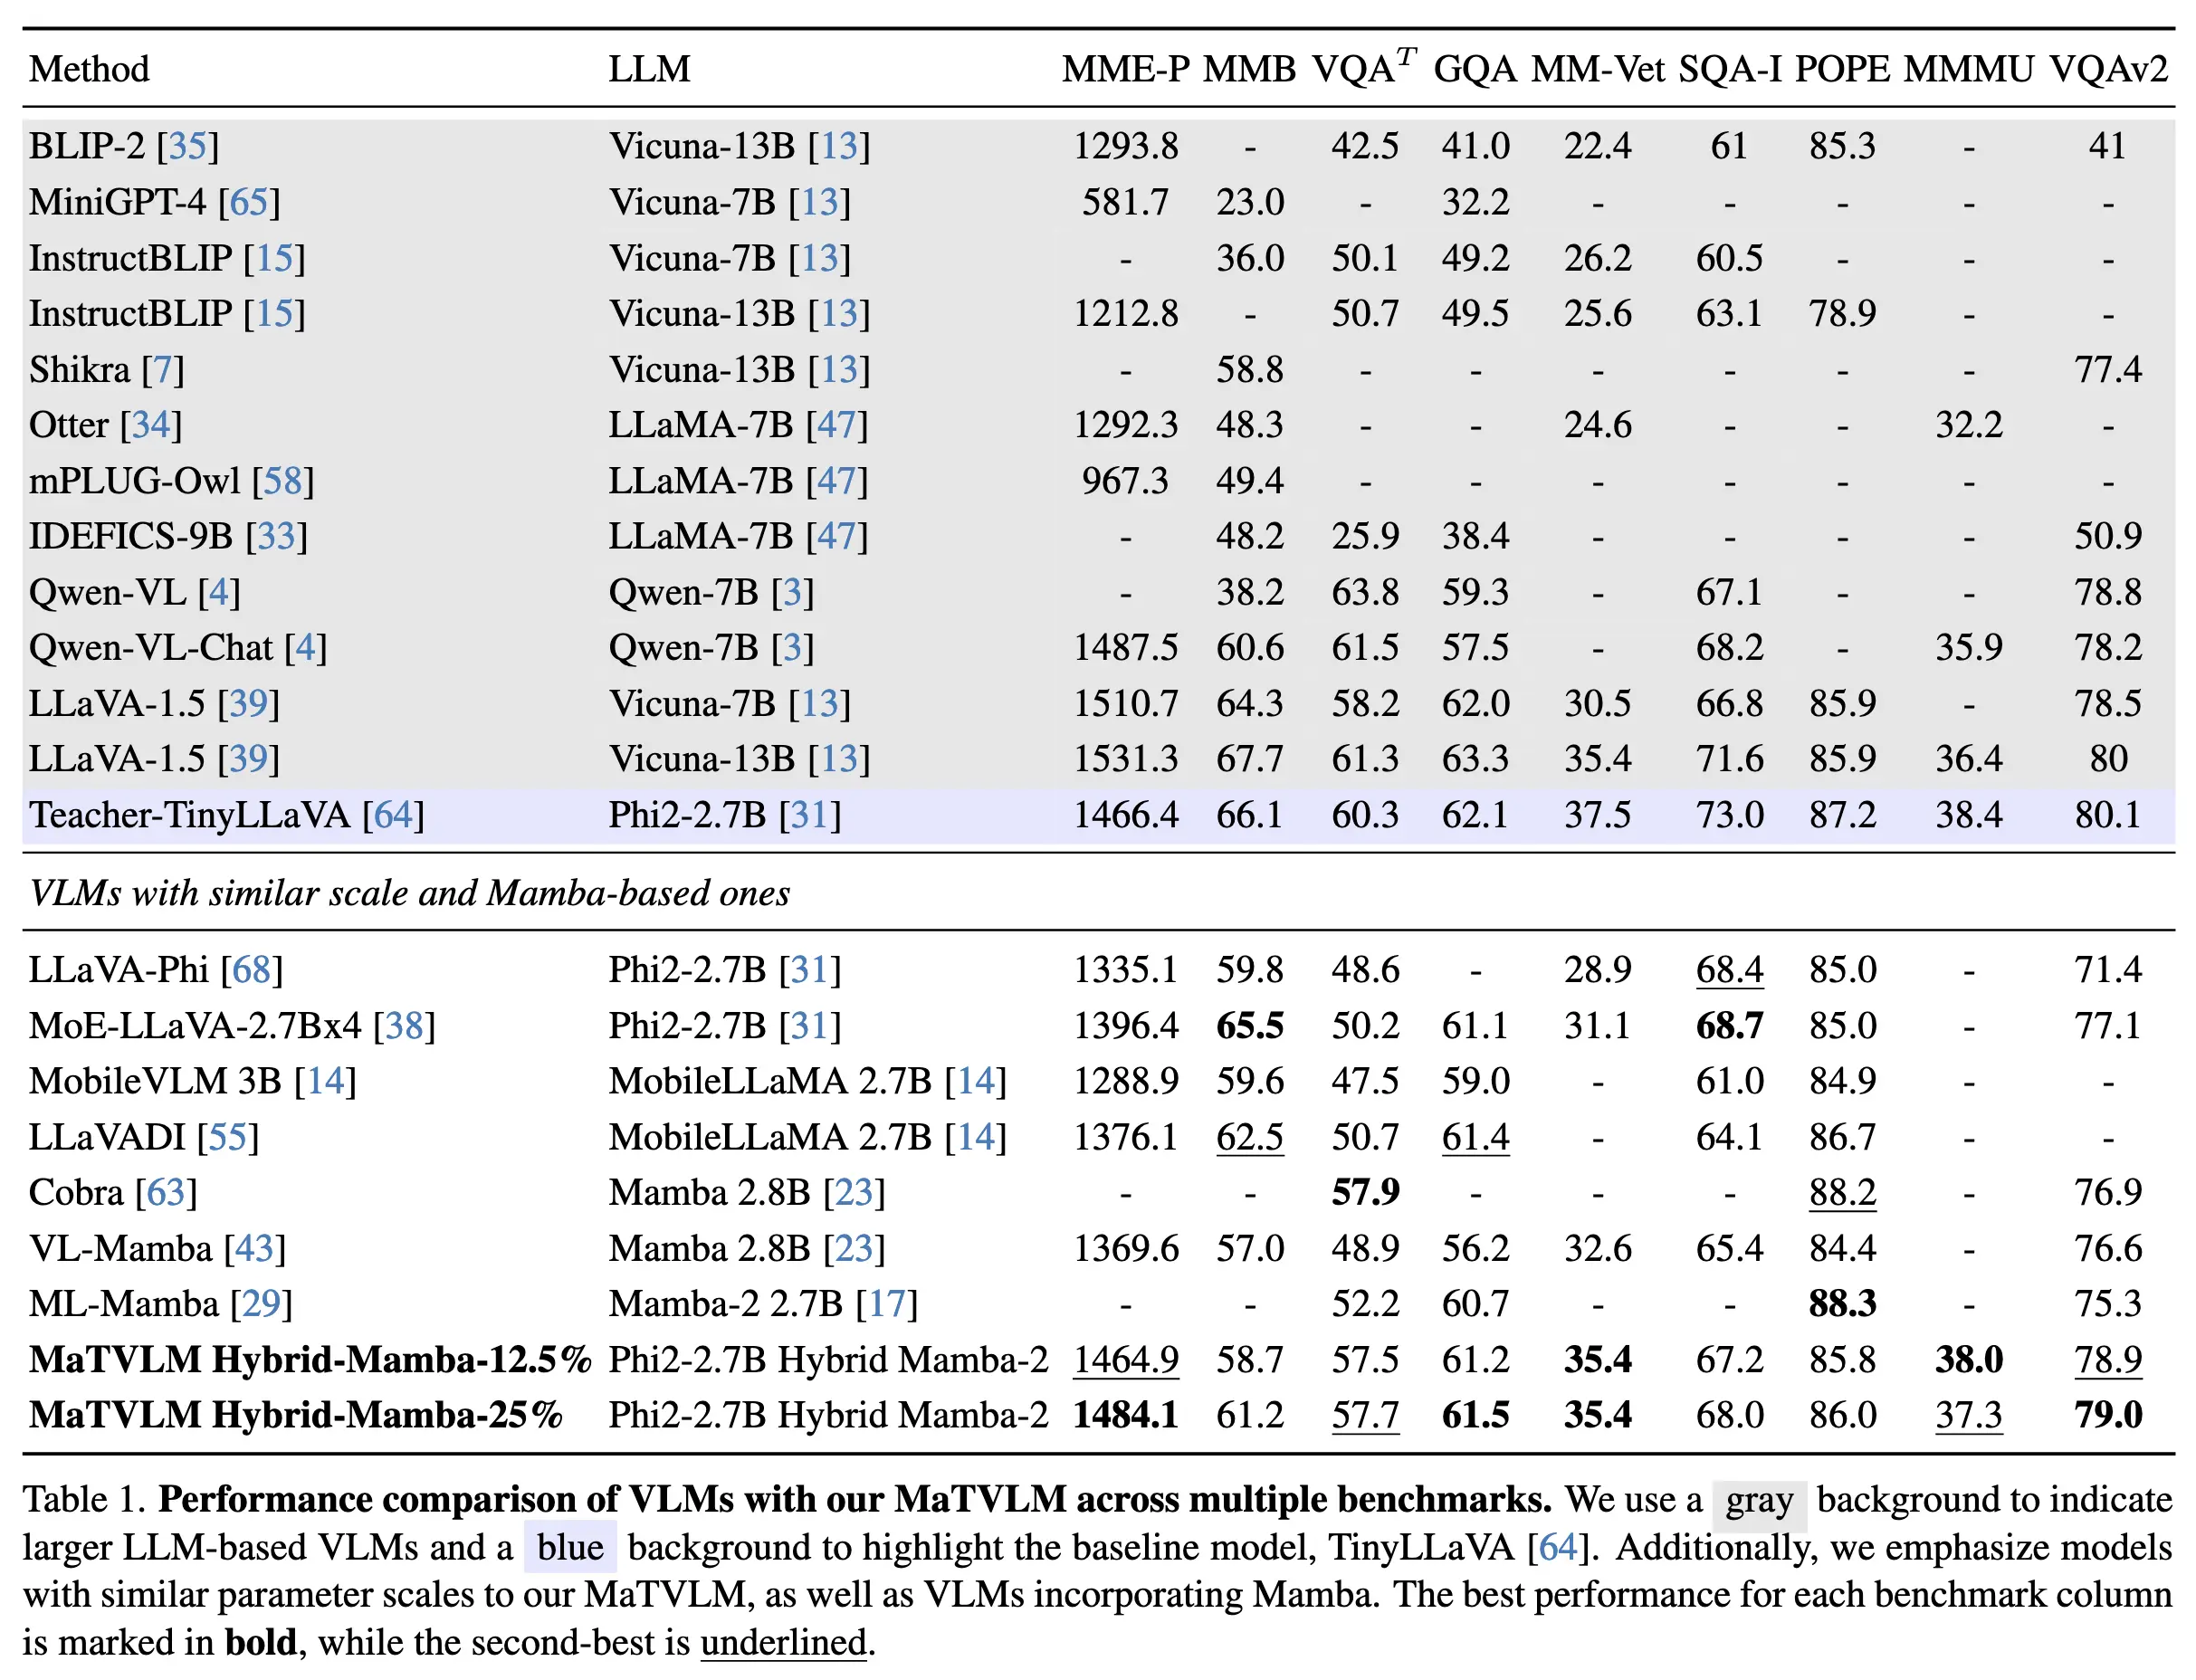
实验