HUWSOD: Holistic Self-training for Unified Weakly Supervised Object Detection
The Proposed Method
The Preliminary
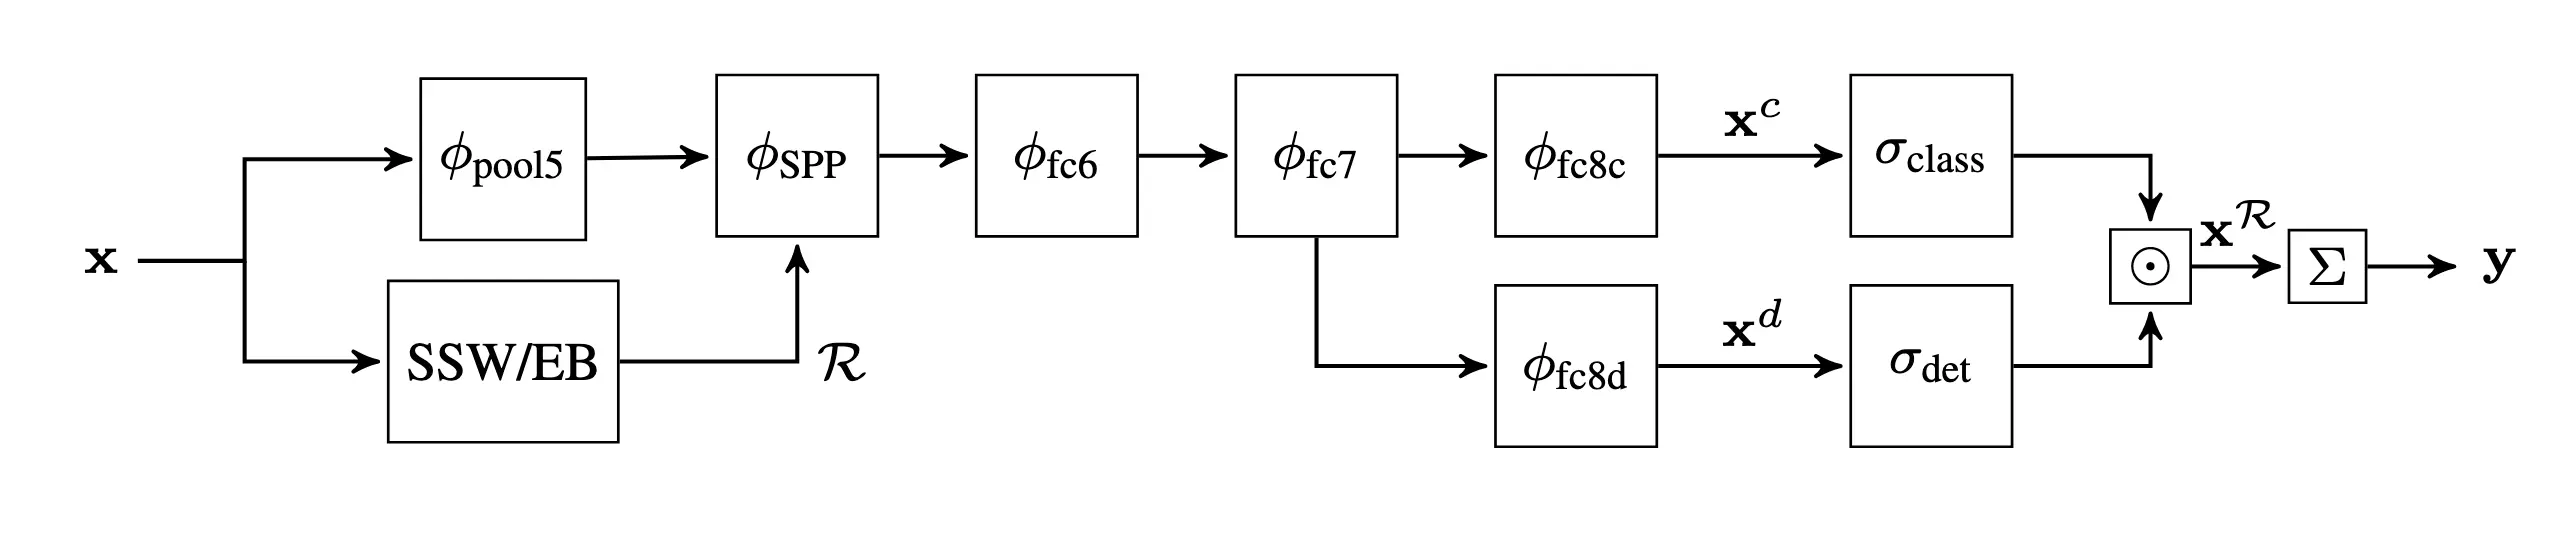
基本的 WSOD 方法: 给定输入图像后,大多数方法首先使用传统的 Proposal 算法,如 Selective Search 和 Edge Boxes,来提取候选边界框。然后,通过 RoIPool 层,从 Backbone(如 VGG 和 DRN)的最后一层得到的图像特征图 F 上计算相应的 Proposal 特征。最后,这些 Proposal 特征被送入 WSOD Head,其中包括对象挖掘和实例细化。
对象挖掘阶段将 Proposal 特征分为分类流和检测流,分别通过两个全连接层产生两个得分矩阵。和 分别表示对象 Proposal 和类别(Categories)的数量。两个得分矩阵分别通过类别和 Proposal 的 Softmax进行归一化:和 。这样,估计第 p 个 Proposal 属于第个类别的概率,表示第个 Proposal 对图像被归入第个类别的贡献。因此,我们将解释为预测类别的项,而则选择区域。然后,这两个数据流输出的元素乘积又是一个得分矩阵:。这个等式可视为用定位得分对分类结果进行再加权。为了获得图像级分类得分,我们采用了总和池化方法:。请注意,是所有区域 Softmax 归一化分数的元素乘积的加权和,范围在之间。我们建立了二元交叉熵目标函数的计算公式如下:
其中是图像级标签,是第 c 个类别的对象是否出现在输入图像中的真实标签。
对象挖掘阶段将 WSOD 问题形成为多实例学习(Multiple-Instance Learning - MIL),并隐含地仅使用图像级标签对区域 Proposal 进行分类。这样,即使模型只 “看到 ”对象的一部分,也能对图像进行正确分类,但因此,Proposal 得分可能无法正确表明 Proposal 正确覆盖目标类别整个对象的概率。
为了进一步减少实例细化中的定位错误,我们调整了实例细化和边界框回归的类似思路,以减少分类熵并调整对象位置。为此,实例细化包含多个分支,每个分支都有 Proposal 分类和边界框回归网络,从而实现边界框分数和坐标的细化。具体来说,它为第 r 个细化头生成新的分类分数和边界框,其中表示对象类别和 1 个背景。
在训练过程中,我们利用第个分支的检测结果,为第个分支中的 Object Proposal 生成分类标签和回归目标。注意,我们利用对象挖掘阶段的得分矩阵来监督第一个分支,即。具体来说,对于的第个类别,我们会选择之前预测的类别置信度大于预定义阈值(即 0.5)的所有方框作为伪GT值。特别是,如果没有选中任何方框,我们会寻找得分最高的方框。有了上述伪GT值框,我们为每个 Proposal 分配正/负标签,并按照 Faster R-CNN 的方法形成训练目标和回归目标。因此,相应的目标函数为:
其中,是实例细化中的分支数是 Softmax 交叉熵损失函数,是平滑 L1 损失函数。如果,指示括号中的指示函数的值为 1,否则为 0。注意,表示背景类别。从半监督学习的另一个角度来看,实例细化利用了来自教师(即对象挖掘阶段)的噪声预测,并学习学生检测器。因此,它的工作原理是从当前预测中选择伪 GT 值,并通过分类和回归迭代学习新的检测分支。从弱监督中推断出的建议得分会传播到空间重叠的 Proposal 中,以校准分类器。在测试中,使用所有分支的平均输出。
The HUWSOD Framework
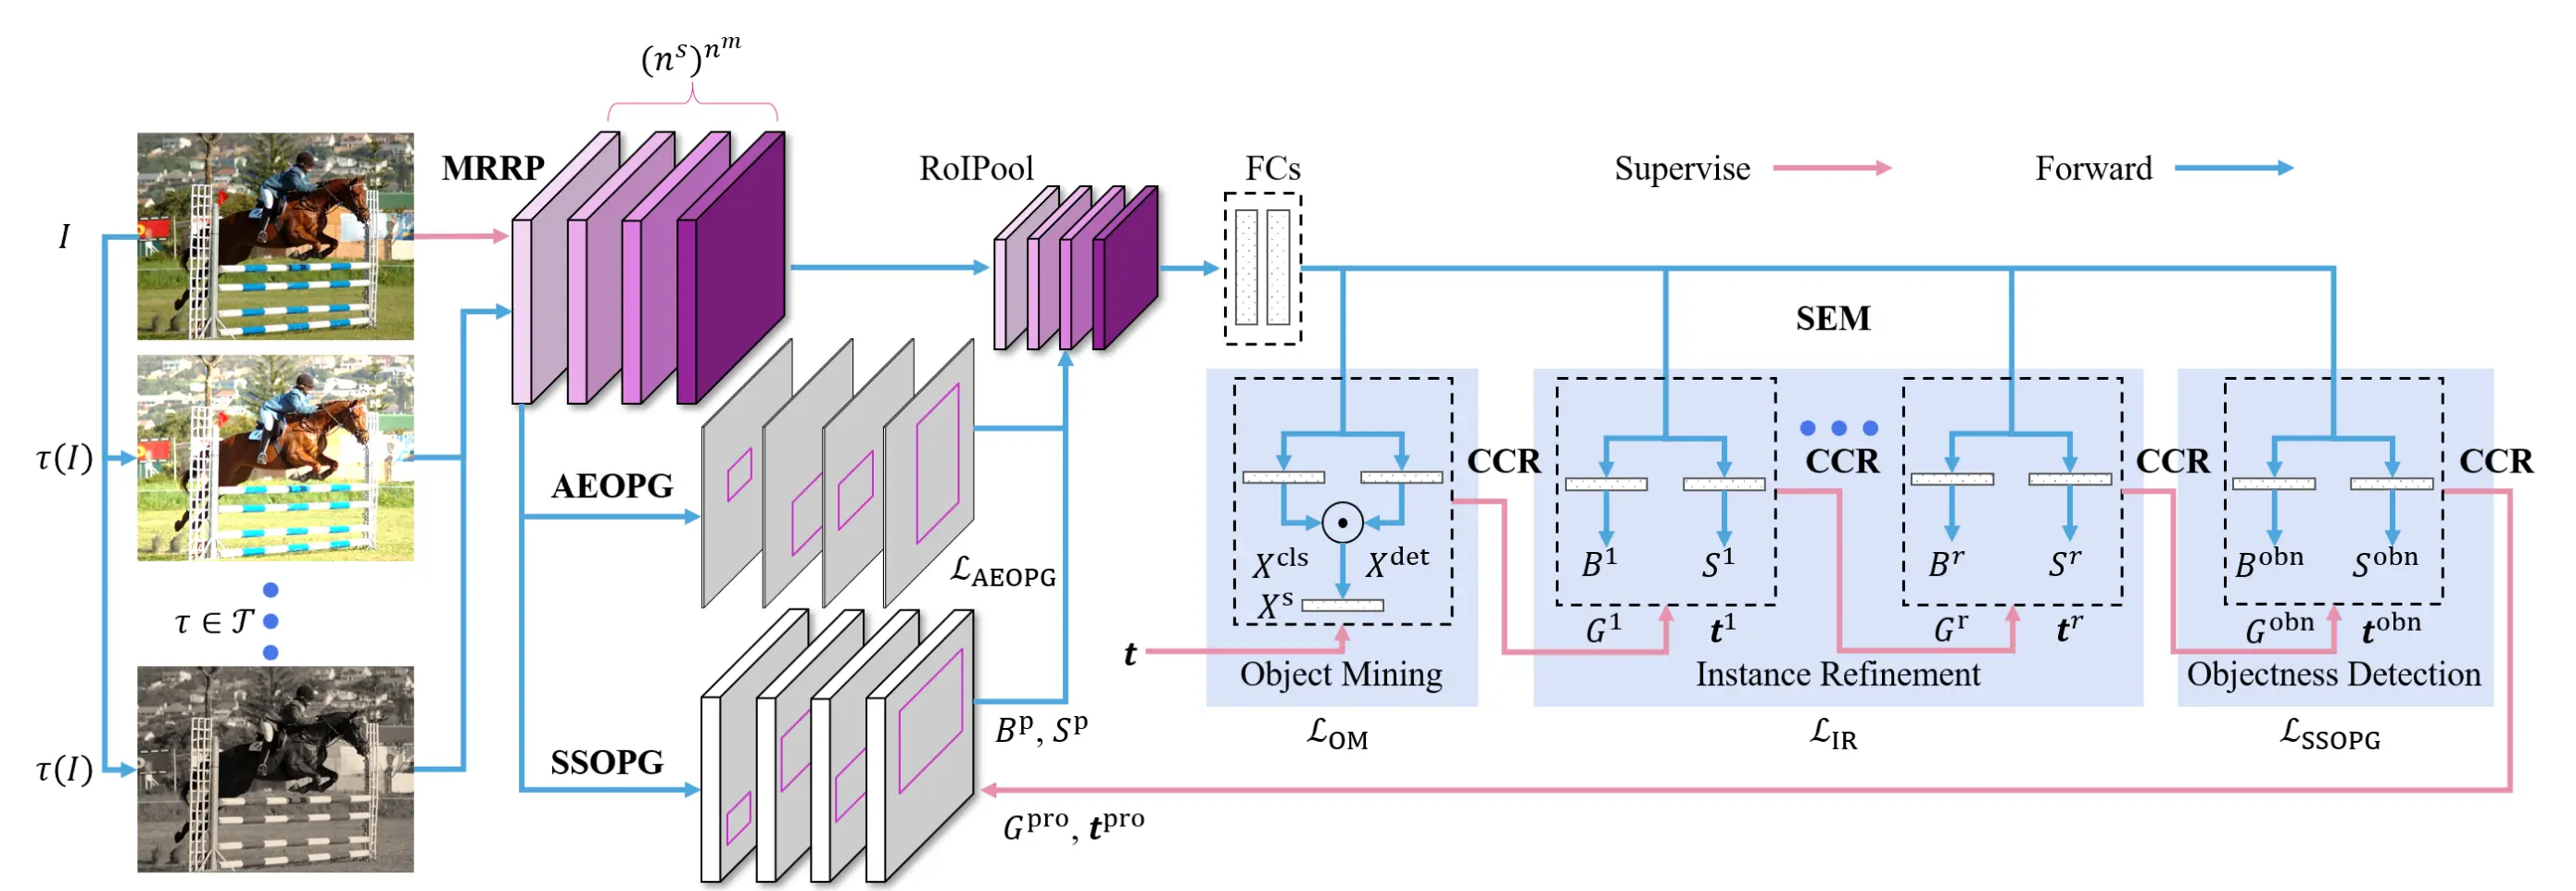
基于上述基本框架,我们去掉了传统的 Object Proposal 的外部模块,以完全端到端的方式构建了可学习的 Object Proposal 生成器。然后,我们在 Backbone 和 WSOD 头之间构建了网络嵌入式特征层次结构,以处理大尺度的变化。最后,我们提出了一种整体的 Self-Training 方案,以取代普通的伪标签训练。
提出的 HUWSOD 整体框架如上图所示。首先,给定一幅输入图像,分别对其应用常规增强和强增强,然后用Multi-Rate Resampling Pyramid(MRRP)从 Backbone 图像中提取尺度不变的全图像特征图。MRRP 在 Backbone 的顶端聚合多尺度的上下文信息,利用一组不同的感受野来解决尺度变化问题。
其次,Self-Supervised Object Proposal Generator(SSOPG)和 Autoencoder Object Proposal Generator(AEOPG)同时预测一组高质量和高置信度的 Object Proposal,然后由 RoIPool 层生成 Proposal 特征。SSOPG 从 HUWSOD 的最终预测中学习 Object Proposal 区域,而 AEOPG 则通过建模低秩近似来捕捉图像中的突出对象,从而保留全图像特征图中的重要值和相关关系。
最后,对象挖掘阶段会输出初始检测分数,而多分支实例细化阶段则会细化 Proposal 的分数和坐标,以引导预测结果的质量。
因此,我们的模型是一个统一的 WSOD 网络,具有严格的端到端训练和推理功能,即使在全/半监督设置下也能取得可喜的结果。总体损失函数为:
其中和是所提出的 SSOPG 和 AEOPG 的损失函数,将在下面的小节中详细介绍。
SEM Self-Training 为伪学习提供了一个逐步最小化实例细化预测熵的程序,旨在考虑不同细化分支中精度和召回率之间的权衡。而 CCR Self-Training 则对输入图像的随机增强所产生的预测结果施加一致性约束正则化。因此,我们的方案是一个用于 WSOD 的整体自训练框架,它融合了 弱监督学习的主流范式的思想,即熵最小化、一致性正则化和指数移动平均。在推理过程中,提出的 AEOPG、SEM 和 CCR 自训练被安全地移除,基本 WSOD 网络只保留了 MRRP 和 SSOPG。