A Comprehensive Survey of Few-shot Learning: Evolution, Applications, Challenges, and Opportunities
概念
什么是小样本学习(Few-Shot Learning)?
FSL(Few-Shot Learning)概念受启发于人类的稳健推理和分析能力,广泛应用于边缘计算场景。其定义为:如果一个计算机程序在上的性能通过来衡量,而又能提高的性能,那么就可以说它在某些类别的任务和性能指标上从经验中学习。值得一提的是,FSL 中的非常小。
人类记忆系统中,参数慢速学习新皮质系统和非参数快速海马学习系统,分别对应 FSL 的基于数据的慢速学习和基于特征的快速学习。
N-way-K-shot 问题
该问题用于描述FSL遇到的具体问题。
在这种情况下,Support Set 代表训练阶段使用的小数据集,它为测试的第二阶段生成参考信息。Query Set 是模型实际需要预测的任务。请注意,Query Set 中的类永远不会出现在 Support Set 中。
经典的 N-way-K-shot 表示 Support Set 有个类别,每个类别有个样本,那么整个任务只有个样本。因此,N-way-1-shot 代表单样本学习(One-Shot Learning),N-way-0-shot 代表零样本学习(Zero-Shot Learning)。
跨域小样本学习问题
跨领域的概念源于迁移学习(Transfer Learning),是指将源领域的知识迁移到目标领域。这些域之间通常存在域间隙。跨域 FSL 融合了跨域和 FSL 的特点,是最近出现的一个具有挑战性的方向。
挑战
数据分布评估不准确
由于成本、道德、法律或其他原因,FSL 无法获取大型数据集。因此,依靠少量样本进行学习会在估计实际数据分布时产生偏差,这对某些任务来说可能是致命的。因此,如何在信息有限的情况下最大限度地探索数据分布成为 FSL 面临的最大挑战。数据增强是解决 FSL 估计不准问题的直接方法。目前的主要工作集中在探索可迁移的类内或类间特征,以及使用生成器定制特定图像。
重用特征敏感性
通过对大规模辅助数据集进行采样,不断积累先验知识。迁移学习可以轻松地将其从源领域应用到相似的目标领域。预训练的目的是通过特征提取器提取高维特征向量,而微调的目标是对预训练的初始参数进行微调。迁移学习侧重于数据层面,通过将数据映射到标签,获得独立于任务的更有价值的特征。它在优化特定任务方面表现突出,但一般受限于当前任务的特征,对未来任务的泛化能力较差。特别是当领域发生较大变化时,如果不对特征进行过滤和对齐,可能会导致知识的负迁移。
未来任务的泛化
与迁移学习不同,元学习(Meta Learning)通过对任务和数据进行双重采样,学会在以前未见过的任务中快速建立从已知任务到目标模型的映射。在 FSL 中,通过探索任务空间,总结不同任务中的元知识,可以以较低的成本快速聚合未见过的任务。作为一种通用学习框架,元学习独立于具体问题,更面向未来任务,而不是优化当前任务。然而,元学习只有在测试任务和训练任务相对相似时才被证明有效,而且元学习高度依赖于网络结构,缺乏灵活性。当同时用一组任务训练元学习器时,甚至很难适应任务的分布,需要重新设计网络结构。
单模态信息的缺陷
由于 FSL 本身具有信息局限性,因此很难有效地学习特征。如果能从其他模式中获取信息,这种情况就会得到很大程度的改善。在这方面,语义辅助是提供外部先验知识的绝佳方法,通过引入或生成语义信息作为弱监督,可以结合原始模型完成自适应分类。
什么是机器学习以及它与小样本学习有何不同?
机器学习使用大规模数据集作为输入,它对新样本的判断是基于历史数据提取的统计结果。因此,传统机器学习的性能很大程度上依赖于大数据集,因此在样本较少的情况下无法表现良好。
FSL 与传统机器学习最显着的区别在于 Support Set 和 Query Set 的类集是不相交的。在机器学习中,测试集的类预先包含在训练集中。FSL 将有限的监督信息与先验知识相结合来训练模型,模型的输入一般以任务的形式给出。通过不断收集任务,模型可以识别数据与任务之间的异同,当模型遇到未见过的任务时,只需使用适当的初始化参数进行几步迭代训练,就能快速完成知识转移。相比之下,传统的机器学习需要通过模型中的大规模数据集产生的损失函数进行优化。总之,FSL 只是机器学习中一个非常年轻的分支,主要解决机器学习场景中难以获得高质量数据集的问题。
什么是迁移学习以及它与小样本学习有何不同?
传统的迁移学习涉及将源领域学到的知识应用到不同但相关的目标领域。在 FSL 中,有限的训练数据量、领域变化和任务修改是导致模型无法很好地从源领域迁移到目标领域的关键因素。例如,一个与自然图像数据集 ImageNet 相似度较低的医学图像数据集,在没有相关专业知识的帮助下很难准确识别,即使是人类在仅有几张图像的指导下也是如此。当然,当源领域和目标领域相对相似时,它也是有效的。在 FSL 任务的末端,如果先验知识是通过预训练从其他任务或领域获得的,那么 FSL 就属于迁移学习,主要学习数据到标签的映射。
根据迁移学习的分类,FSL 问题有很多变体,包括 OSL(One-Shot Learning)、 ZSL(Zero-Shot Learning) 和 跨域小样本学习。
单样本学习 (One-Shot Learning) OSL 在 Support 数据集中的每个样本只有一个正确标签,其目的是在所见类别中找到最相似的类别作为匹配。在警方审讯过程中,这两个过程极其相似。证人只需看一眼嫌疑人,警方提供的照片就可视为查询图像。证人只需对这些照片回答 “是 “或 “否 “即可。同样,单次学习并不对数据进行具体分类,而只是按照相似度函数的顺序进行聚类。根据现有研究,单样本学习可分为两种主要方法。一种是利用生成模型来归类先验知识,其中贝叶斯编程学习是该领域最具代表性的框架。另一种方法是将 OSL 分类任务转换为验证任务。
零样本学习 (Zero-Shot Learning) 在没有任何查询样本的情况下,只能依靠推理机制来识别以前从未见过的样本。ZSL 主要是通过使用高维语义特征来替代低维原始数据。嵌入表示法和自动编码器是构建中间语义空间的最有效方法,中间语义空间包含的属性能更全面地定义类别。迄今为止,零样本学习是最接近人类智能的方法之一,它能识别以前未观察到的类别。单样本学习和 FSL 本质上可以视为特殊的 ZSL。
跨域小样本学习
在迁移学习中,目标域中的每一类都有足够多的可用样本,当源域和目标域之间发生较大的域转移时,知识迁移往往会变得非常具有挑战性。跨域小样本学习结合了迁移学习和 FSL 的挑战,在存在域间隙的情况下,源域和目标域中的类的交集是空的,而目标域中每个类的可用样本量极小。仅通过源域数据来提高模型的泛化能力给模型带来的性能非常有限。目前的工作主要集中在特征的转换和辅助数据集的构建上。交叉多域少点学习可以说是目前 FSL 领域最具挑战性的背景之一。
什么是元学习以及它与小样本学习有何不同?
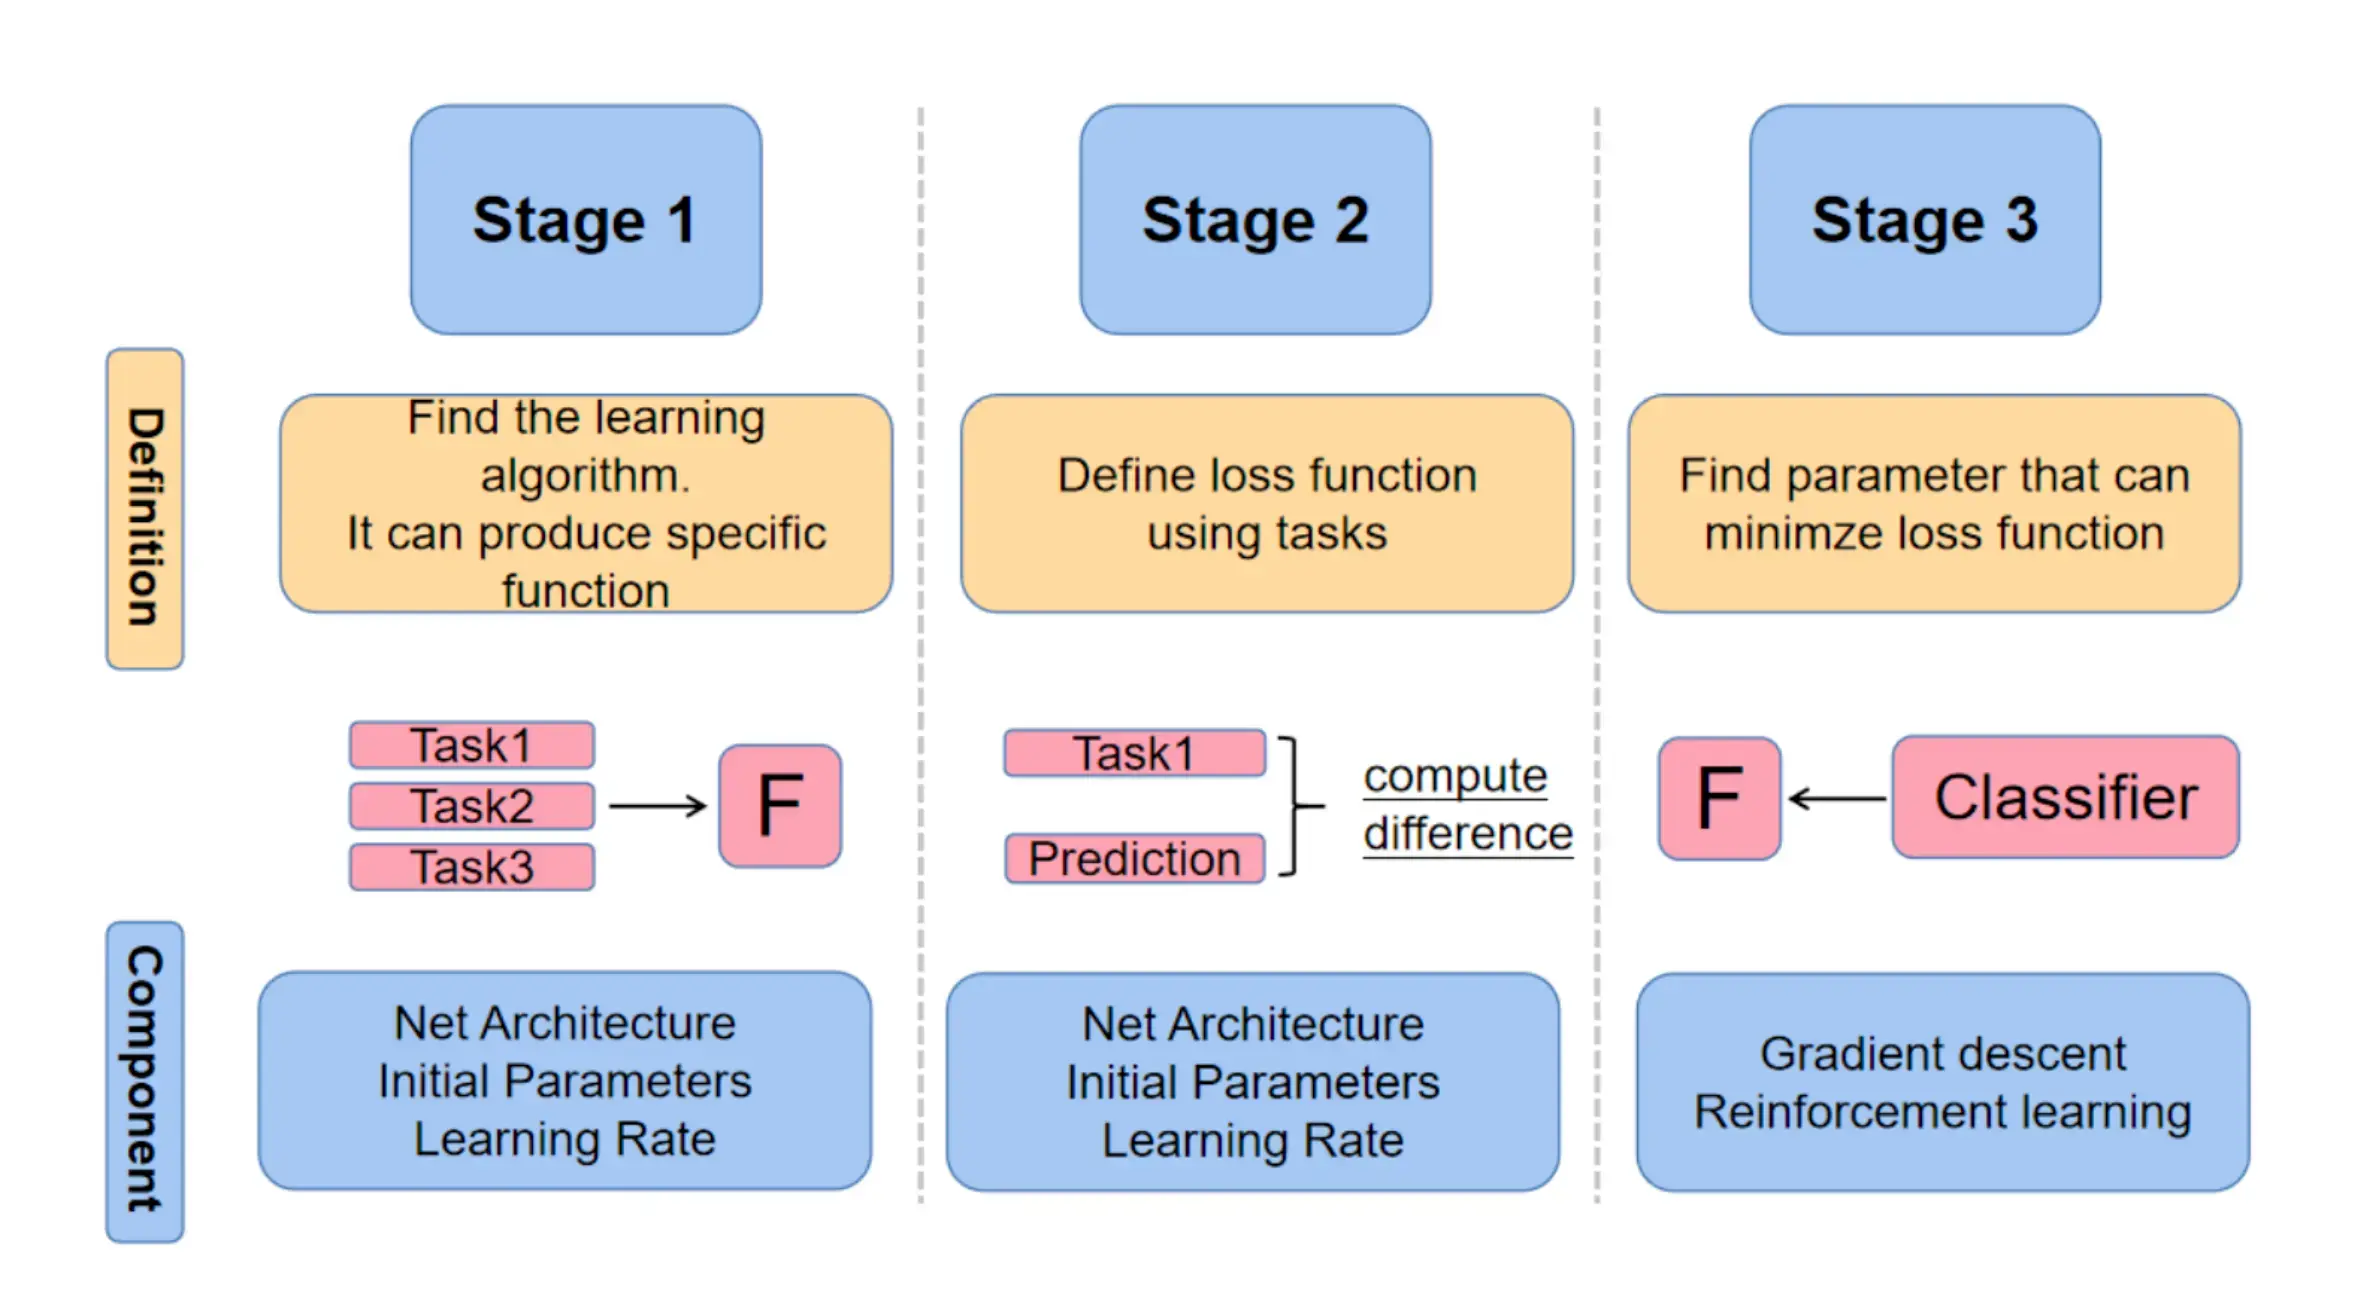
元学习(Meta Learning)是一种通用的学习范式,它以情景训练机制提供任务训练。 元学习的重点是使用先验知识提高未见过的任务的泛化能力。 如果使用先验知识来教导模型如何学习特定任务,则元学习可以被视为 FSL 的变体。需要强调的是,元学习并不等同于 FSL,FSL 应该被视为最终目标。它的目标是在不依赖大规模数据集的情况下实现稳健的泛化。通过数据和任务空间的双重采样,元学习能够构建大量与未见过的任务相关的辅助任务。
限制
当训练和测试任务存在明显的领域差距时,元学习很少被用来初始化参数权重,很容易导致模型出现负迁移。此外,元学习高度依赖于网络结构,需要针对广泛变化的任务进行重新设计。尽管如此, 元学习仍然是解决 FSL 最有效的方法之一。
数据集
分类体系
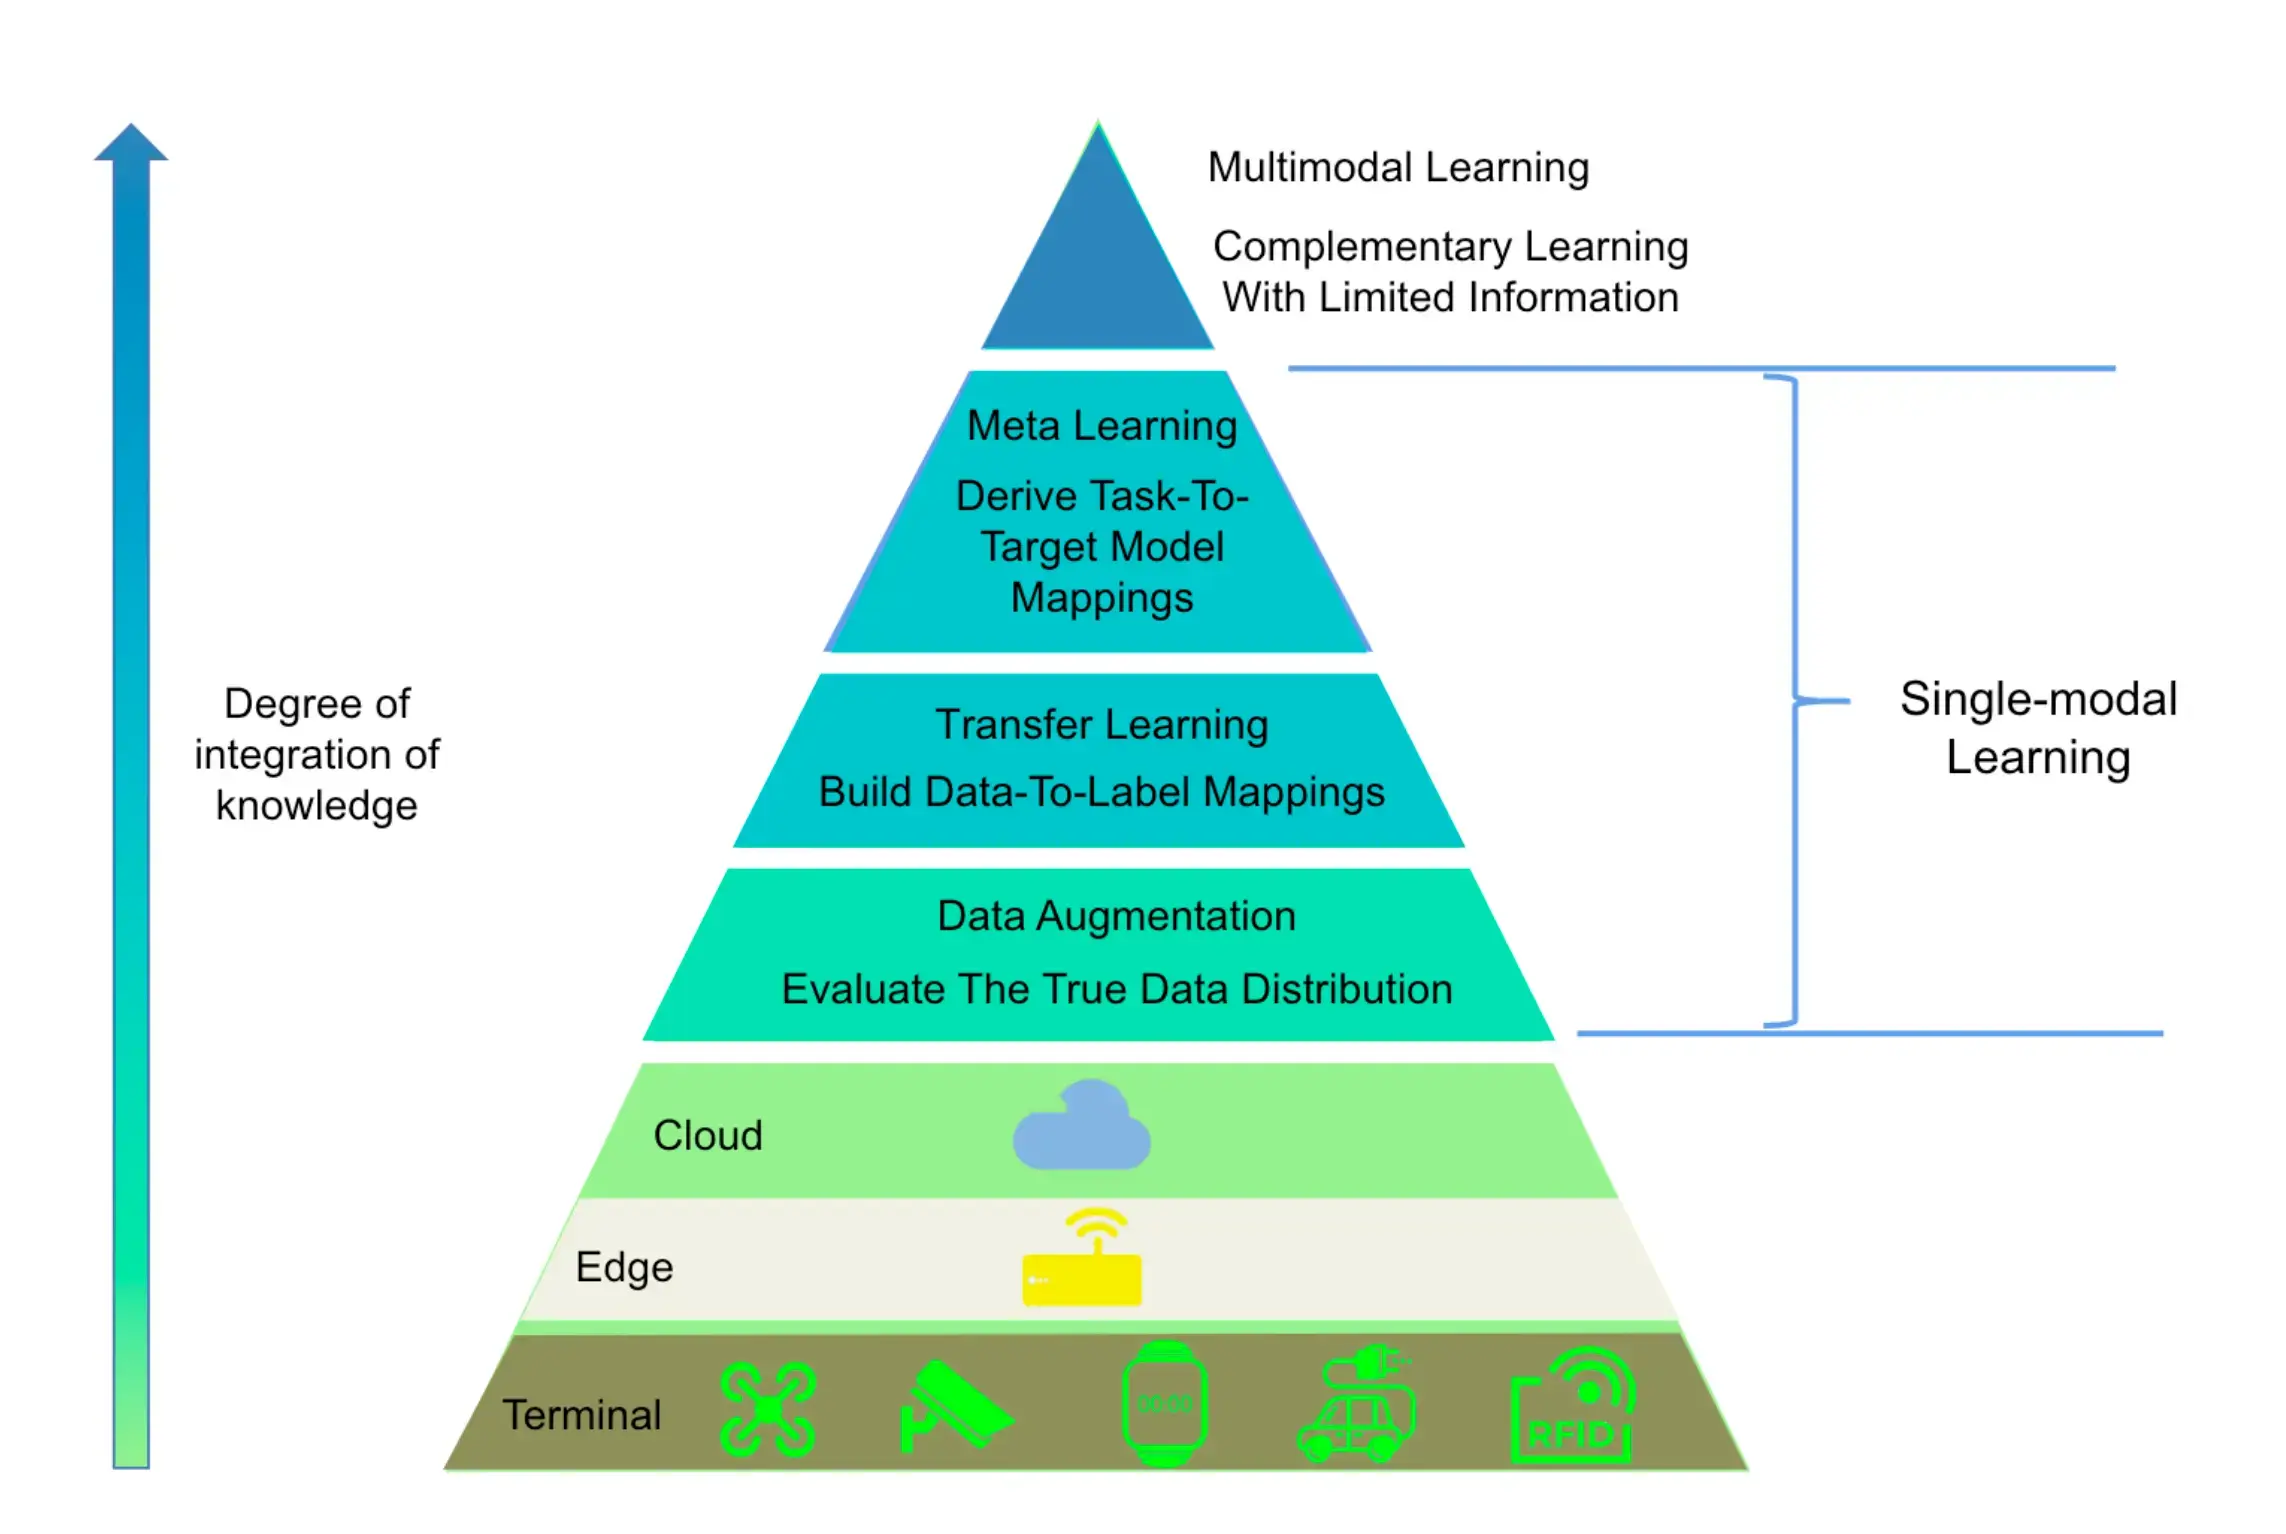
FSL:
- 单模态学习(Single-Modal Learning)
- 数据增强(Data Augmentation)
- 迁移学习(Transfer Learning)
- 元学习(Meta Learning)
- 多模态学习(Multi-Modal Learning)
评估真实的数据分布
FSL 之所以困难,关键在于有限的样本无法反映实际的数据分布。机器学习最直观的想法是根据一定的概率模型生成额外的数据,或者使用大量来自扩展数据的未标记数据来扩展辅助数据集。现有工作的重点是探索可在类与类之间或与外部数据集之间学习到的语义层面的特征差异。手工创建规则和自动学习数据处理是这一阶段的两种主要方法。
构建数据到标签的映射
此外,如果能重复使用基准数据集中的大量特征,这将大大减轻模型对数据的压力。预训练和微调通过学习数据对标签的有效表示,以及对底层语义特征的有效正则化,为 FSL 提供帮助。其中,预训练阶段学习各种不同任务中的最佳初始化参数,而微调阶段则冻结大部分底层参数,只对分类层的参数进行再训练。
推导任务-目标模型映射
微调在小样本的基线模型中已经有很好的表现。然而,在多任务学习中,大量任务被当作一个任务来学习,这导致模型的泛化效果很差。与此相反,元学习利用情节训练机制对数据和任务空间进行双重采样,找到不同任务之间的潜在关联,从而对整个任务空间进行良好的描述。
在信息有限的情况下进行补充学习
多模态学习在深度学习中提出已久,但直到近几年才开始与 FSL 相结合。多模态维度的信息最接近人类真实的信息世界,它在一定程度上弥补了 FSL 无法准确评估单一模态数据分布的缺陷。像素、语义和声音都可以作为 FSL 任务的监督信号,而最近的无监督学习也被用于利用对比学习探索更稳健的特征表征。
数据增广,以最大概率评估真实数据分布
在现实世界的 FSL 任务中,由于隐私、收集成本和标记成本等原因,Support Set 和 Query Set 中的样本数量通常是有限的。为了缓解这一问题,数据增广被认为是增加 FSL 样本丰富度的最直接方法。然而,FSL 数据增广的核心风险在于增广数据集能否可以评估真实数据背后的分布情况。
根据数据增广技术能否在其他任务中重复使用,FSL 数据增广分为:
- 手工创建规则
- 自动学习数据处理
手工规则
简单地依靠单样本像素的简单变换并不能防止过拟合的风险。
数据级别
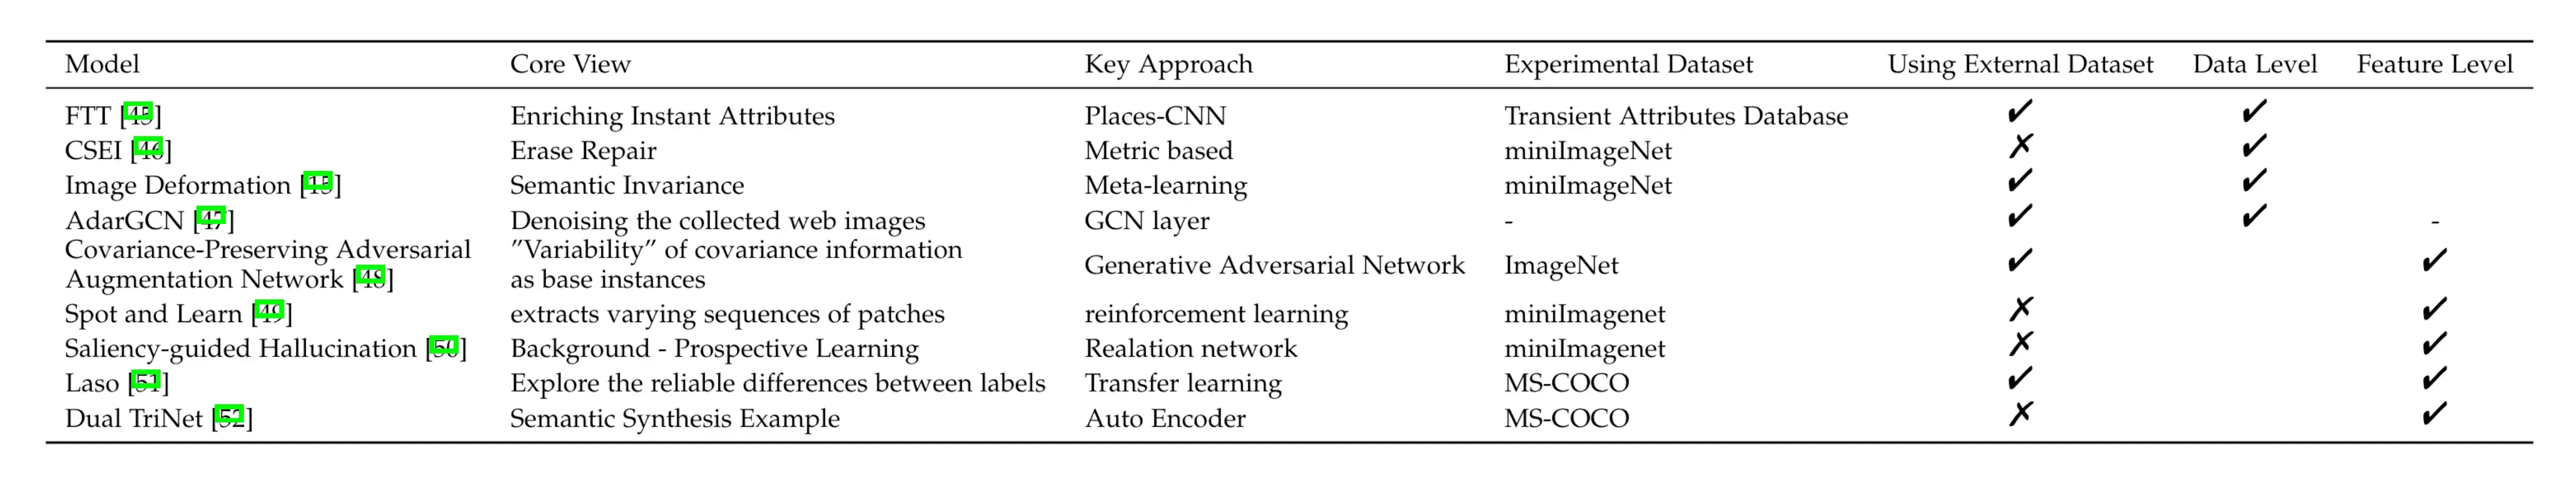
基于数据层面的 FSL 数据增广主要包括互联网数据采集、环境变化、差异传递和随机作物填充等。
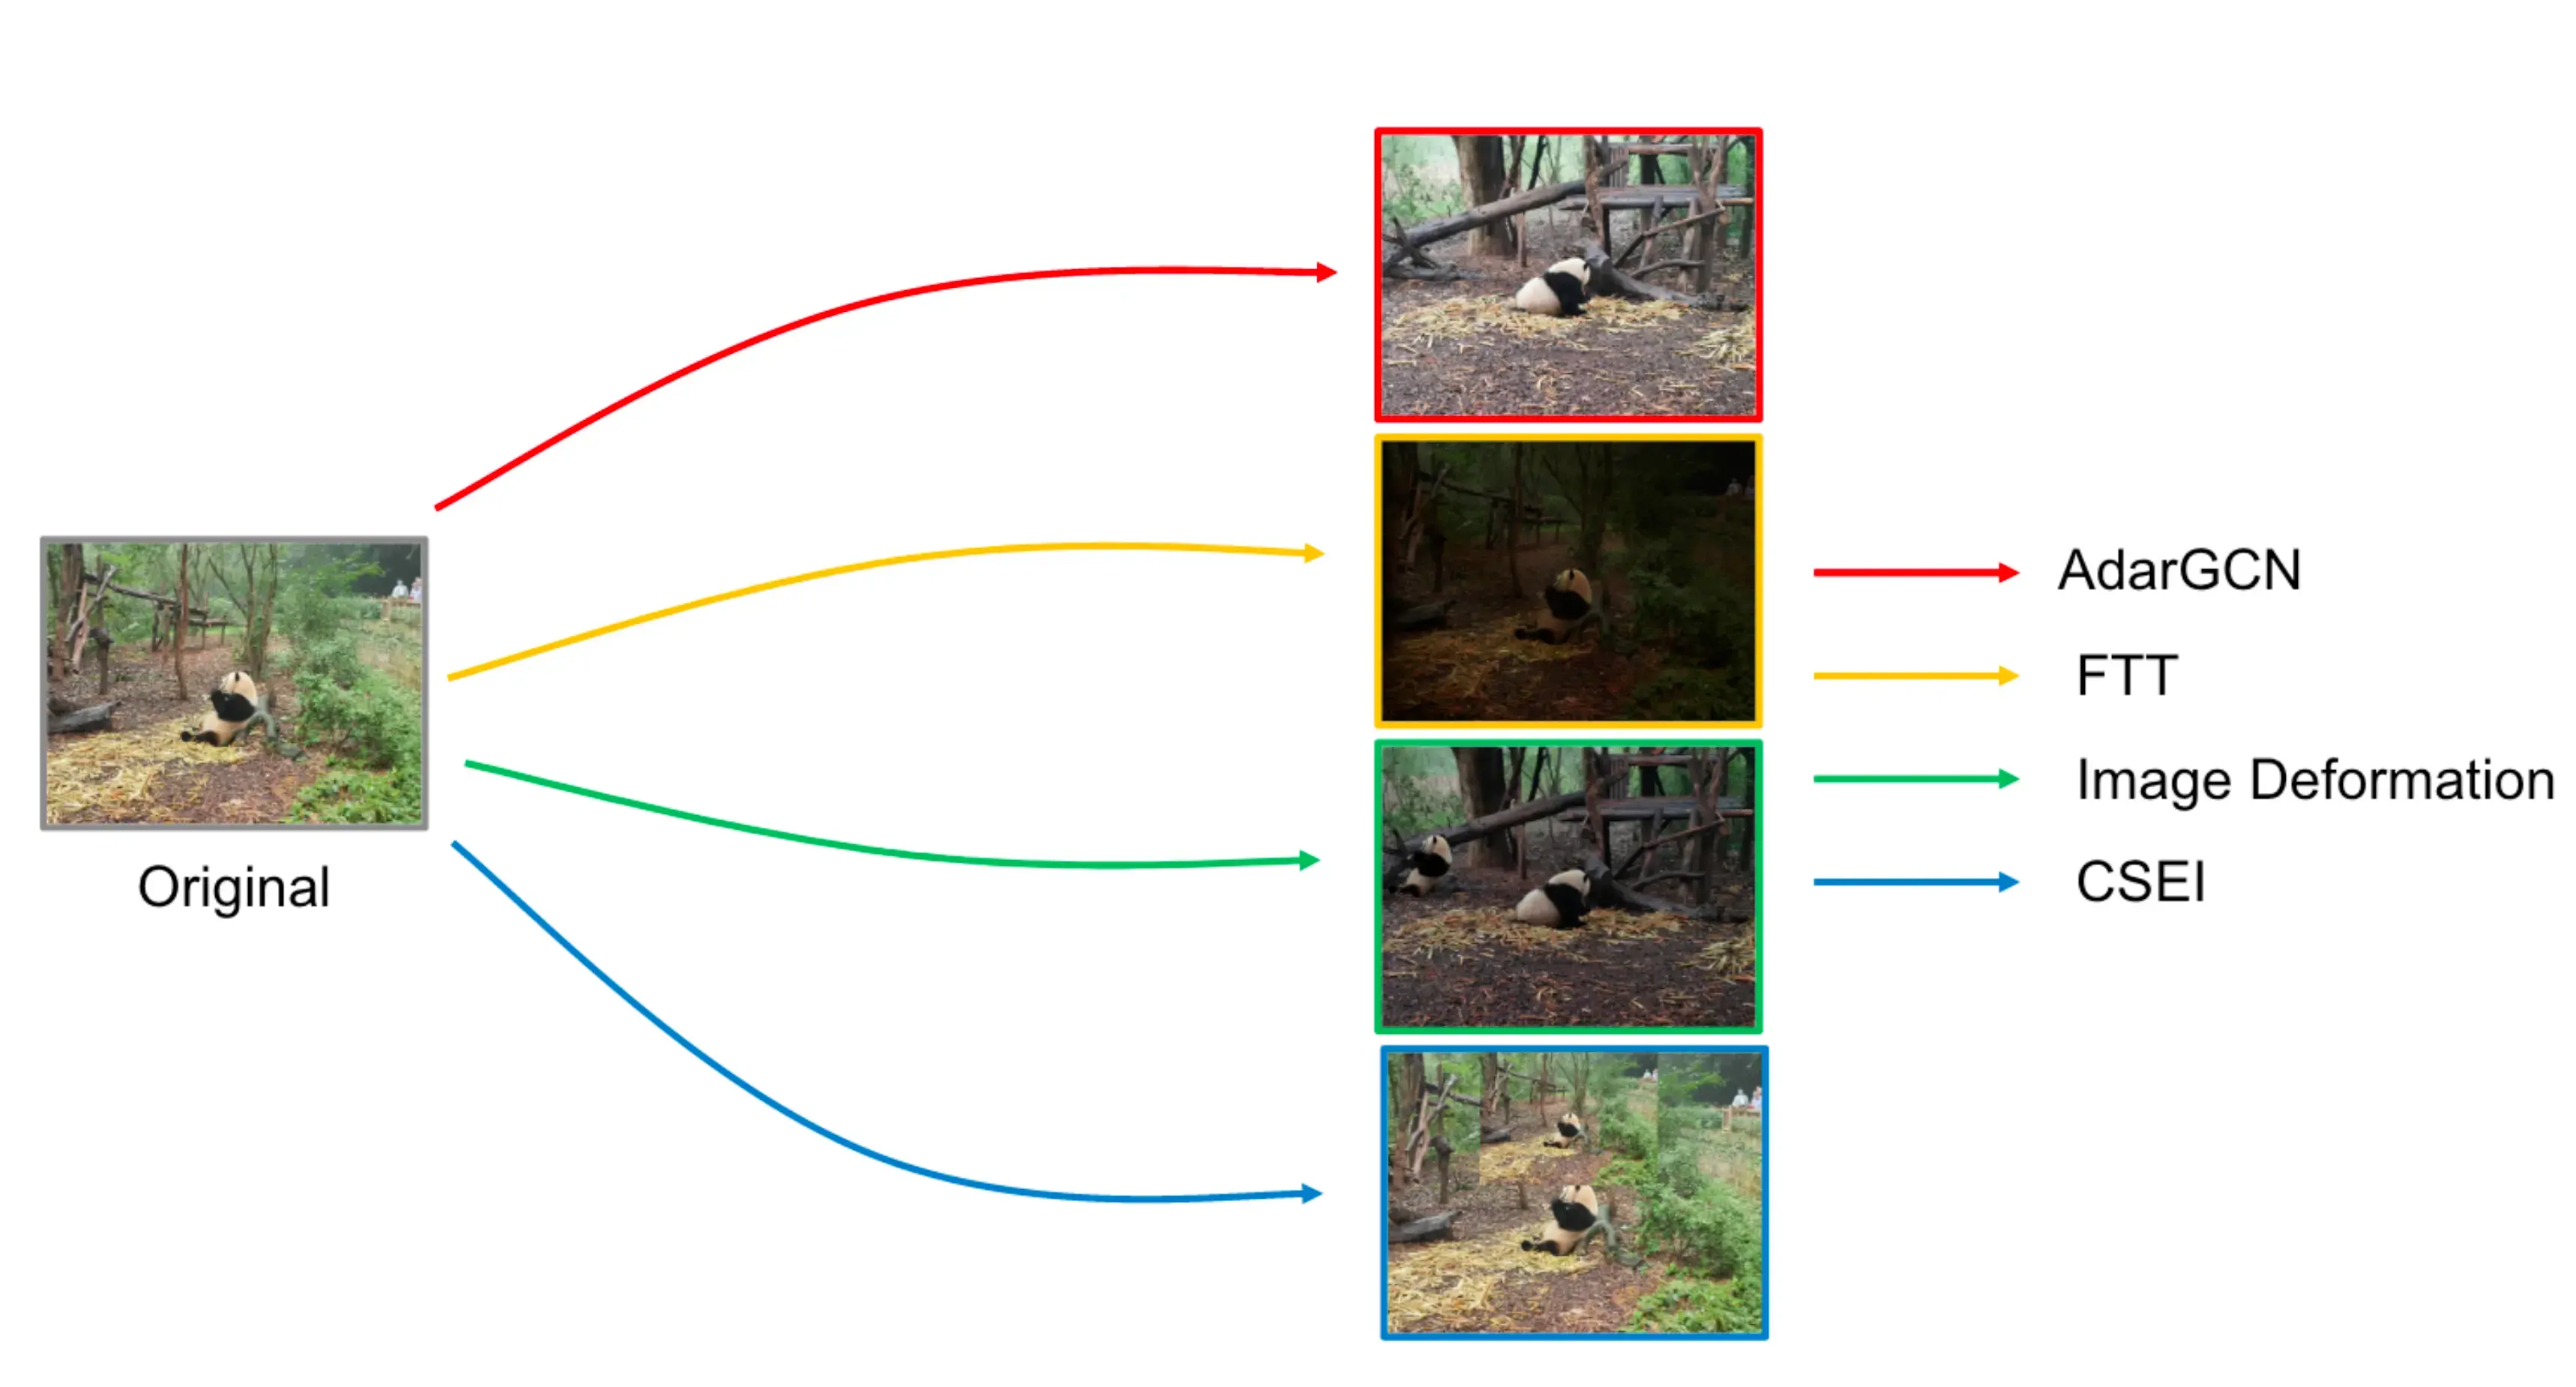
特征级别
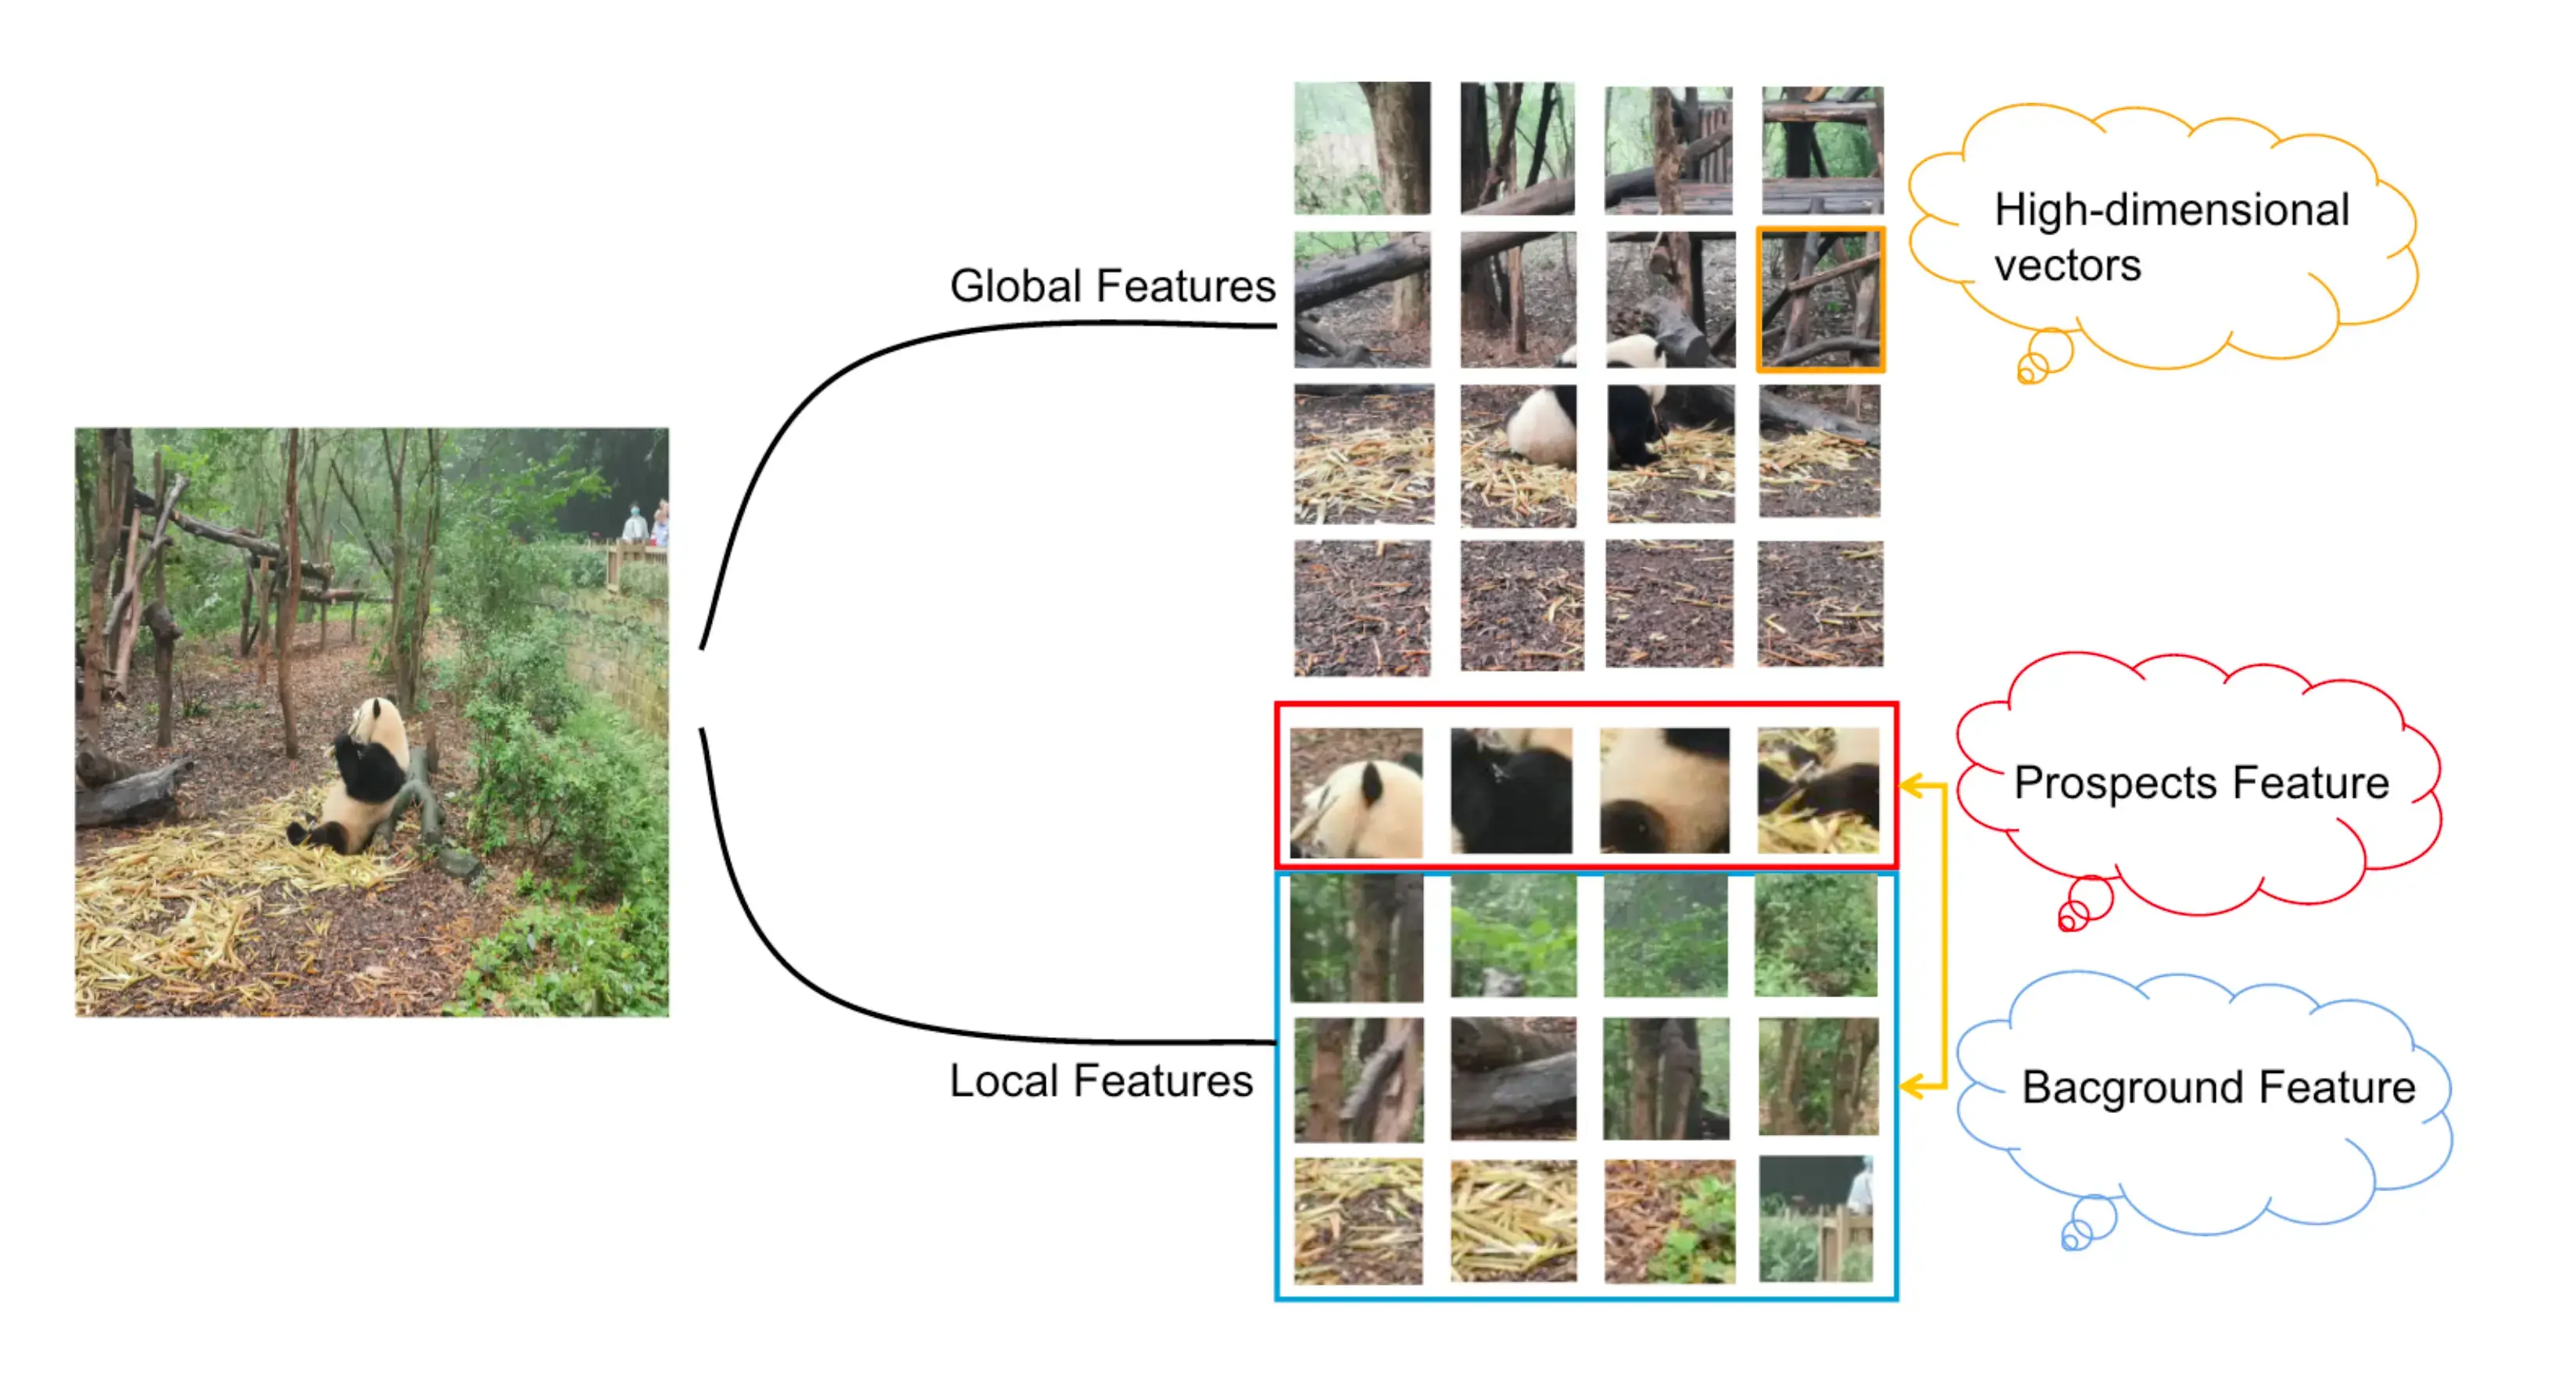
基于特征级别的数据增广主要分为全局特征和局部特征。全局特征关注整个图像,包括前景和背景。另一方面,局部特征选择性地关注前景中的主体部分。
学习数据处理
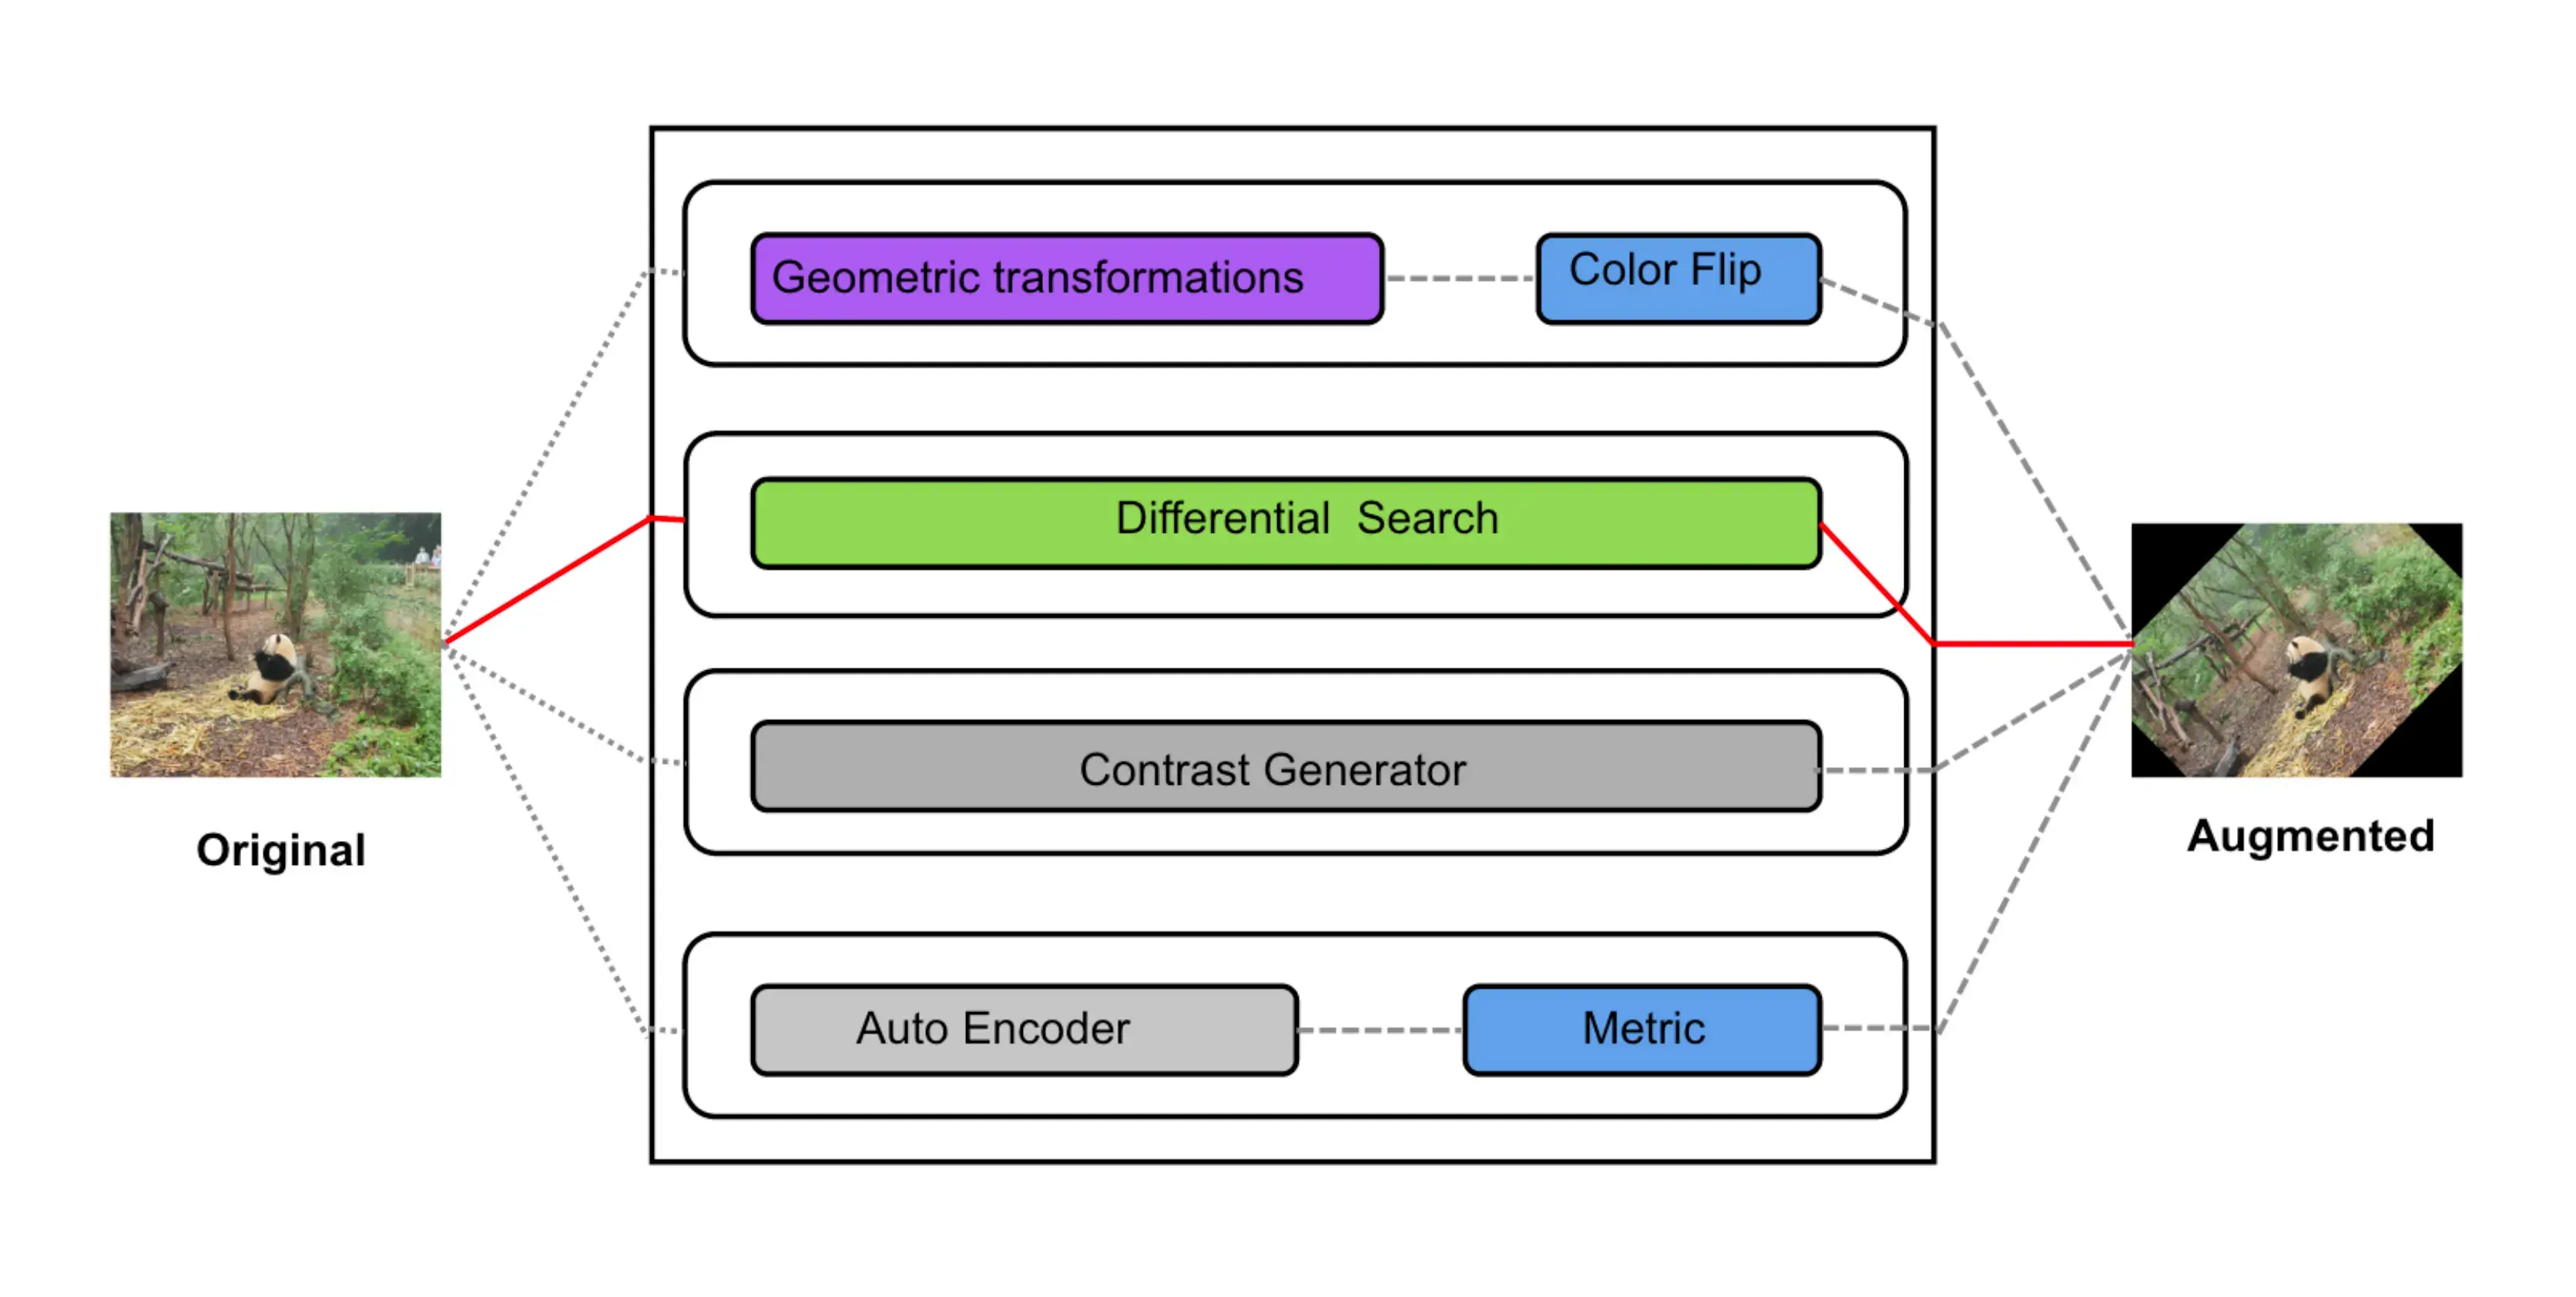
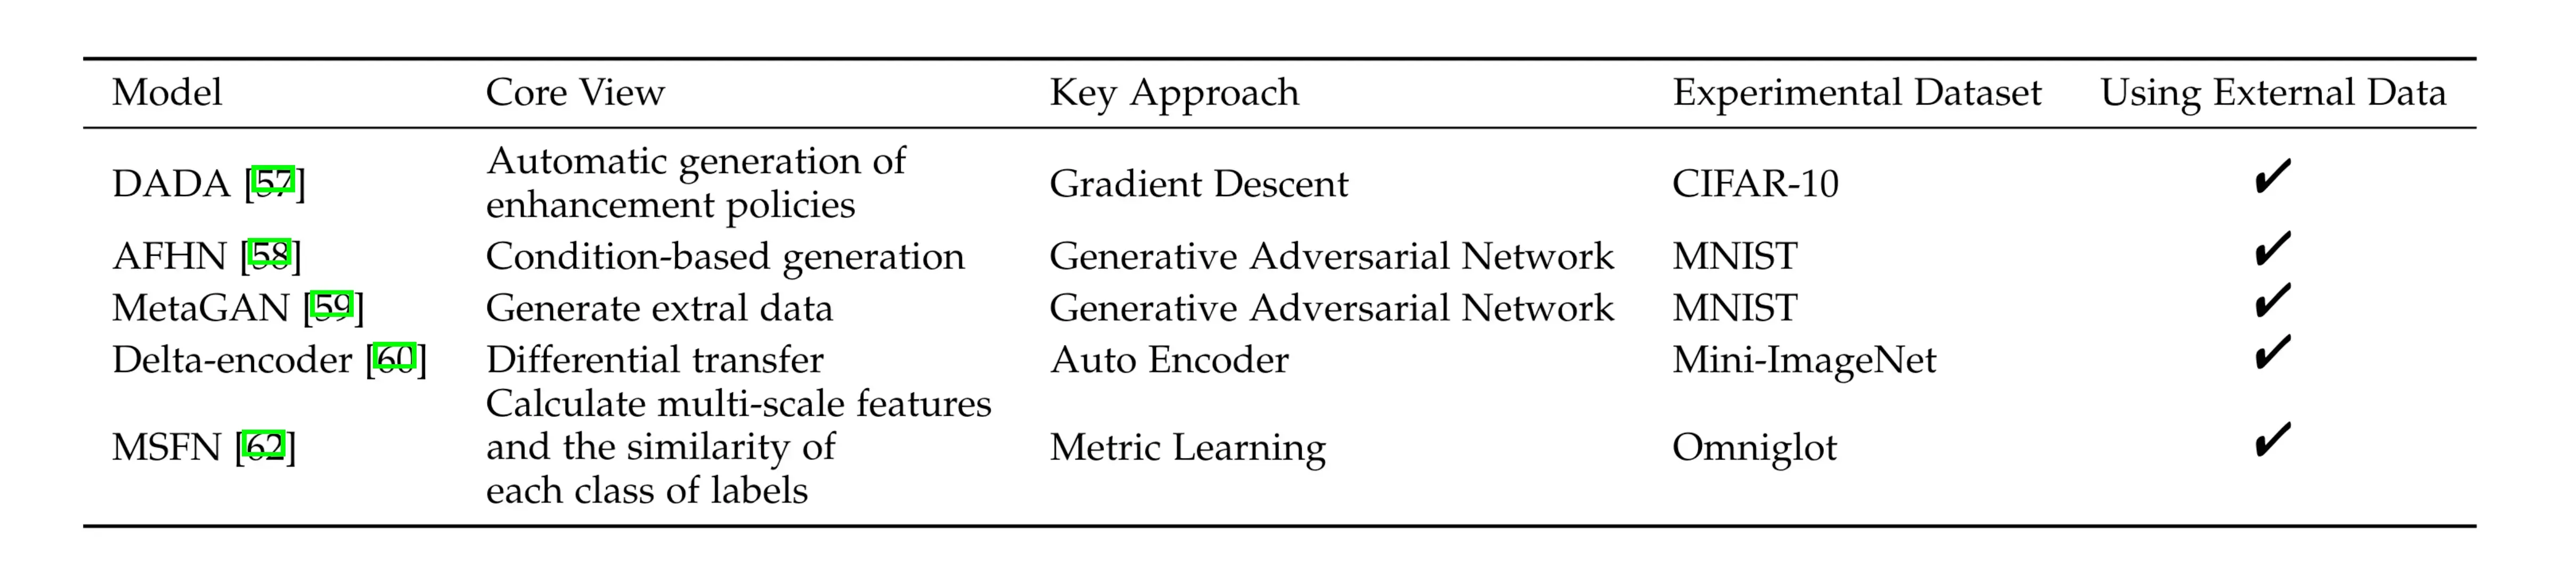
2018年,随着元学习的成熟,数据增广进入了自动增广的领域。通过元学习与其他数据增广方法的结合,这一时期涌现了大量优秀的工作。
- Probability-based method.
- Generation-based method.
讨论与总结
为了最大限度地评估 FSL 背景中真实数据的分布, 数据增广已经从手工规则发展到自动学习的数据处理阶段,其分水岭为2018年元学习的成熟。
迁移学习为特定问题构建数据到标签的映射
迁移学习是一种经典的学习范式,旨在解决 FSL 中只有少量甚至没有标记样本的难题。特征重用是迁移学习解决 FSL 缺乏数据这一背景问题的核心思想。其基本操作是在广泛的数据集上预训练模型,然后在有限的 Support Set 上进行微调。当源领域和目标领域存在较大差距时,知识迁移的效果必然会大打折扣。这种跨领域背景为 FSL 带来了新的挑战。在 FSL 中,迁移学习大致可分为预训练和微调阶段,这两个阶段也可称为基线。
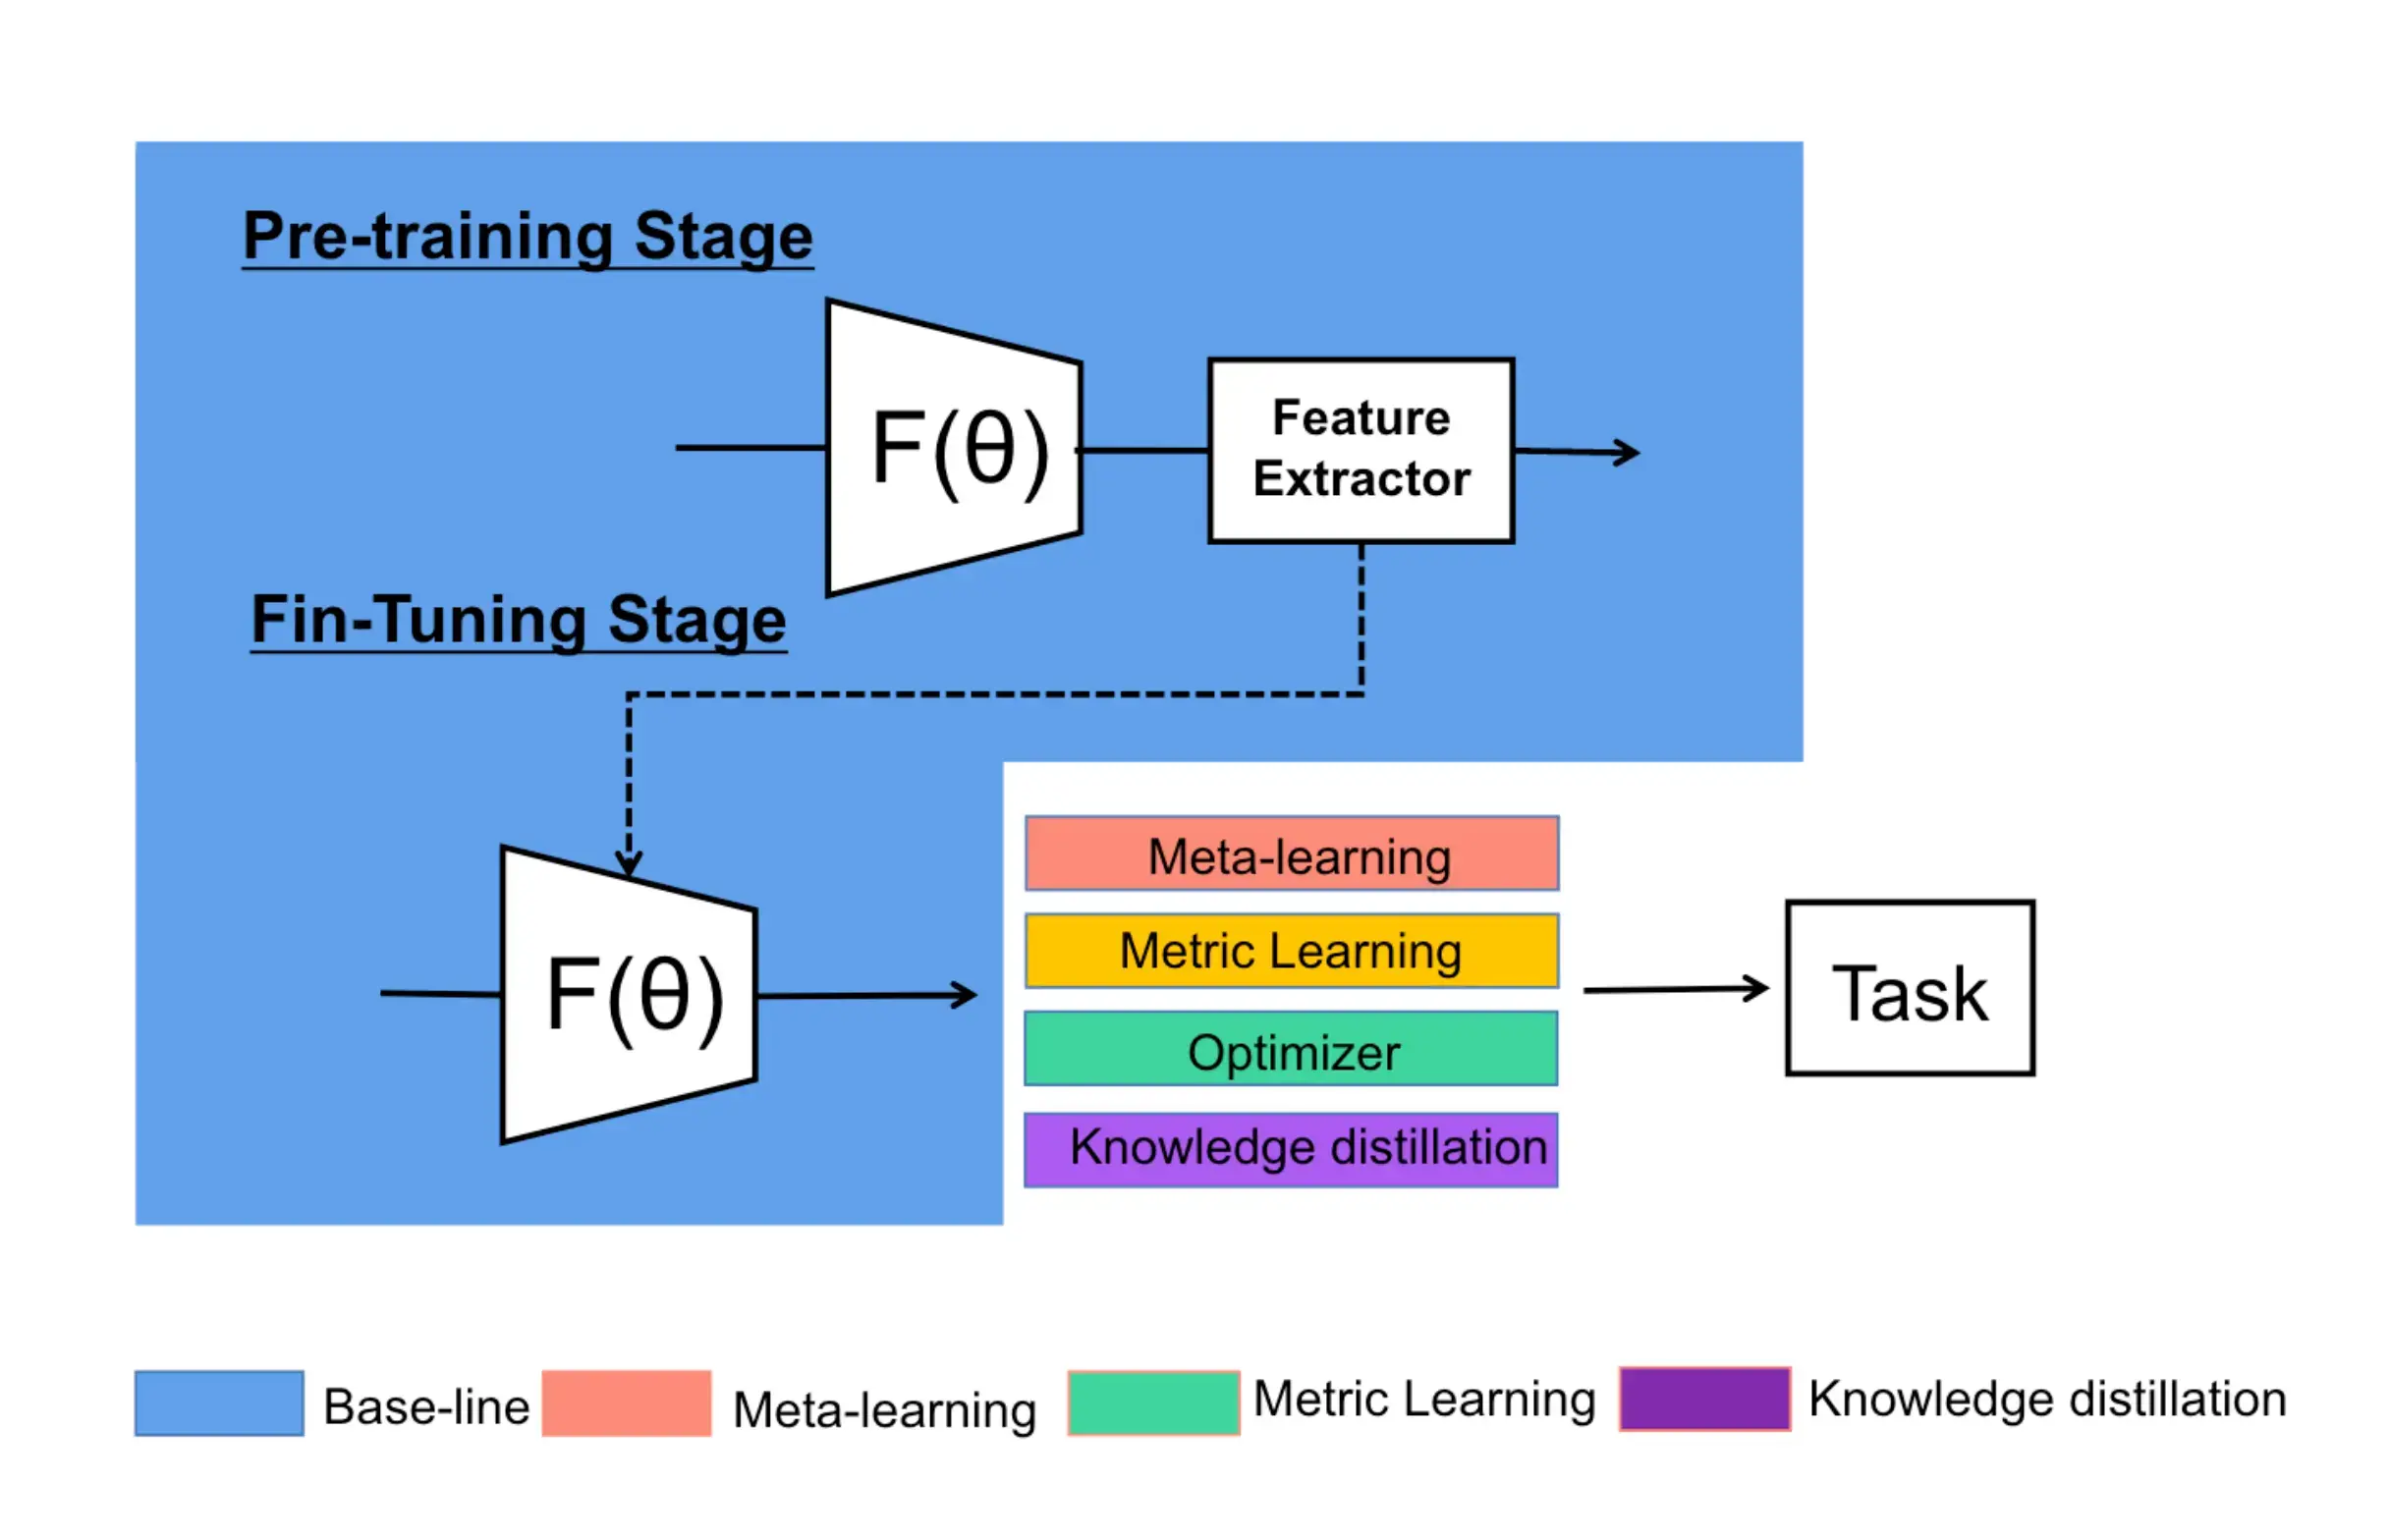
预训练和微调
2012年至2018年,CV 和 NLP 领域涌现出一大批优秀工作,特别是在预训练模型出现之前,自然语言处理领域进展缓慢,随着计算能力的提高和优秀的预训练模型的提出,它在 BERT 的引导下得到了长足的发展。
作为下游任务,如何利用这些优秀模型获取特征,能很大程度上减轻 FSL 的数据压力。特别是对于小样本图像分类,作为预训练模型,需要借助外部大规模标签数据集,从类似任务中提取先验知识。最常见的做法是设计一个没有分类器层的 backbone,其中包括卷积神经网络或自动编码器。模型的输入是一组图像,输出是嵌入高维空间的特征向量。高维特征向量可以获得目标图像的充分有效的语义信息。
在提出预训练后,研究人员又提出了微调。预训练中的大部分参数被冻结,只有分类层参数在测试阶段进行更新。最近的许多研究都证明,与基线模型相比,微调可以将 5-way-1-shot 任务的准确率提高 2%-7%。虽然 Support Set 和 Query Set 中的样本数量较少,但预训练和微调对提高 FSL 的准确率仍有很大帮助。NLP 中也有类似的结论。一些研究表明,微调可以嵌入到 SOTA 元学习或半监督学习框架中,以优化模型参数。
目前,微调通常与元学习相结合。一项研究尝试将元学习集成到训练网络中的特定层。然而,实验结果表明,由于 FSL 背景中 Support Set 和 Query Set 不重叠,因此从源数据集中迁移整个知识并不是 FSL 的最佳解决方案。另一研究建议应针对部分知识进行迁移,需要通过冻结或微调主干模型中的特定层来控制可迁移性的程度。同样,微调也可用于防止网络的新类别污染基本类别的特征空间。
跨域小样本学习
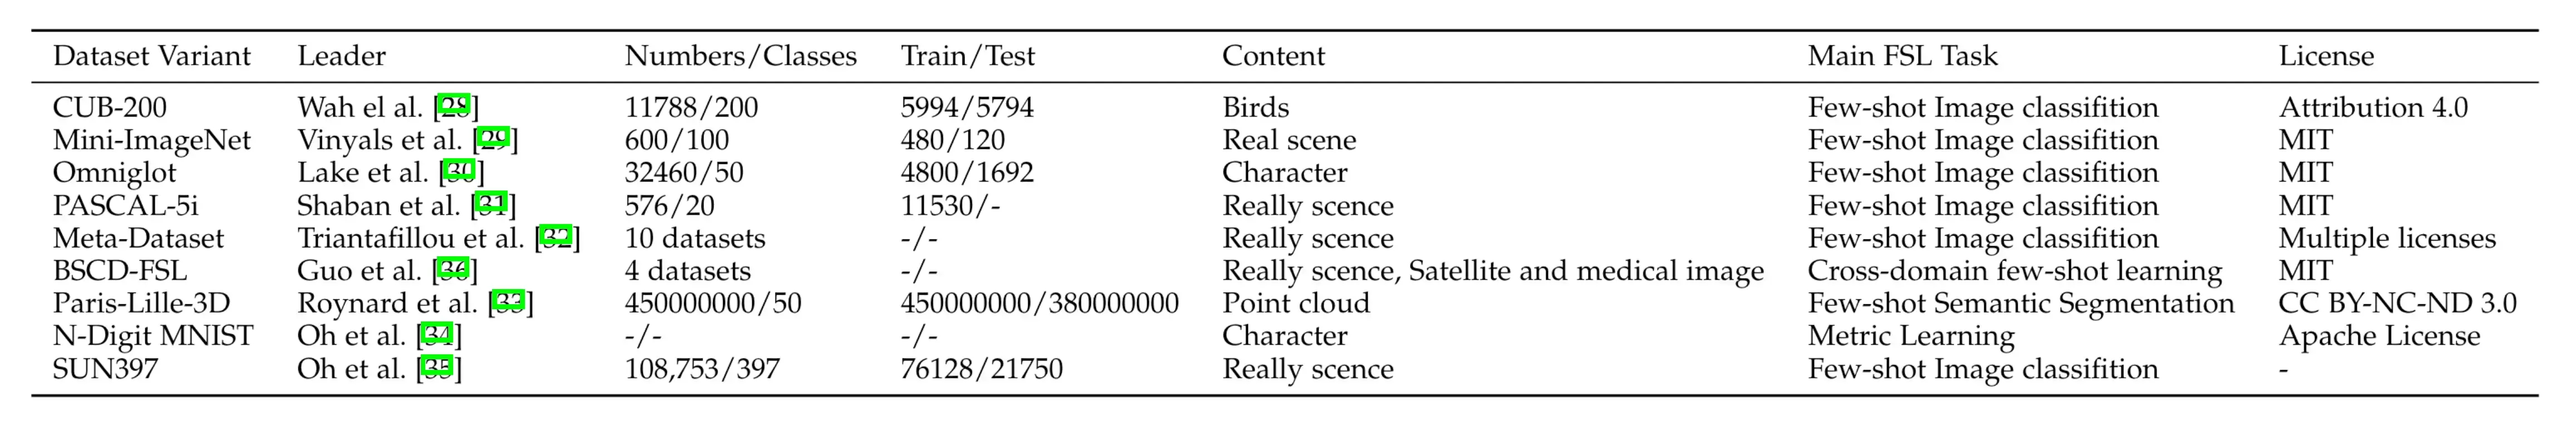
FSL 的最新进展在很大程度上取决于训练阶段的标记数据,然而,在许多实际应用中,为特定任务收集各种形式的数据集是不现实的,这导致 FSL 在完全不同的领域之间面临挑战。跨域小样本学习整合了 FSL 和域自适应问题,这是一个相对全面和具有挑战性的背景。长期以来,FSL 常用的基准数据集存在数据集结构标准化、自然场景相似度大等问题,导致模型在标准数据集上表现良好,但在实际任务中却得不到令人满意的结果。谷歌在 2020 年首次发布了一个名为 Meta-Dataset 的 FSL 跨域数据集,其中包括 ImageNet、CUB-200-2011 等共 10 个公共图像数据集。然而,这些数据集仍侧重于自然场景,不能被广泛视为跨域小样本基准数据集。 直到 BSCD-FSL 数据集的出现,根据与 ImageNet 的相似程度,该数据集分为 CropDiseases、EuroSAT、ISIC 和 ChestX。 作者广泛评估了当前 FSL 方法的性能,实验表明,所有方法的准确性都与提出的自然图像数据相似度指标相关。目前,跨域 FSL 主要集中在区分与域无关的特征和采用迁移学习的领域自适应技术。
域适应的目标是将知识从源域转移到目标域,目标域具有与源域相同的类集,但数据分布不同。最近,许多工作都使用自适应网络将其特征与新域相匹配,或从多个骨干模型中选择与域无关的特征。
讨论和总结
虽然元学习方法在标准 FSL 背景中的性能高于迁移学习,但在跨域 FSL 设置中情况却截然相反。最近发表的一篇论文指出,当领域出现正交时,微调和预训练带来的改进同样非常有限。在预训练的特征空间中,基础类形成了紧凑的簇,而新类则分布在差异较大的组中。目前,将训练好的模型实际部署到生产环境中往往无法适应快速变化的环境。预训练可被视为一项包含许多学习类的任务,但它只是一项单一的学习任务。
元学习源自独立于具体问题的任务到目标模型映射
元学习从数据和任务的双重采样中学习历史先验知识,然后提取元知识应用于未来任务。元学习独立于具体问题,在任务空间中探索最优初始化参数,摒弃了传统监督学习中与任务无关的特征表征。迄今为止,大多数元学习模型都是采用传统的梯度下降法更新参数。当然,也有基于强化学习和度量方法的非梯度下降方法。在 FSL 中,元学习可用于 自动学习模型参数、 度量函数 和 信息传递。
学习模型参数
大多数深度学习框架使用不同的参数初始化方法,如均匀分布、正态分布等。这种随机初始化最大的问题是容易陷入局部最优位置。元学习的目标是训练超参数生成器,经典的方法有 MAML、Repital 及它们的衍生变体。元学习和多任务学习最大的区别在于,多任务学习只关注当前任务的表现。使用标准 FSL 基准数据集证明元学习比迁移学习表现更好。 然而,元学习对网络结构更加敏感,需要对超参数进行微调。 学习优化器是学习模型参数的另一个重要方向。 LSTM 作为基础优化器,接受时间的差异和元网络在时间的隐藏状态,原始网络的输出是模型权重和偏差的更新。2016年,Learning to learn by gradient descent by gradient descent 中提出 BPTT 来监督 LSTM 训练。值得注意的是,这是在监督学习的背景下进行的。如果是在无监督和主动学习的情况下,优化需要做哪些更新?受此启发,人们长期关注强化学习、贝叶斯推理和进化算法,试图通过启发式算法自动找到优化策略。
最后,传统的神经架构搜索(Neural Architecture Search - NAS)也融入了元学习的理念,并在 FSL 下进行了相应的调整。目前所知,共享和随机选择的 Supernet 权重是 FSL 的早期解决方案。最近,大量研究表明,单次(one-shot) NAS 和传统 NAS 之间仍然存在性能差异,单次 NAS 使用权重共享网络对 Supernet 只进行一次训练,然后进行一轮推理就能得到准确的预测结果,从而大大减少了实验所需的计算量。
学习度量算法
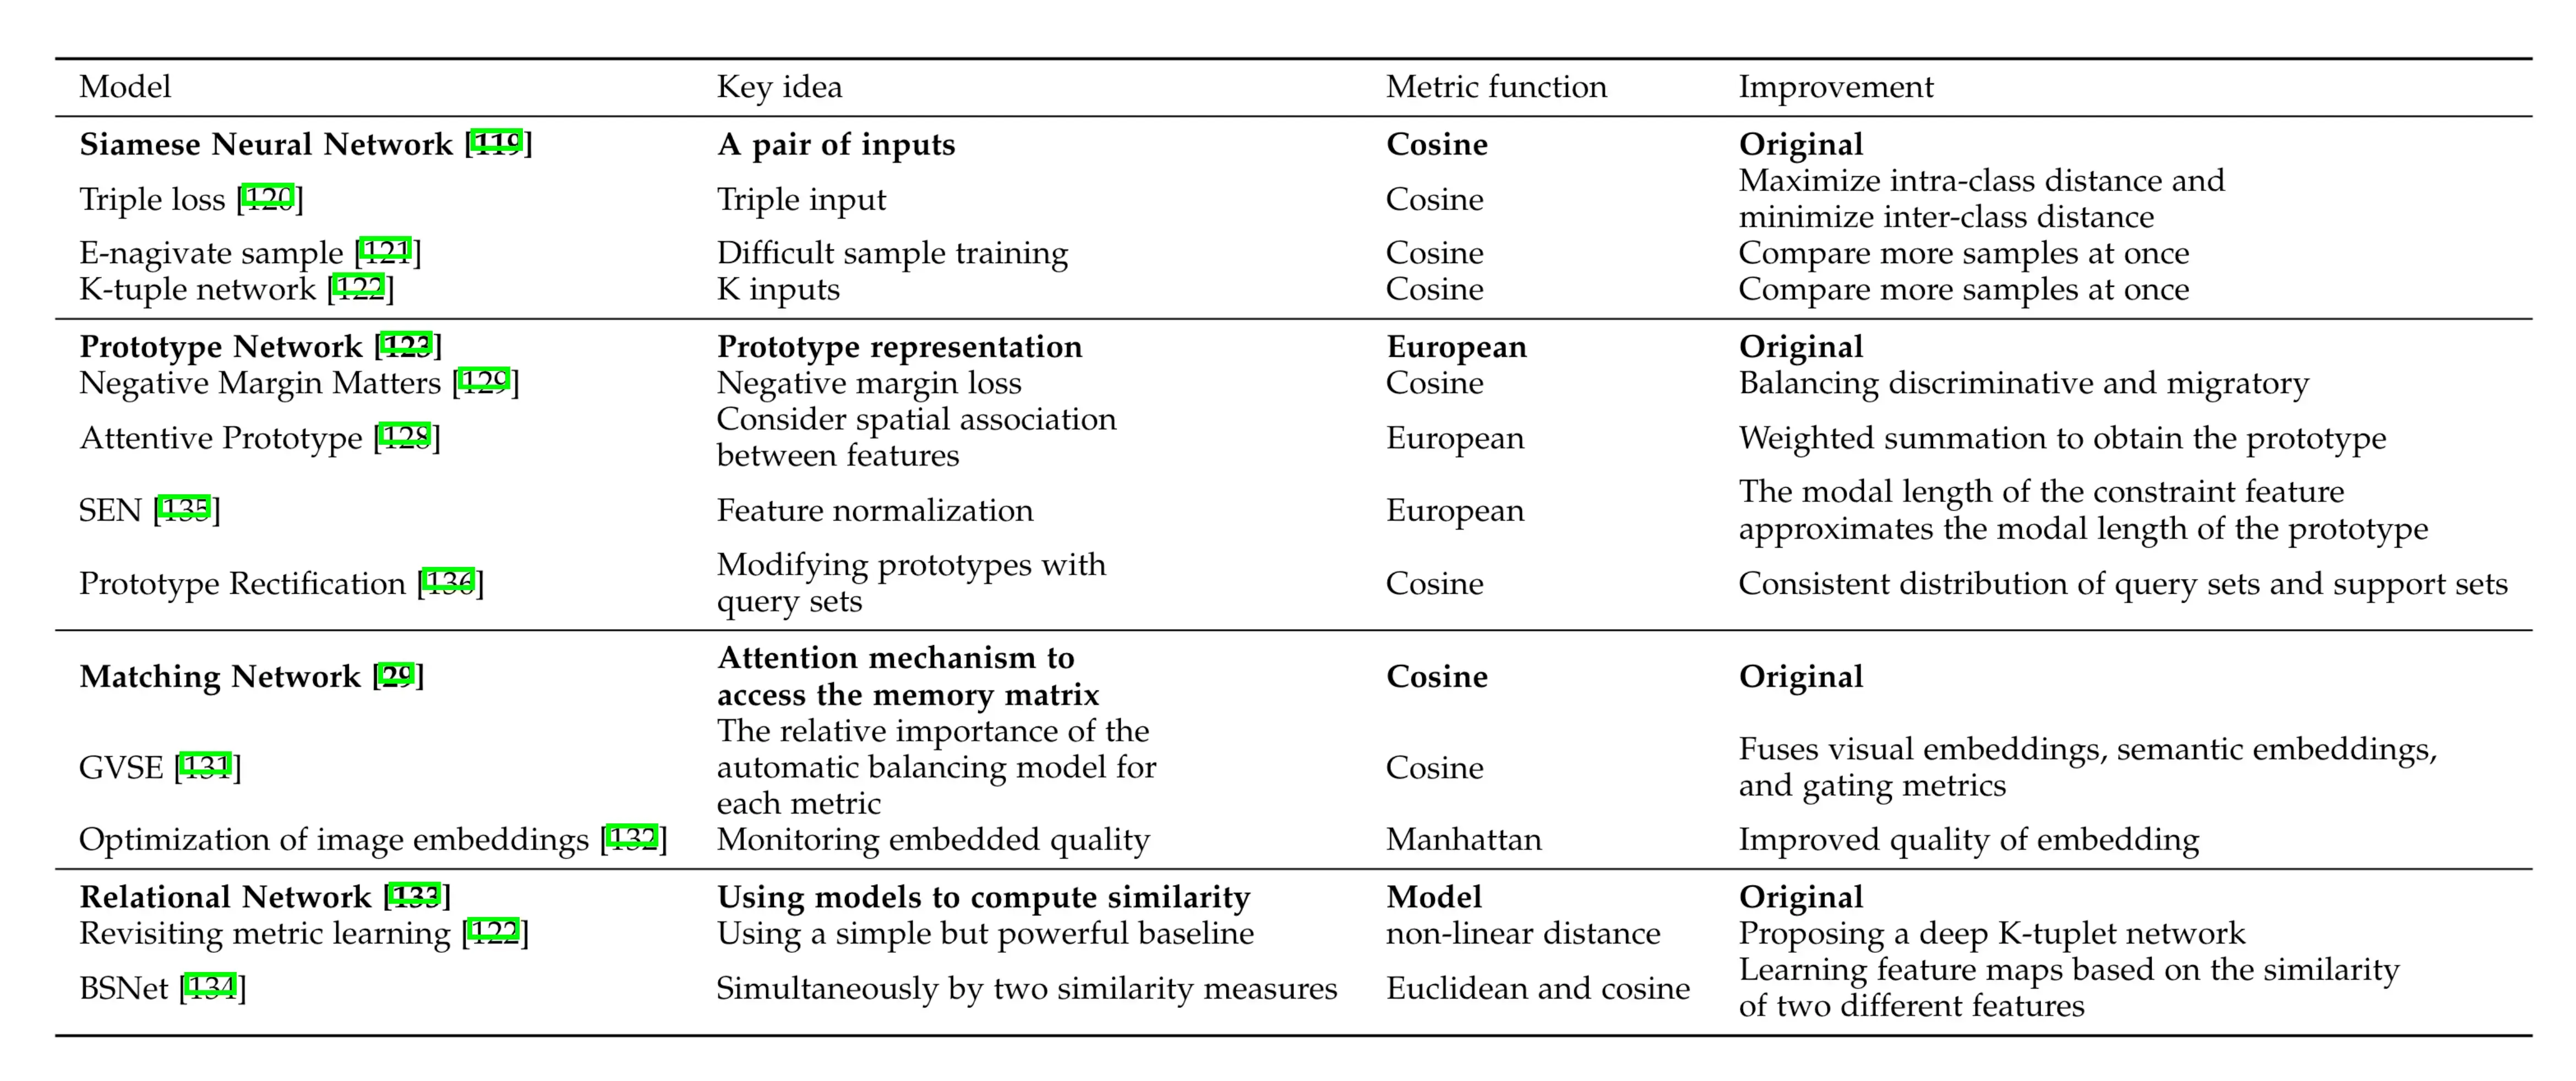
度量学习与经典的机器学习不同,度量学习不再将模型分为训练和测试阶段。在以往的许多论文中,度量学习总是被单独介绍。在我们的语境中,度量学习将在元学习的框架下进行解释。下图说明了最具代表性的学习方法之一,该方法基于一个原型网络,经过改进后,该网络在分类任务的基准数据集上获得了大幅改进。
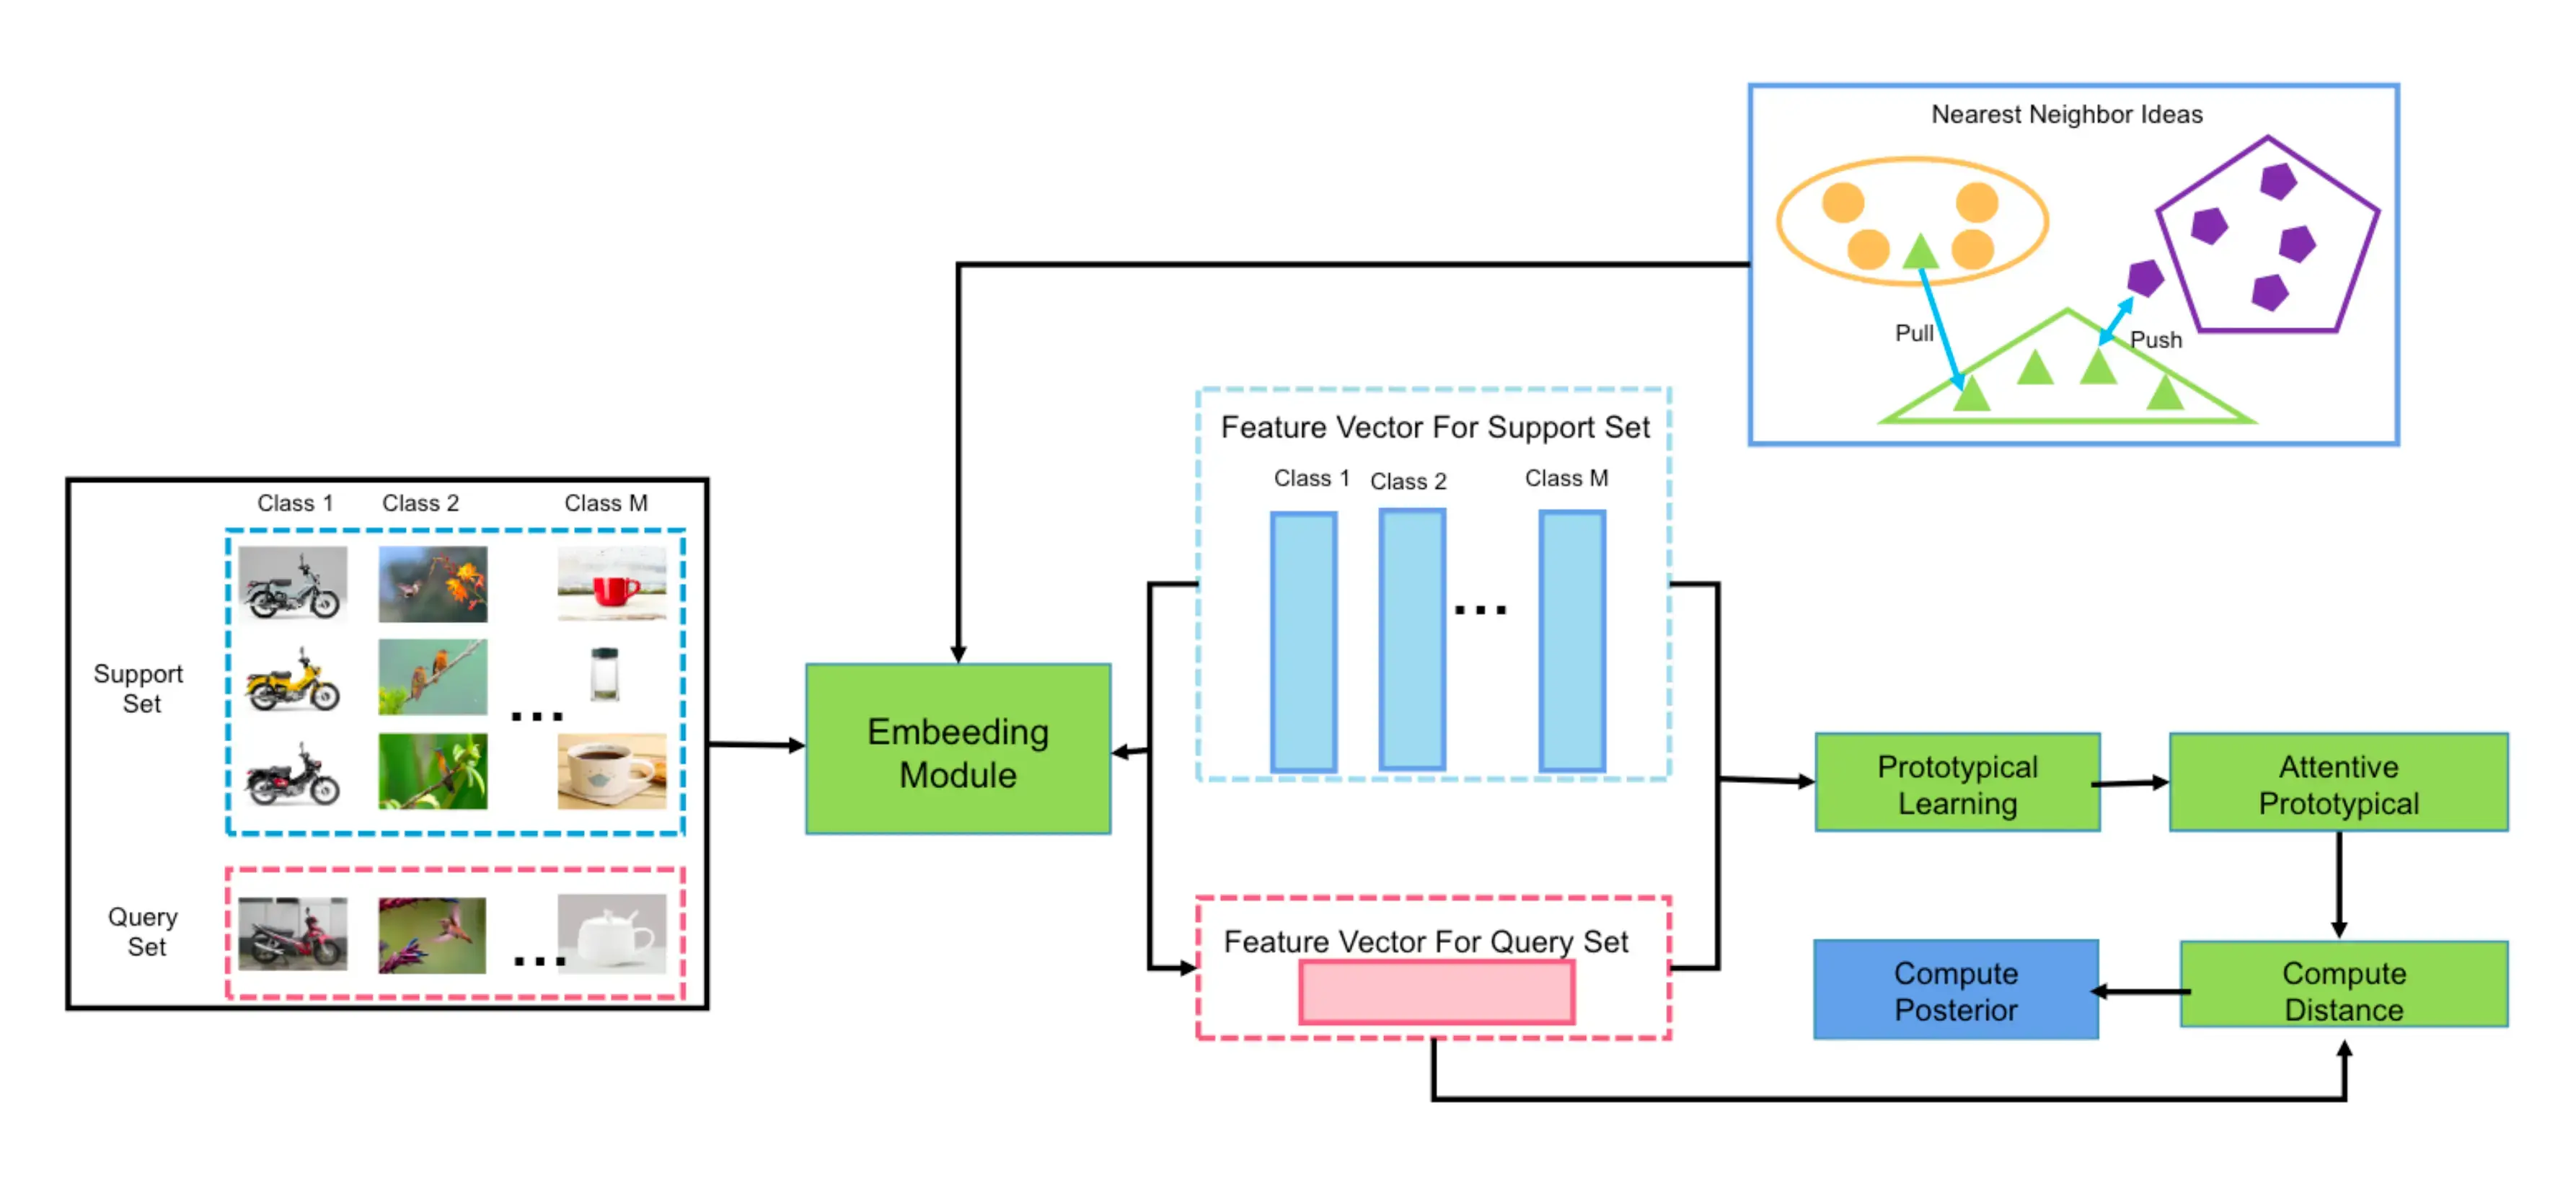
孪生神经网络(Siamese Neural Network) 是度量学习中一个相对较早的模型。它可以被简单地视为二元分类问题。模型的输入由一组正或负的样本对组成,在推理阶段,模型需要评估图像的相似性。在 FSL 度量学习中, Triple loss 是处理多对输入的另一种方法。与孪生神经网络相反,Triple loss 要求正样本、负样本和锚样本同时可用。如果训练样本之间很容易区分,这将不利于模型更好地学习判别特征。难样本选择技术除了考虑正负样本之间的相对距离外,还考虑了正样本对之间的绝对距离。
与孪生神经网络相比, 原型网络(Prototype Network) 实现了真正意义上的分类。最大的区别在于,该模型允许输入更多的数据。通过特征平均,可以找到最具代表性的样本作为原型。然而,简单的特征平均很容易受到噪声的干扰。在此基础上,许多工作都在探索如何使原型之间的距离越来越大。其中最具代表性的工作是提出正负边距,在最大限度提高模型判别能力的基础上,进一步减少过拟合,增强泛化能力。 匹配网络(Matching Networks) 是一种更通用的网络框架,它能将少量数据集和无标记数据映射到嵌入空间中的向量。匹配网络结合了近邻算法的参数模型和非参数模型的最佳特点,通过学习嵌入表示来模拟样本距离分布。实验证明,嵌入传播能产生更平滑的嵌入流形。如何在有限的时间内学习高质量的嵌入表示对提高模型的准确性至关重要。 关系网络(Relational Network) 与上述三种模型的不同之处在于,其相似性是通过神经网络计算出来的。与孪生神经网络和原型网络相比,关系网络可被视为提供了一个可学习的非线性分类器来确定关系。分类器可以是预训练神经网络的特征提取器,也可以是多重嵌入模块。关系网络的最大贡献在于,它摆脱了单一的线性度量函数,探索使用另一种模型来生成相似性。
学习传递信息
事实证明,图神经网络(GNN)近年来在基于关系的任务中表现出色。研究人员发现,其基于类别的信息传递可以很好地帮助 FSL 学习识别新类别,同时避免这些类别被专有特征所支配。早期的图神经网络主要是通过在支持集和查询集之间建立完整的连接来模拟不同节点之间的权重传播。节点可以用单点编码或嵌入向量来表示,节点之间的连接可以通过边来传递。鉴于图神经网络算法的复杂性,目前大多数图神经网络的层数较少。为了更好地适应 FSL,图神经网络在最近的发展中采用了独特的节点和边设计。下图从探索小样本分布的角度展示了图神经网络 FSL 的最新代表性算法。
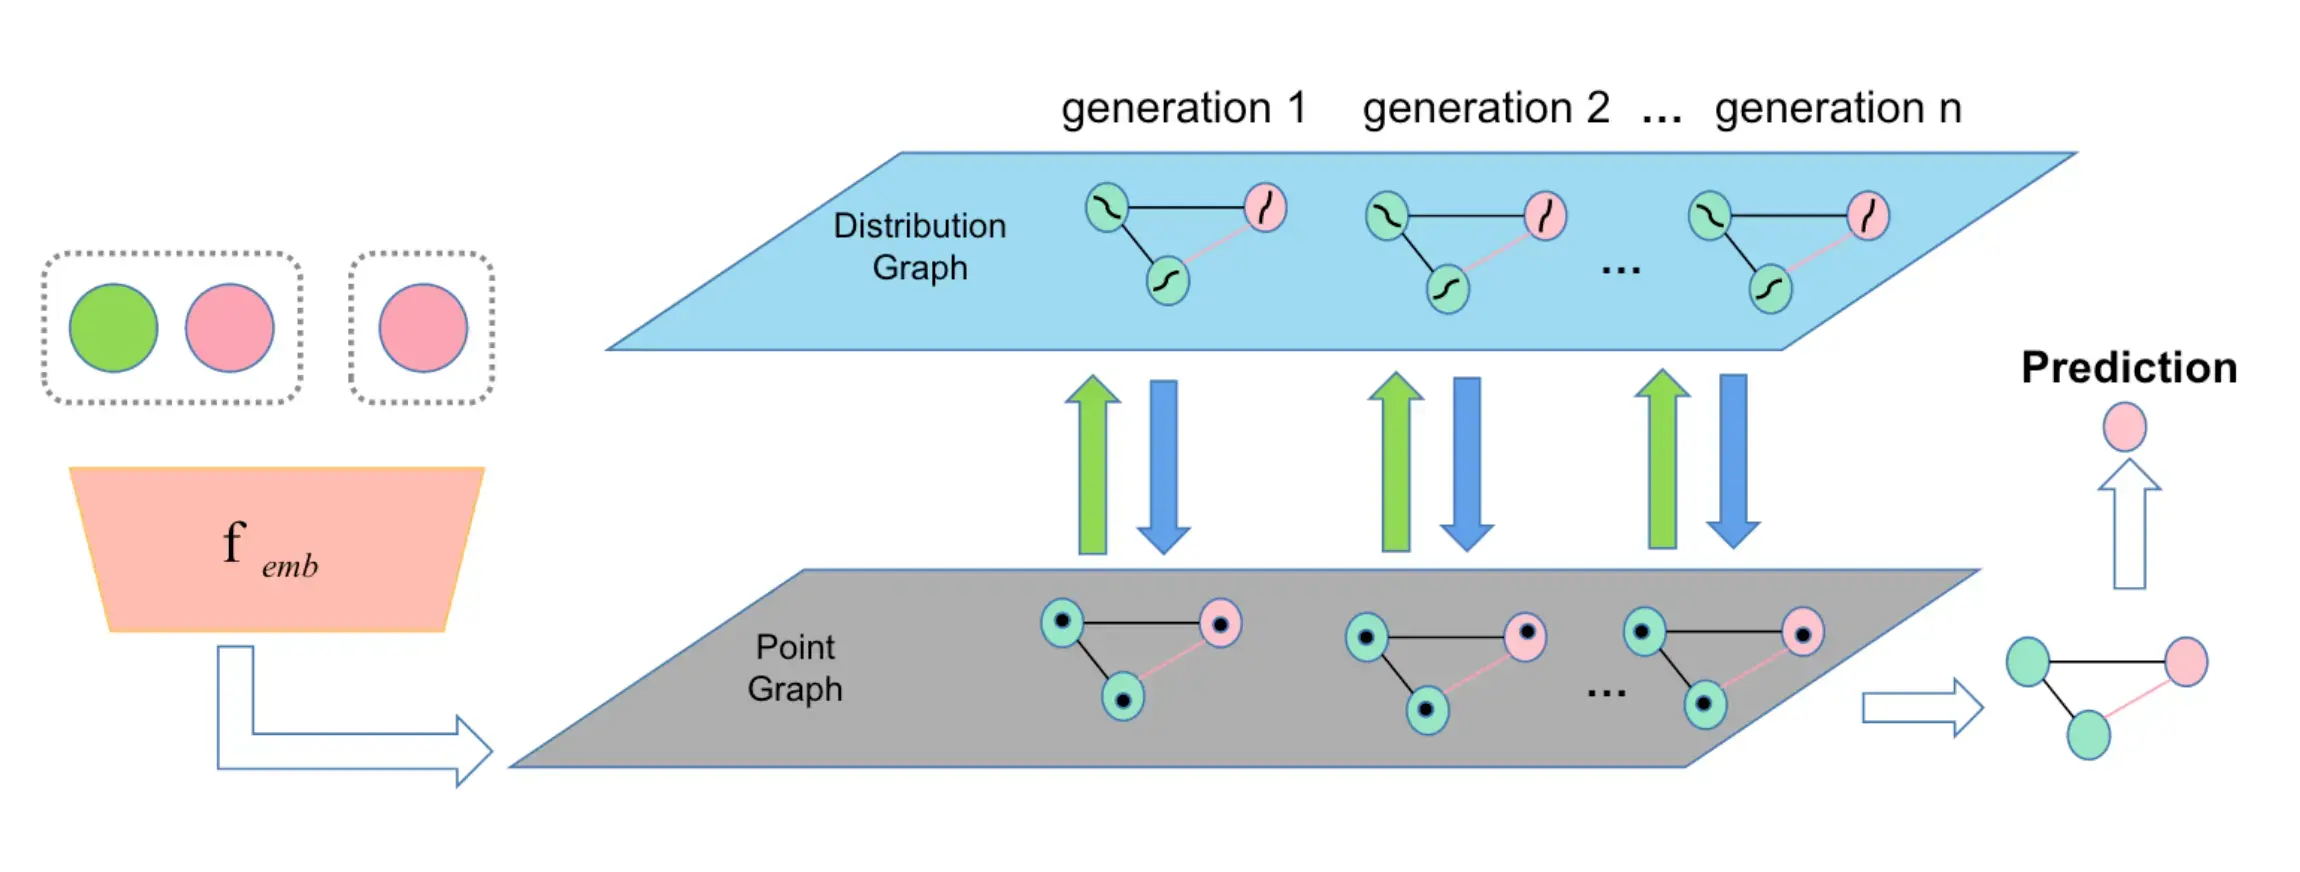
等变图神经网络(EGNN)使用顶点集、边集和任务集来编码节点的标签。当节点之间发生更新时,相似性和差异性都会被考虑在内,这大大提高了图神经网络对 FSL 的泛化性能。目前,图神经网络已被广泛应用于小样本图像分类、语义分割和实例分割等任务中。
讨论与总结
在 FSL 中,元学习主要探索从任务到目标模型的映射。它可以训练一个 Super-Tuning Device,在根据不同任务收敛时提供一组良好的超参数,与多任务学习相比,元学习只关注单一任务。然而,元学习并不是适用于所有条件的通用方法。目前元学习的理念是要有足够多的历史任务。如果在某些问题上没有足够的任务,那么元学习可能无法解决这些问题。同样,如果源和目标之间的领域差距太大,结果也会变得很糟糕。
对信息有限的小样本进行多模态互补学习
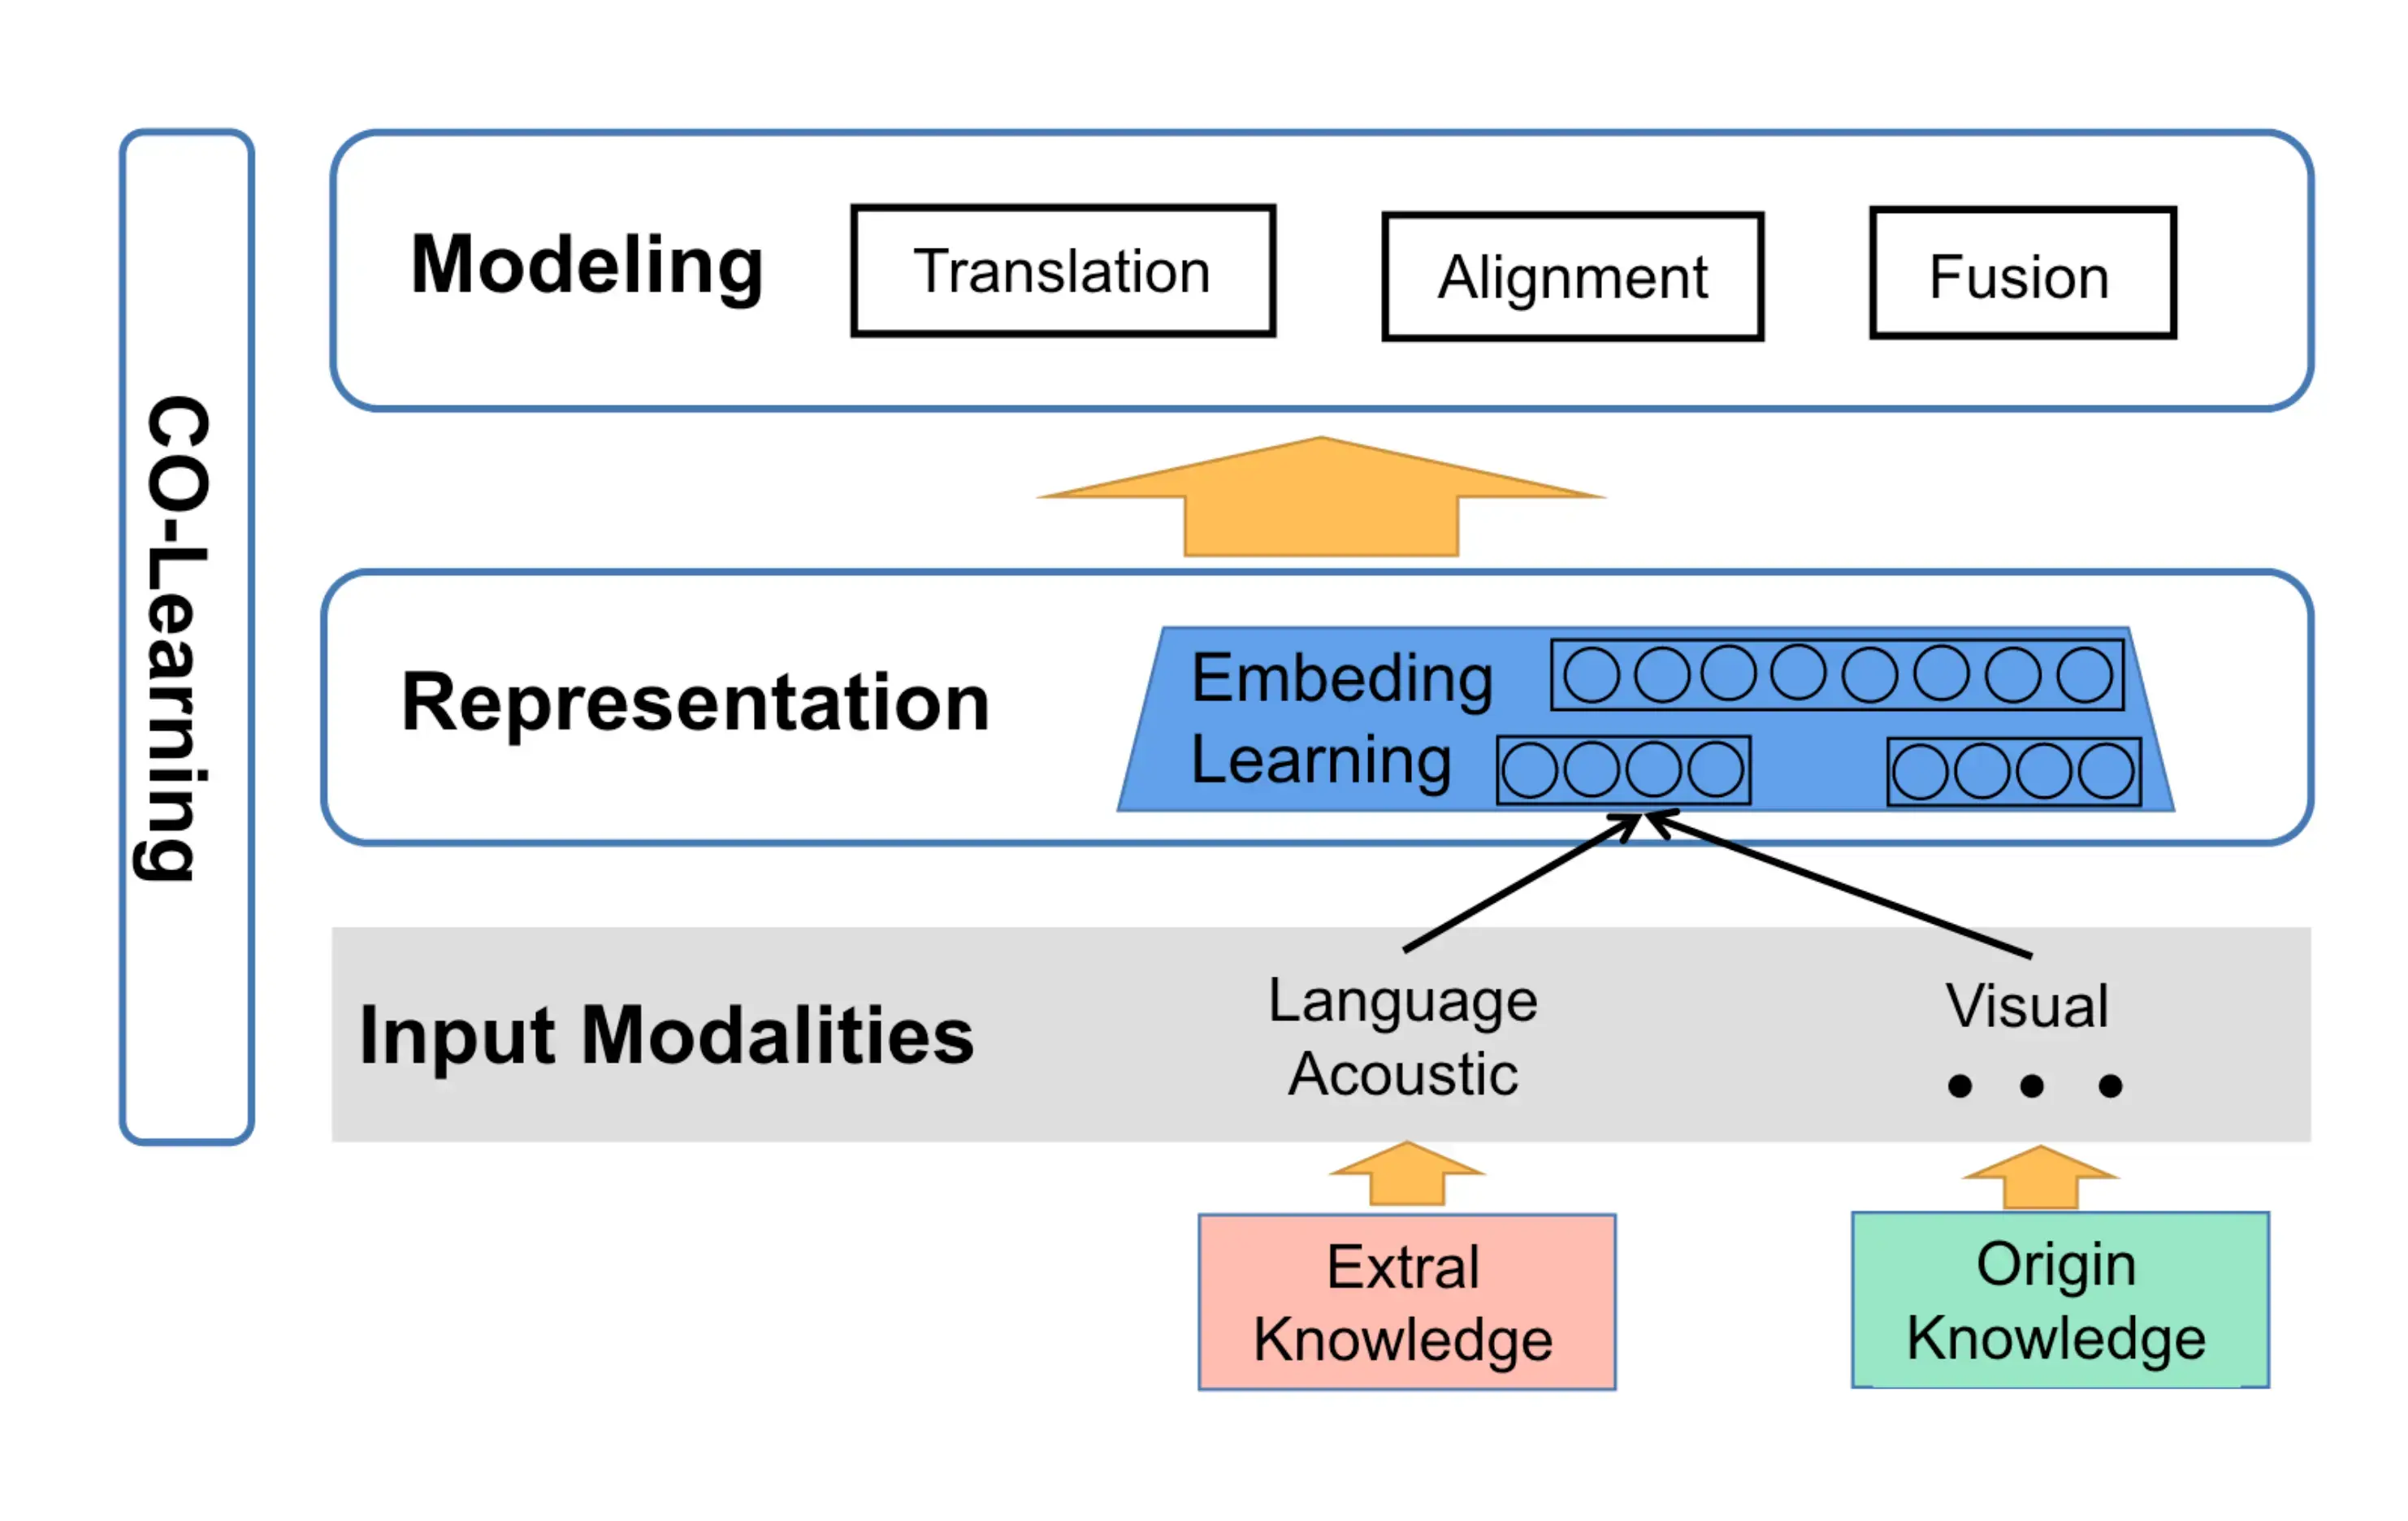
迄今为止,FSL 在单模态领域取得了重大进展。在单模态学习中,模型主要负责将信息表征为可由计算机处理的特征向量,或进一步抽象为更高层次的语义向量。特别是 FSL 中的多模态学习是指通过利用多种模态之间的互补性和消除模态之间的冗余来学习更好的特征表征。在现实生活中,父母在教宝宝认识事物时,总是在提供一般信息的同时提供语义描述。这对于 FSL 来说是至关重要的,因为 FSL 本身就没有什么有效信息来对数据或特征分布进行良好的评估。受此启发,许多研究工作都考虑在解决 FSL 时引入其他模态信息。通过融合多模态信息,可以提高模型感知小样本数据的能力。
多模态嵌入
最近的研究证明了视觉特征在某些任务的 FSL 中的局限性。语义空间作为辅助信息,可以为视觉特征提供有效的上下文,并帮助 FSL。实验表明,两种或两种以上模态的自适应组合比单模态 FSL 效果要好得多。
从图像中生成语义信息
除此之外,使用多模态 FSL 的另一个相关领域是文本到图像生成。在小样本视觉分类任务中,基于视觉和语义的方法具有相当大的优势,这些方法尝试使用文本描述来生成额外的训练图像。
同样,也可以将文本到图像的生成移植到了目标检测任务中,这可以与当前的 FSL 相结合,在上下文联合学习阶段实现更通用的模块。
另一方法,文本到图像算法是基于带嵌入的变体自动编码器。与生成法不同,编码器的输入是一个属性向量。然而,这些方法无法在没有部分术语注释的情况下识别图像的部分内容。
讨论和总结
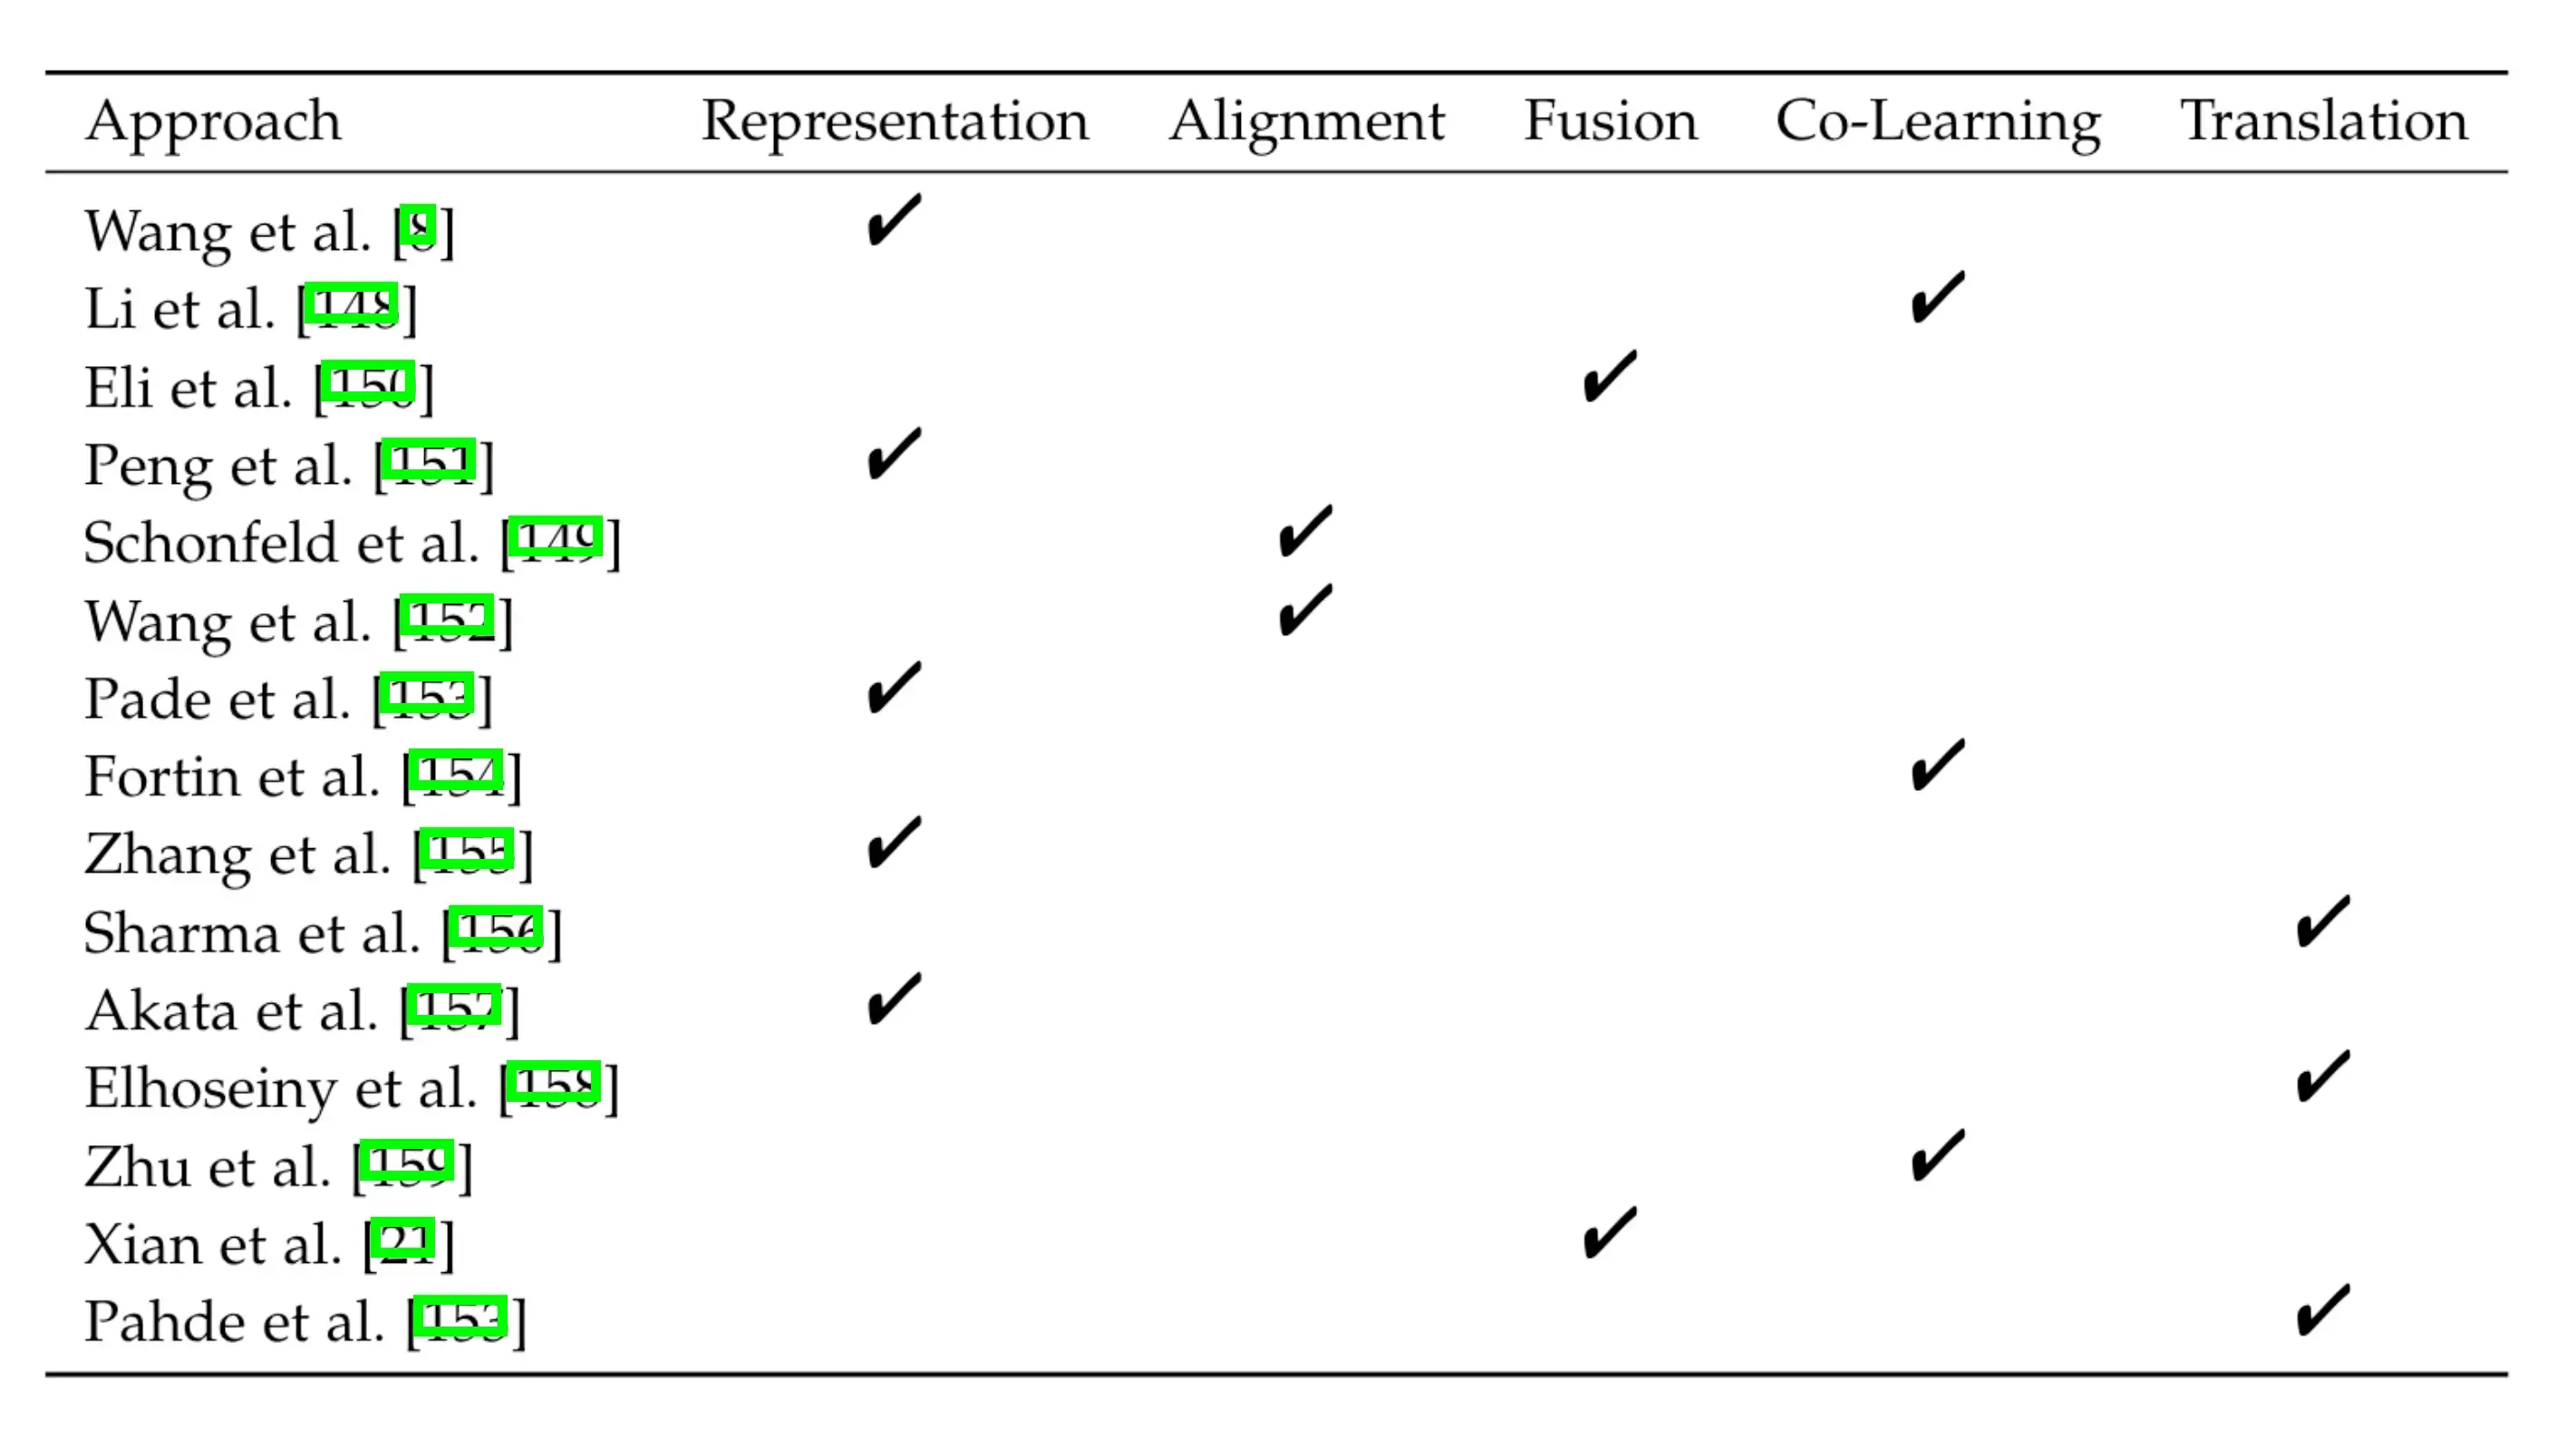
多模态 FSL 仍处于发展阶段,目前还面临着几个挑战:如何结合来自异构领域的数据,如何处理不同模态结合过程中出现的不同程度的噪音,以及如何共同学习。在多模态 FSL 中,一个好的特征表征应该能够根据观察到的模态信息填补缺失的模态。未来将出现更多方法,远远超出模态嵌入和从图像生成语义信息的范畴。
FSL 在计算机视觉中的应用
对计算机视觉领域将任务分为:
- 图像分类
- 物体检测
- 语义分割
- 实例分割
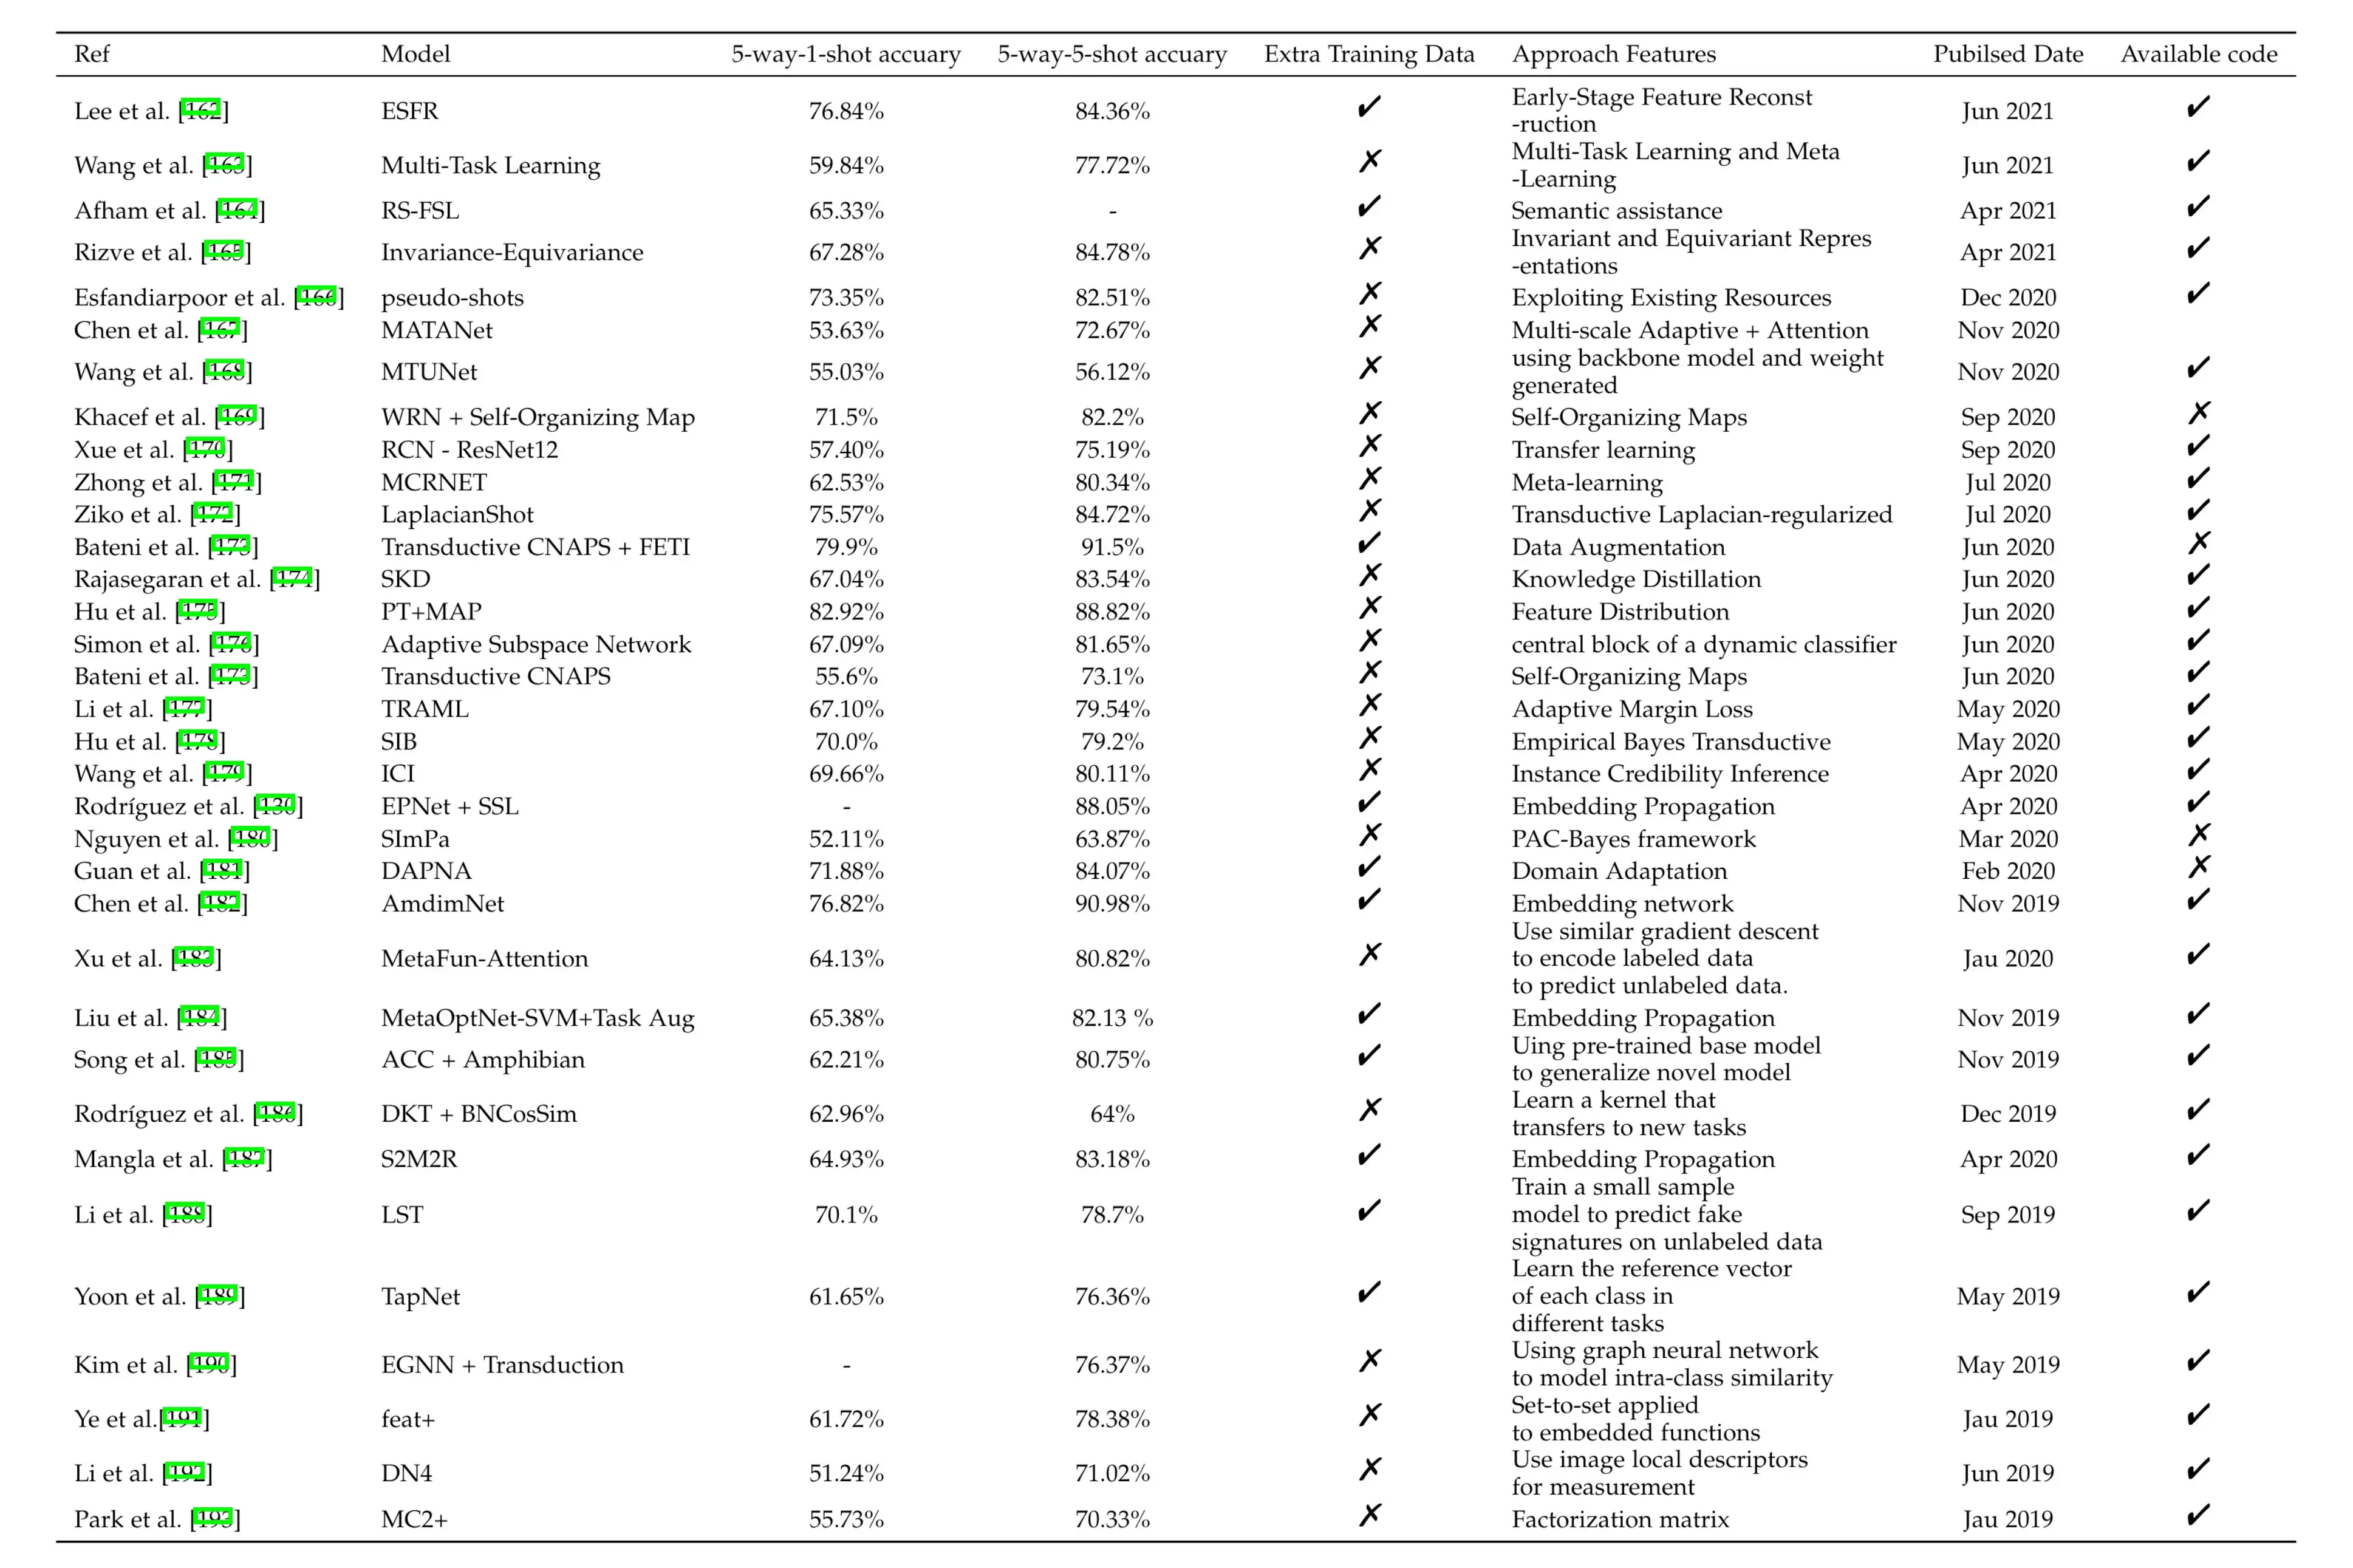
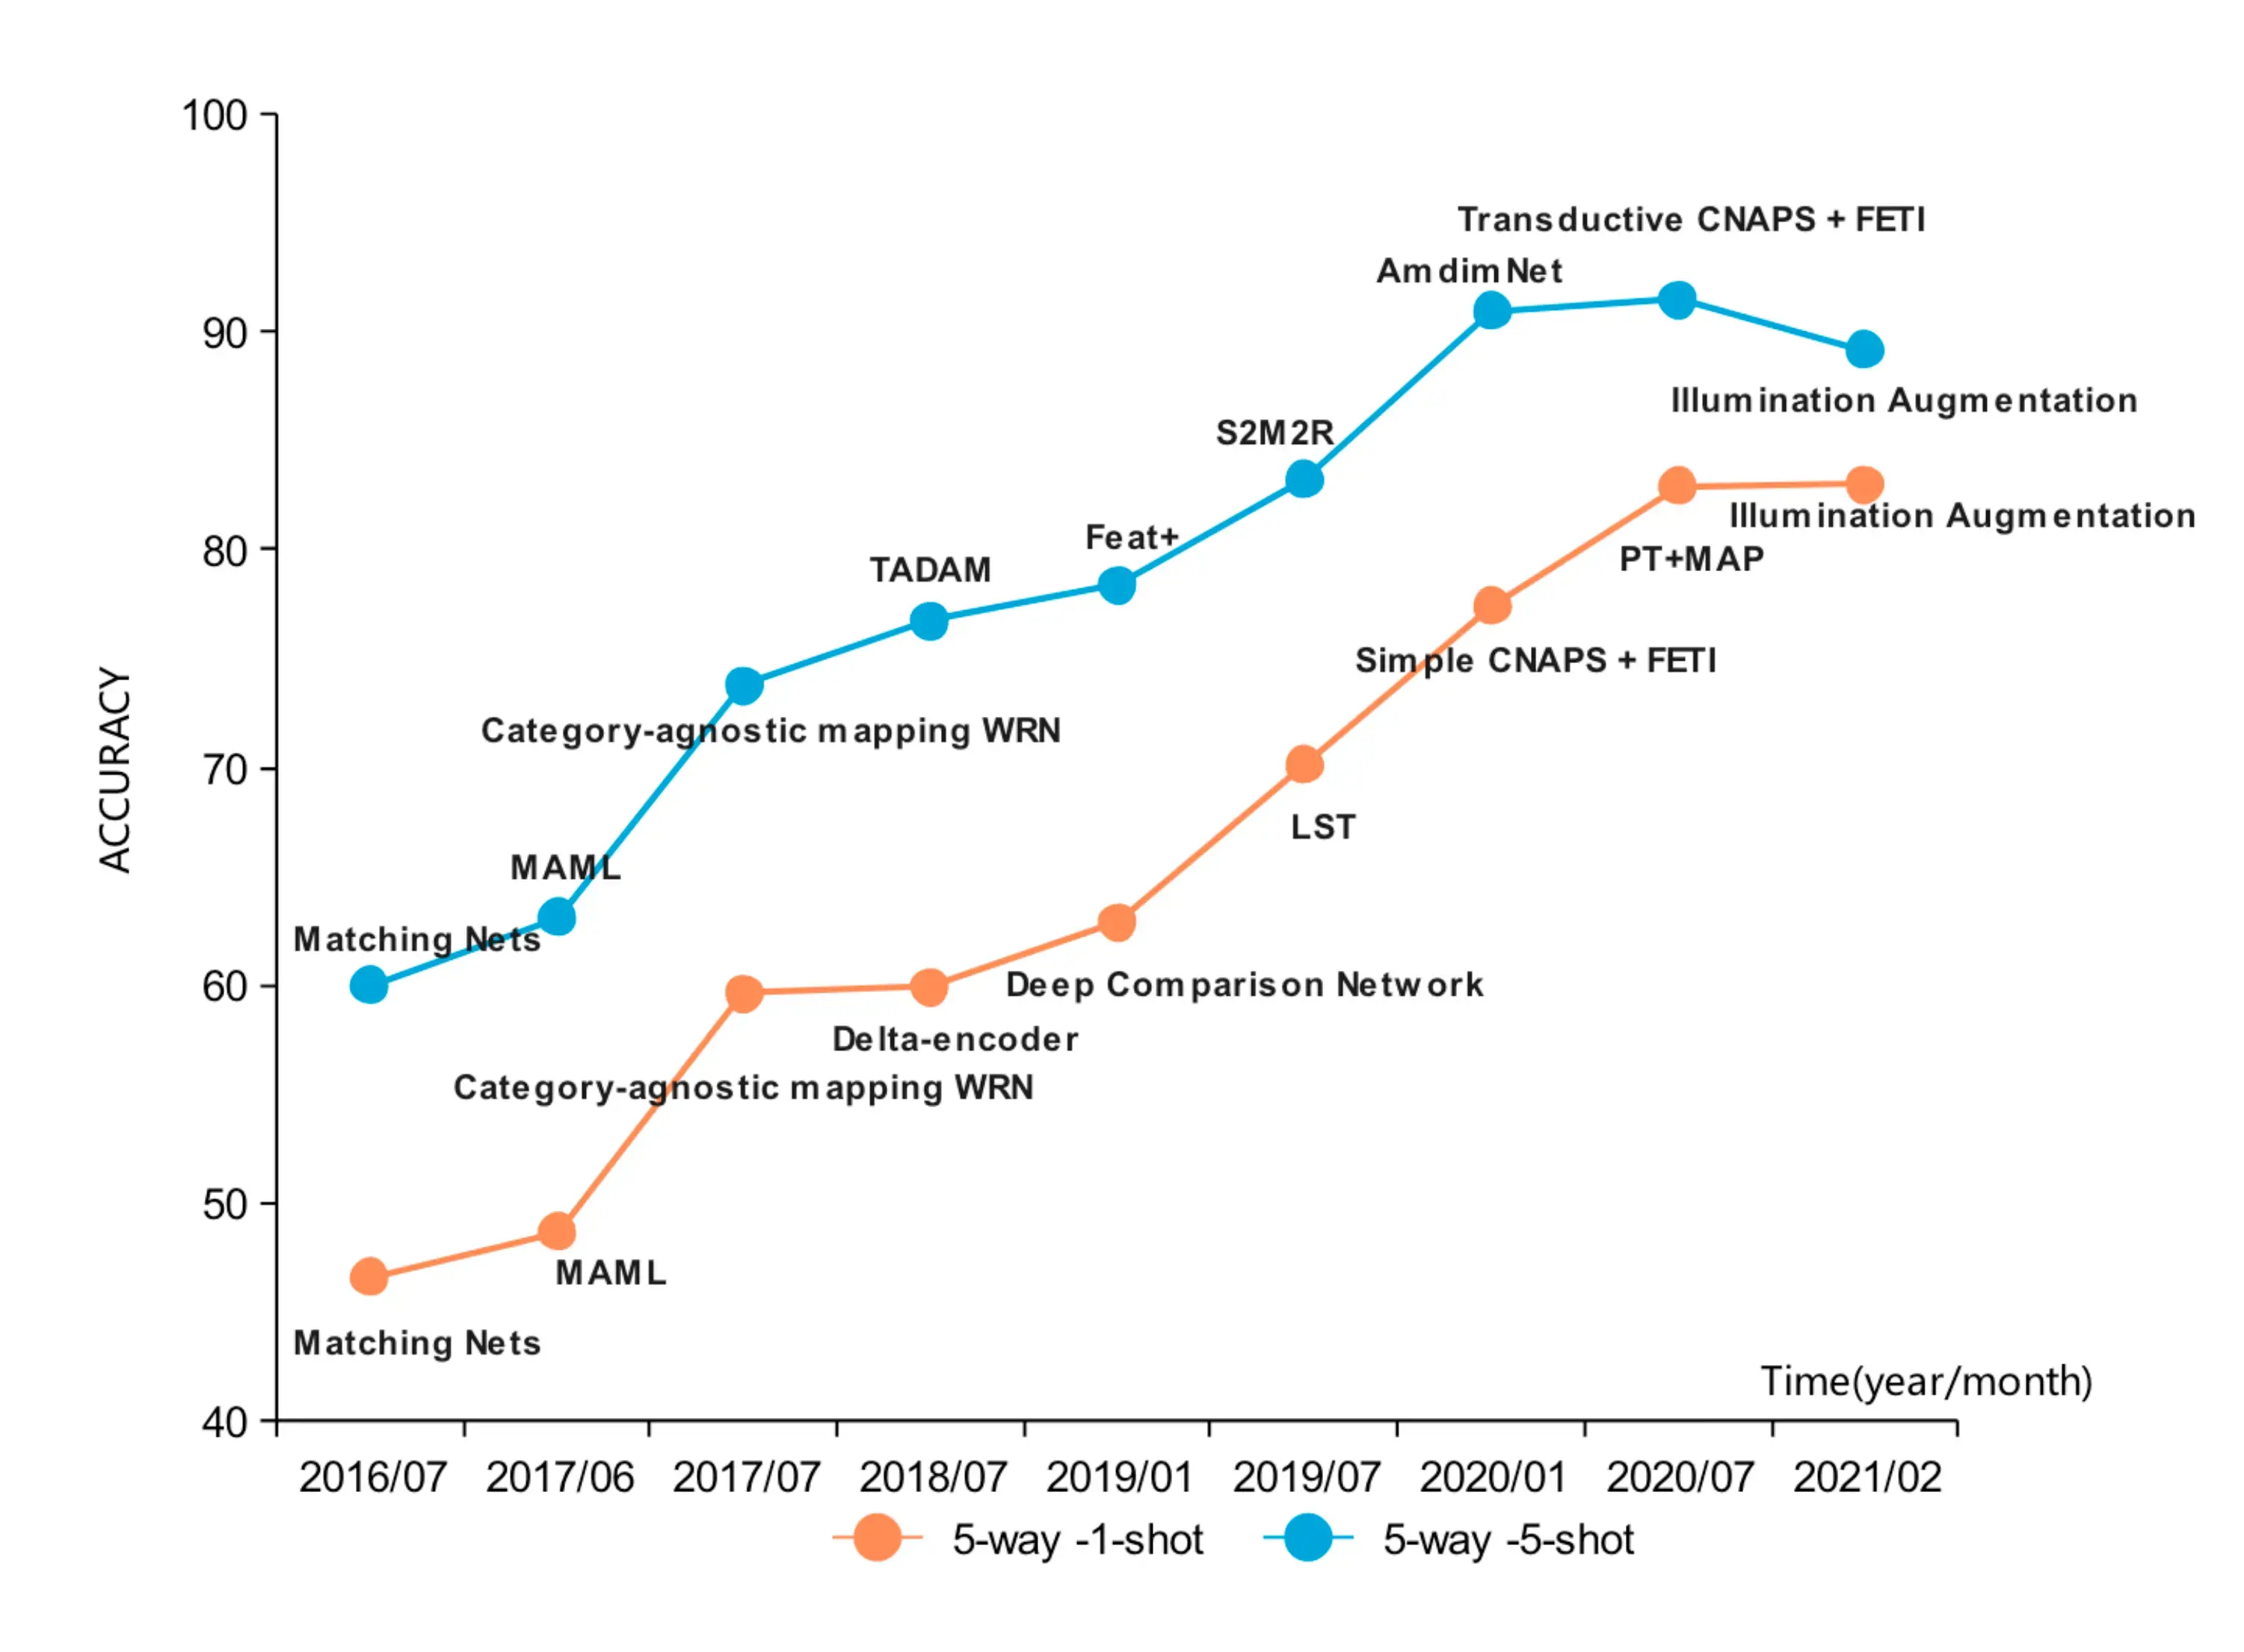
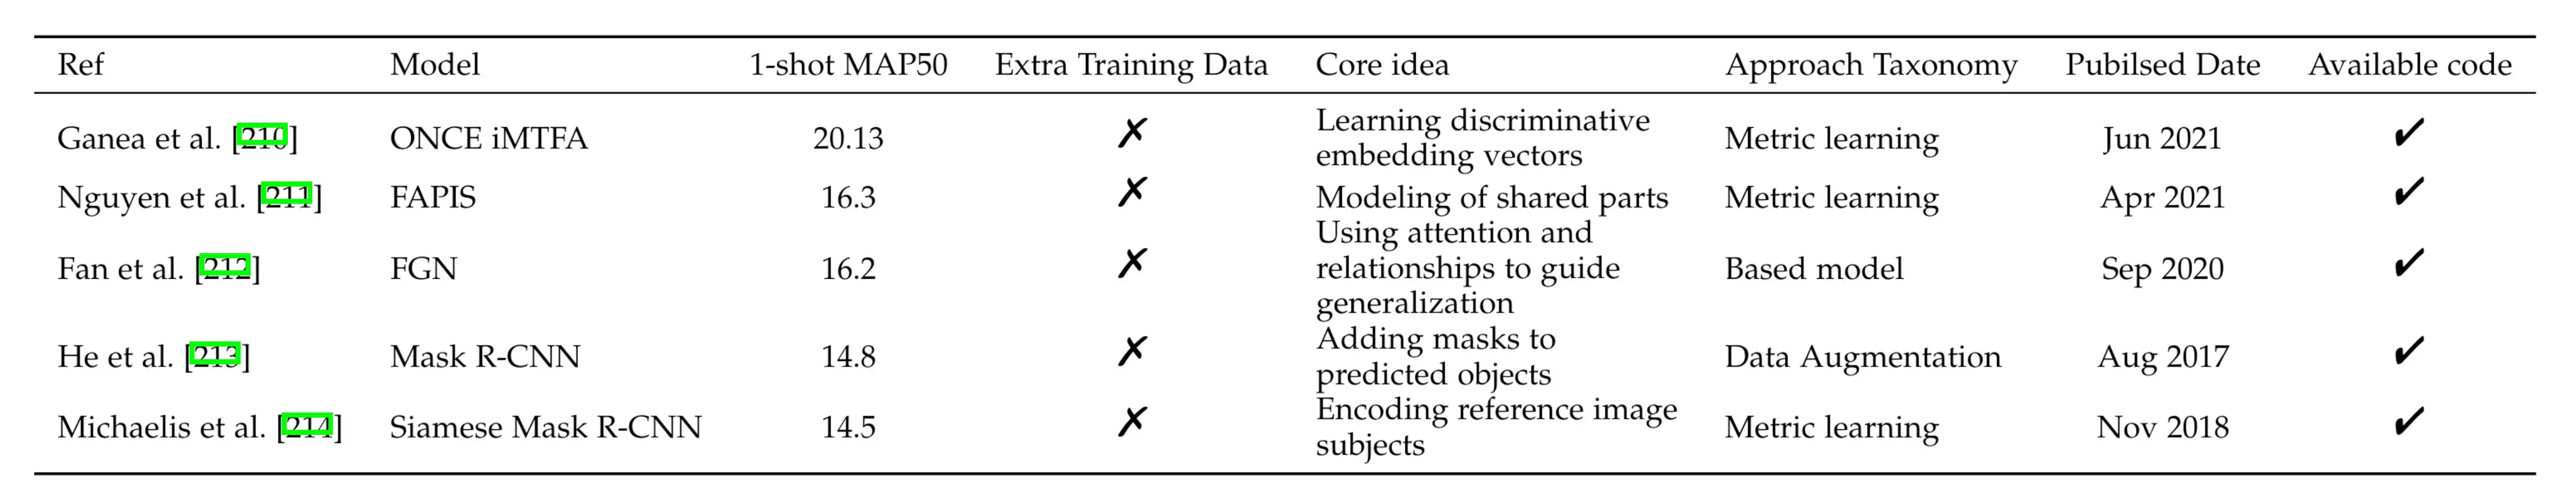
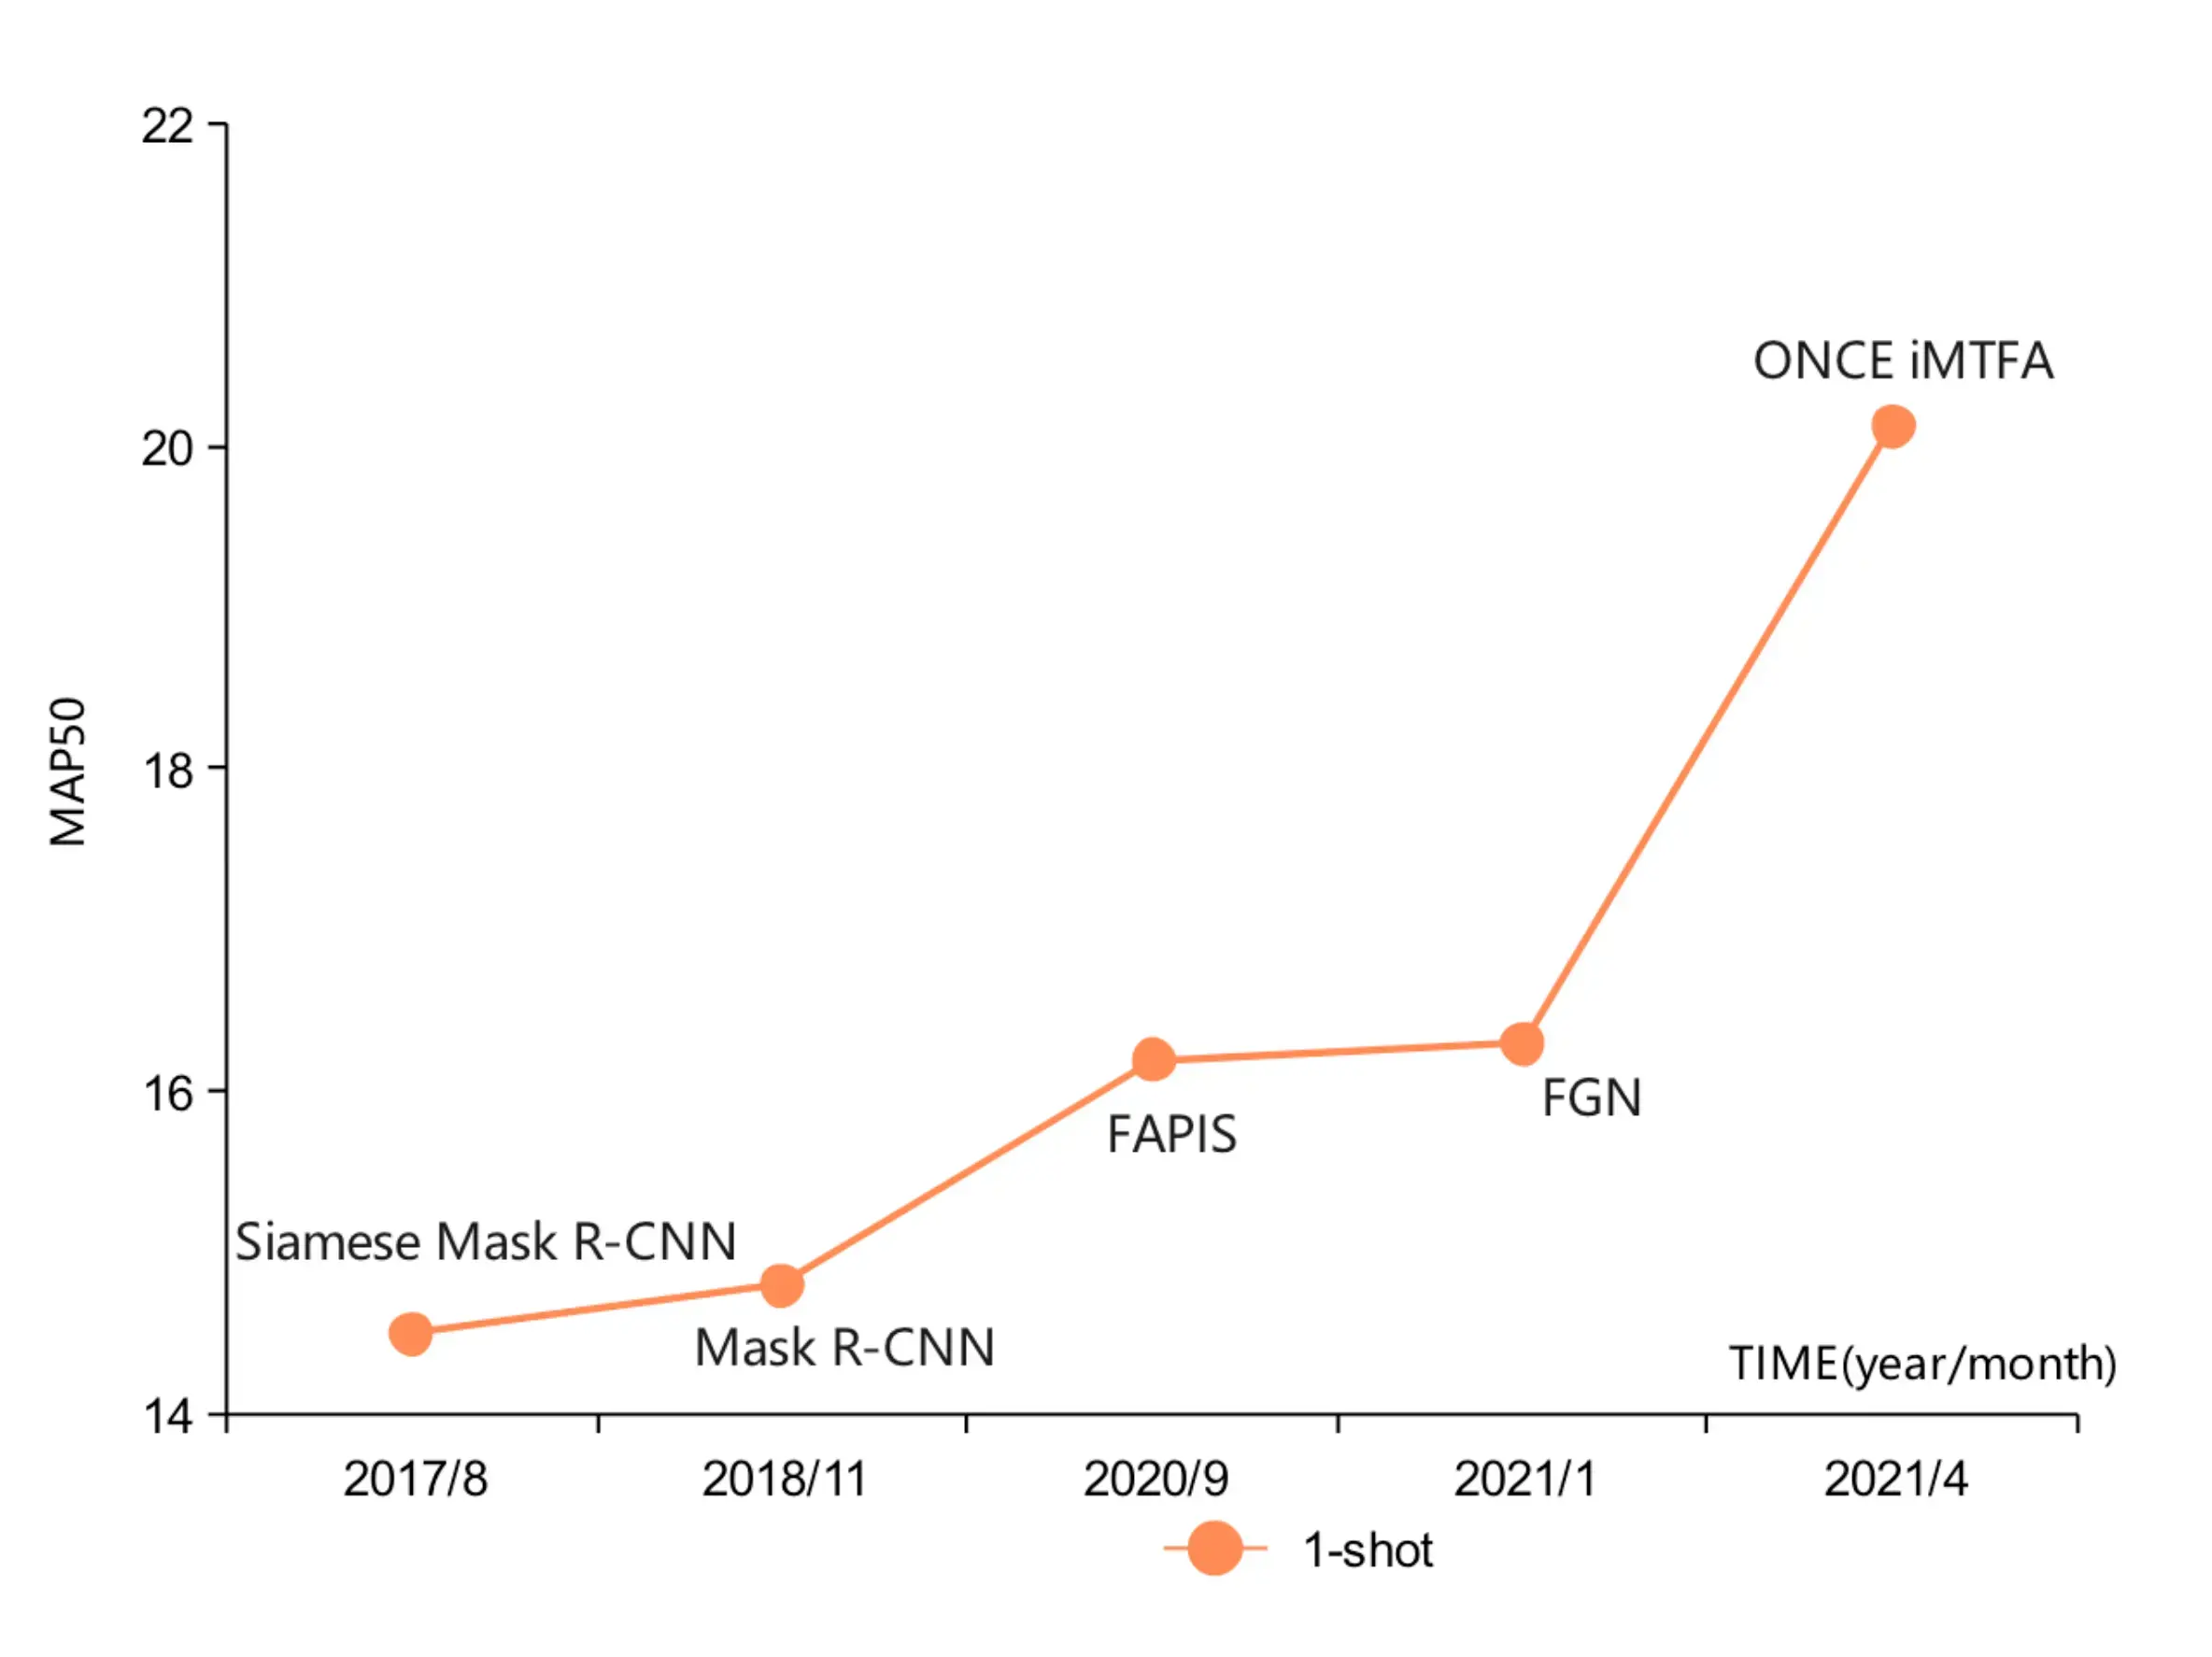
以下是基于时间维度以图和表的形式进行的详细总结。
小样本图像分类
除了谷歌和 Facebook 之外,现实生活中的大多数研究人员都无法获得大量高质量的数据集。在 FSL 计算机视觉分类任务中,每个任务可能只包含一个或几个样本。 解决少量图像分类任务的方法主要有数据增强、迁移学习、元学习和多模态融合学习。 目前,准确率排名前三的方法都是基于骨干模型的特征增强和特征转换。
小样本目标检测
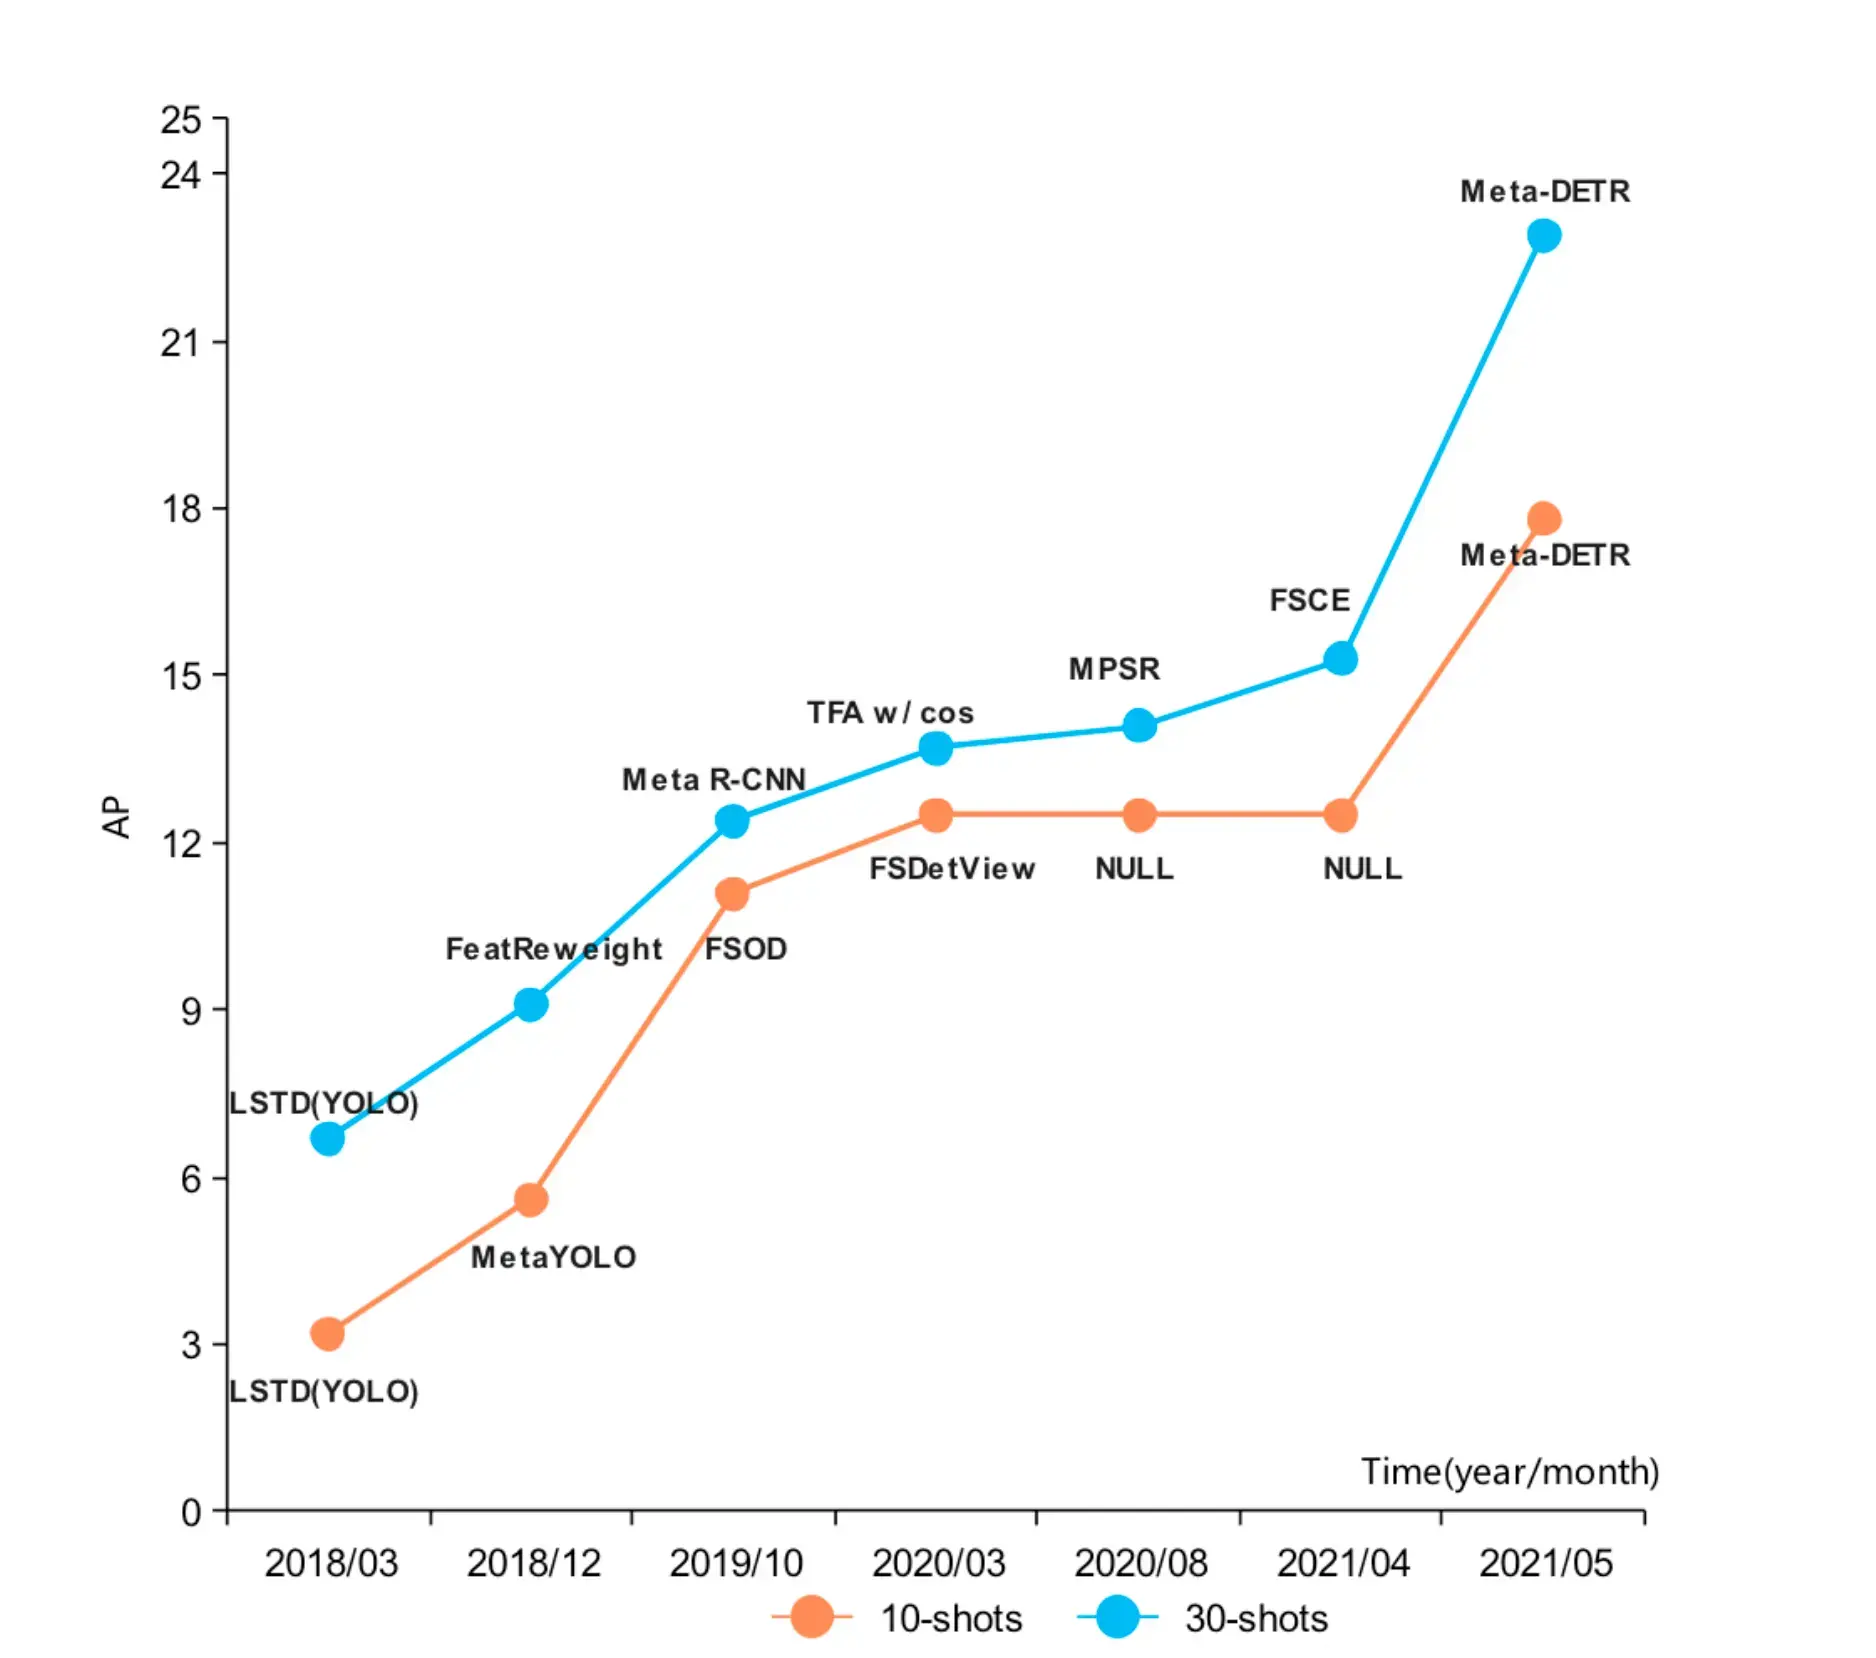
小样本目标检测(Few-shot Object Detection - FSOD)是从多个样本中检测稀有物体的任务。FSL 在图像分类方面取得了很大进展,但在物体检测方面却鲜有进展。目前,小样本目标检测的发展可分为三大阵营: 数据增强、迁移学习和元学习。其中,注意力机制在小样本目标检测中起着举足轻重的作用。 同样,为满足实时性要求,小样本目标检测推理速度慢的问题依然严重。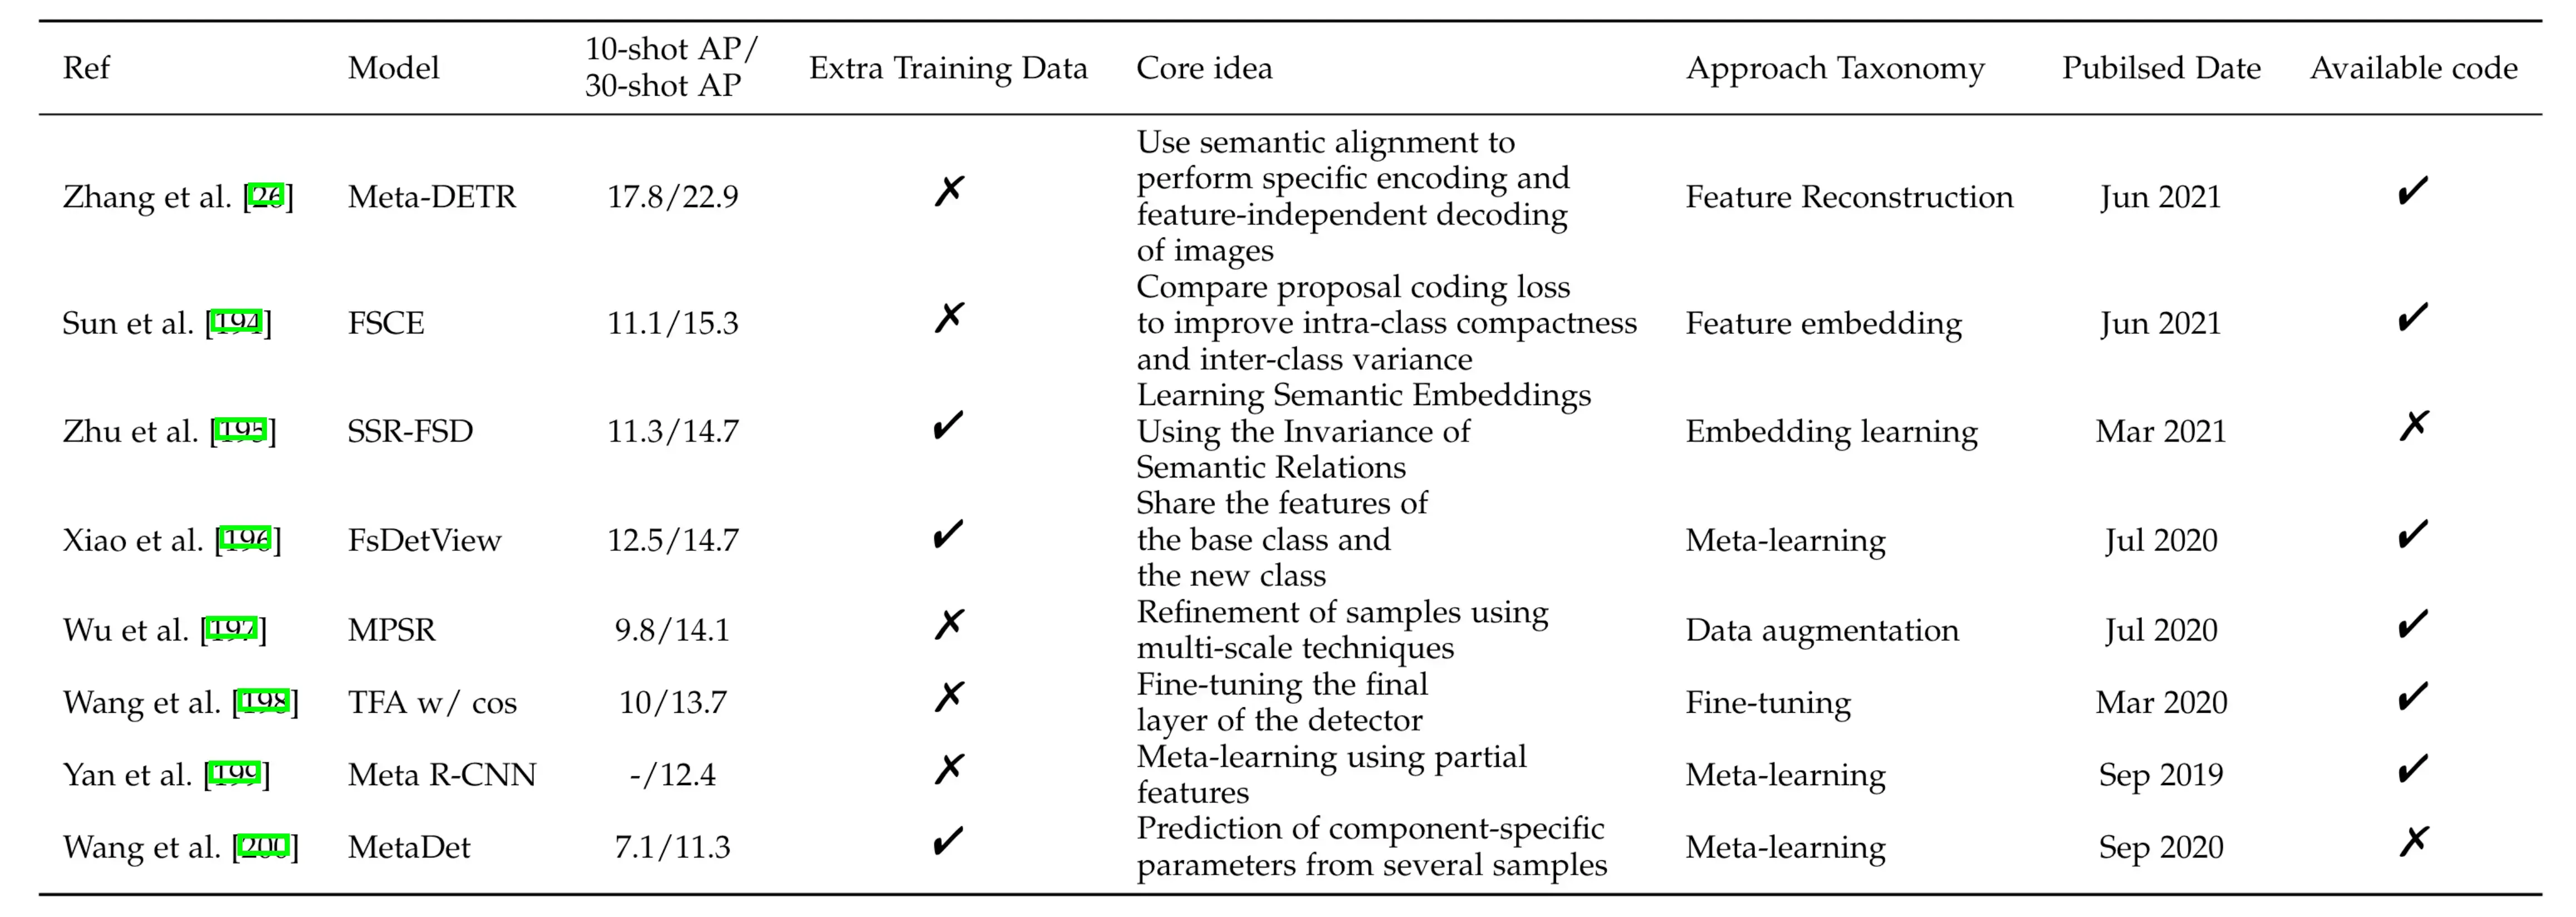
小样本语义分割
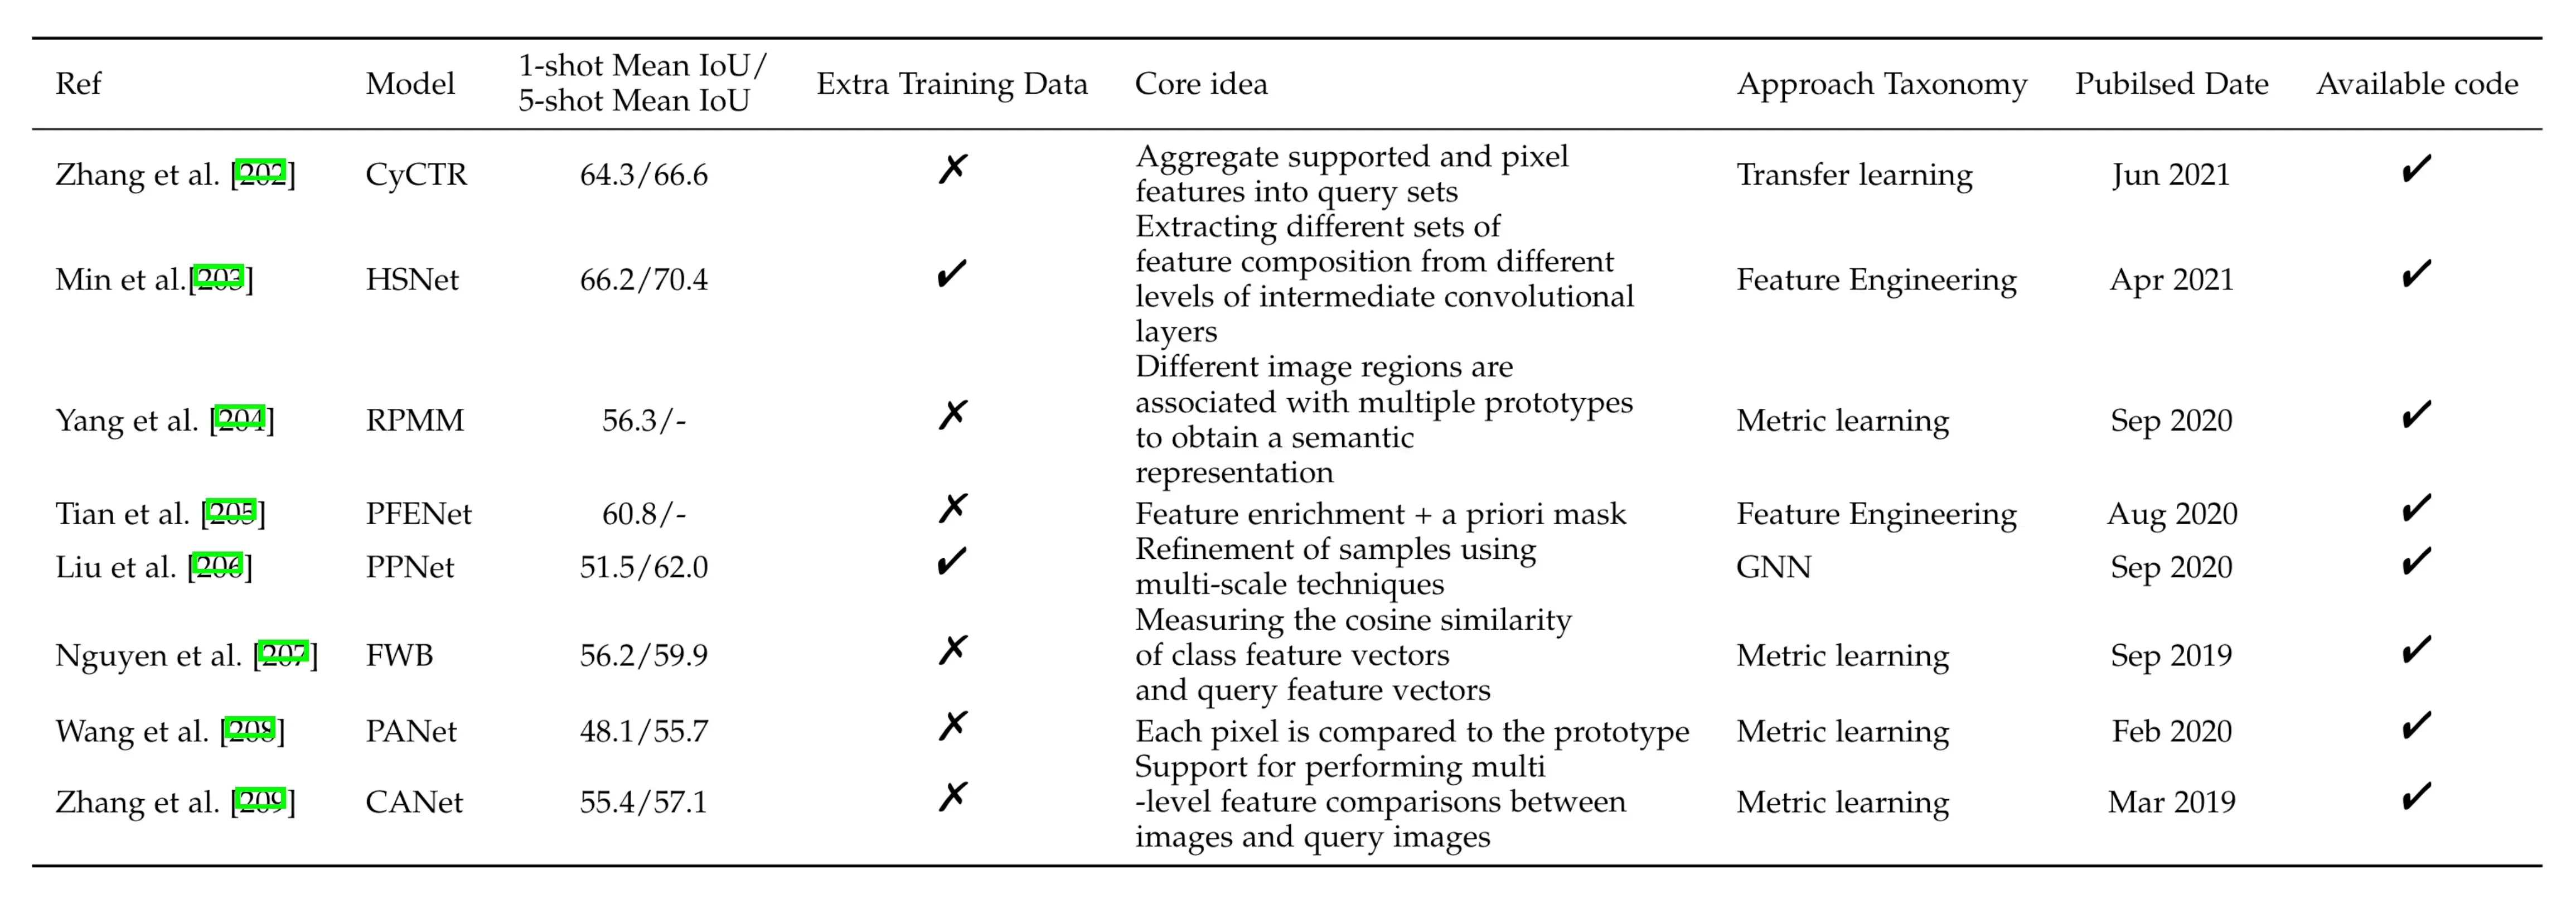
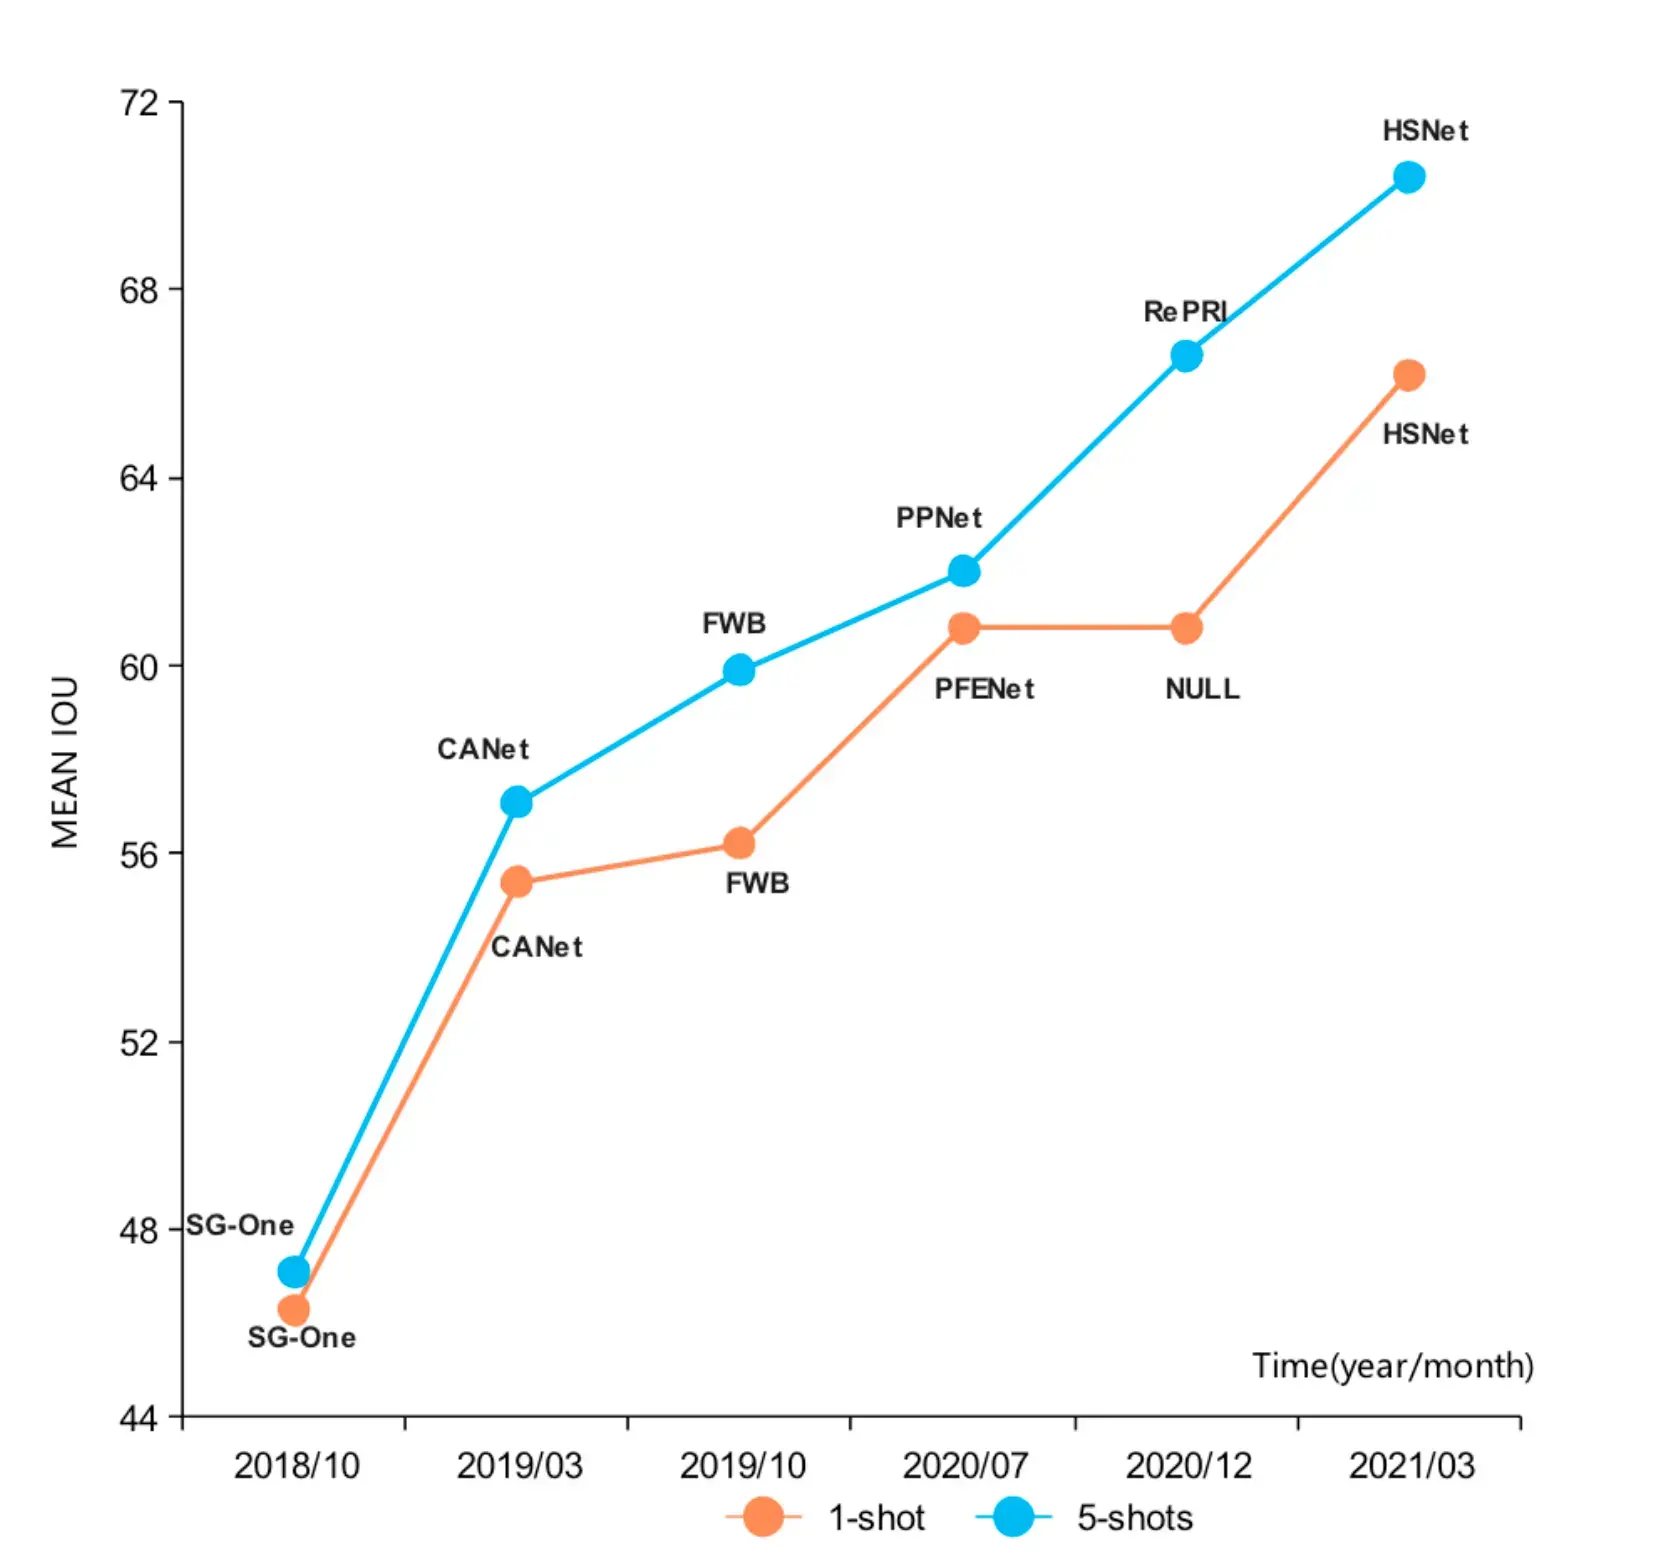
直到 2017 年,小样本语义分割技术才首次被提出。它已被广泛应用于医疗图像和无人驾驶汽车等场景。与传统的语义分割不同,小样本语义分割支持数据集中的像素注释信息较少。小样本语义分割大致可分为有监督语义分割、无监督语义分割和视频语义分割。在机器学习阶段,比较经典的方法是使用概率映射作为先验知识进行推导。在深度学习阶段,出现了大量高效的分割工具算法,但这些模型往往需要大量的人工样本注释。最近,有人提出了一种更简洁的范式,即只对分类器进行元学习,而特征编码解码器仍使用传统的分割模型进行训练,从而对小样本语义分割做出了重大改进。
小样本实例分割
与语义分割不同,实例分割涉及识别图像中的每个像素并对其进行单独标记。最近,很少有研究涉及分割小样本实例的问题,目前的工作仍集中在如何利用一些有效工具来改进 R-CNN 的问题上。最新的研究提出了一种增量式少量实例分割算法,大大提高了基准数据集的性能。
FSL 的未来方向和机遇
近期的大量研究工作在 FSL 的各种任务背景方面取得了可喜的进展。然而,对于更具挑战性的场景,训练数据集和验证数据集都很少,其他数据的分布既无法帮助评估真实样本,也没有广泛的训练数据或验证数据集用于迁移学习,此外,元学习也没有足够的任务来初始化参数。
更好地评估数据分布
FSL 的本质是 Support Set 太小,无法评估真实数据分布。那么,究竟怎样才能利用有限的样本最大限度地评估真实数据分布呢?最新的研究工作在这个方向上进行了有益的尝试,提出了分布校正的想法,即对基类的均值和协方差进行计算校正,然后直接使用线性分类器来获得良好的结果。事实上,当少量样本就能准确估计真实数据分布时,FSL 与传统深度学习之间的差距并不大,这是一个令人兴奋的探索方向。同样,在计算机视觉领域,FSL 也没有基于真实应用场景的任务背景或数据集,大部分工作仍集中在利用和挖掘图像数据中的信息。 目前的主流基准数据集或多或少都存在各种问题:mini-Imagenet 数据集存在一些不合适的样本或难度过高的样本,如实体遮挡、同一图像中的多个物体等;Omniglot 数据集离实际应用较远,不易在实际应用中得到启发;BSCD-FSL 提供了一个更加暴力的跨域 FSL 基准数据集,涉及卫星图像和医学图像。 到目前为止,还没有一个基准数据集可以评估模型在细粒度细节上的泛化能力。开发并完成 FSL 领域的基准数据集将为当前的 FSL 技术水平提供更真实的评估。
提高数据到标签映射的稳健性
BSCD-FSL 的出现对 FSL 提出了新的挑战,它的出现探索并揭示了当前 FSL 解决方案在跨域学习方面的局限性。最近的研究在这一领域取得了一些出色的成果,例如巧妙地设计任务调整、更复杂的超参数调整、辅助数据集的形成以及提取与领域无关的特征。目前,微调技术已经在迁移学习和元学习的交叉点上表现得非常稳健。不过,这两种技术仍有很大区别。预训练可以看作是学习许多类别的任务,但它是单一任务学习。元学习则是一种多任务学习方法。是否有更好的模型能将元学习和微调结合起来,在降低元学习的计算复杂度的同时最大限度地提高模型的性能,是目前值得研究人员深入探讨和交流的方向。
从历史任务中更有效地学习元知识
元学习仍然局限于在确定的网络结构下特定任务空间中的表现。就分类任务而言,目前只能考虑分类任务之间的关联。是否有可能建立一个能同时考虑分类、检测、预测和生成等任务的框架?这样就能在一定程度上将元学习从任务概念中分离出来。最近的一些工作试图将每一小批量作为一个整体进行优化。在这种情况下,如何优化内循环将是高效应用的一个重要优化方向。未来,预训练和微调将成为 FSL 的主流算法。目前,元学习仍在探索任务之间的相关性,尚未出现相关理论来解释元学习背后的因果关系。随着因果关系理论框架的发展,元学习可能会趋向于成为一个更通用的框架。
多模态信息的全面融合
多模态学习是目前解决 FSL 问题的一种新兴方法,它可以在没有监督信息的情况下自动学习边缘场景中的小样本任务,并快速迁移到不同领域的数据中。它被广泛认为是从有限领域的弱人工智能向通用人工智能的路径探索。在多模态学习场景中实施预训练和微调,可以在很大程度上实现在不同任务中使用统一的特征表示。例如,跨模态理解和跨模态生成。多模态预训练模型的出现可以支持多种任务,在多种场景中进行泛化,并具有很强的规模泛化和复制能力。在融合两种或多种类型的信息(包括语义信息)方面,已经开展了大量工作。不过,主要工作仍集中在像素和语义信息上,功能相对单一。为了有效解决多种模式下的特征重用问题并降低数据标注的成本,业界迫切需要实现一个强大的预训练模型,其中涉及三种或更多模式的融合。
结论
作为深度学习的一个重要分支,小样本学习(Few-Shot Learning)不需要大量数据,而是选择一种更柔和的方法来解决问题,它可以与迁移学习、机器学习和数据增广等技术完美结合。