FreeMatch: Self-adaptive Thresholding for Semi-supervised Learning
ABSTRACT
Semi-supervised Learning (SSL) has witnessed great success owing to the impressive performances brought by various methods based on pseudo labeling and consistency regularization. However, we argue that existing methods might fail to utilize the unlabeled data more effectively since they either use a pre-defined / fixed threshold or an ad-hoc threshold adjusting scheme, resulting in inferior performance and slow convergence. We first analyze a motivating example to obtain intuitions on the relationship between the desirable threshold and model’s learning status. Based on the analysis, we hence propose FreeMatch to adjust the confidence threshold in a self-adaptive manner according to the model’s learning status. We further introduce a self-adaptive class fairness regularization penalty to encourage the model for diverse predictions during the early training stage. Extensive experiments indicate the superiority of FreeMatch especially when the labeled data are extremely rare. FreeMatch achieves 5.78%, 13.59%, and 1.28% error rate reduction over the latest state-of-the-art method FlexMatch on CIFAR-10 with 1 label per class, STL-10 with 4 labels per class, and ImageNet with 100 labels per class, respectively. Moreover, FreeMatch can also boost the performance of imbalanced SSL.
- 背景:
- 现有半监督学习(SSL)方法常用伪标签和一致性正则化,但多数方法使用固定或手动调整的置信度阈值,限制了无标签数据的有效利用。
- 创新点:
- 提出 FreeMatch,通过模型的学习状态动态自适应地调整阈值(Self-Adaptive Thresholding, SAT)。
- 引入 自适应类别公平性正则项(SAF),鼓励模型在训练初期对各类进行多样预测。
- 实验结果表明,在极少量标注数据条件下,FreeMatch 相较于最新方法(如 FlexMatch)大幅降低错误率。
Introduction
- 强调深度学习对标注数据的依赖,收集大量标注数据昂贵而困难,故需要利用 SSL。
- 总结当前主流 SSL 方法,如伪标签和一致性正则化,但指出它们使用固定或手工调整阈值的问题:
- 固定高阈值会在训练初期过滤掉大量有用的无标签样本;
- 类别学习难度不同,阈值应区分类别;
- 现有的类比方法(如 FlexMatch)仍依赖全局固定阈值映射。
- 提出研究问题:
- 阈值是否应随模型学习状态变化?
- 如何自适应地调整阈值以提升训练效率?
A Motivating Example
对于二分类问题:
和分类器:
以及采用一个固定的阈值,可以证明的概率分布:
观察上面的公式,我们可以获得一些有用的结论:
- 首先,不难看出未标注数据的采样率是直接由决定的,越大,伪标签的数量越少。更有趣的是,当时, 。这可能导致伪标签分布不均匀从而损害模型表现。
- 同时,伪标签采用率随着变小而下降。换言之,两个类越接近,模型的置信度越低,因此也应相应降低以保证伪标签的分布均匀。
这些结论为我们设计自适应阈值提供了如下的启发:
- 在训练的早期,应该相对较小,以促使伪标签多元化,提升未标注数据的利用率,提升模型收敛速度。
- 随着训练的进行(变大),较低的阈值会导致确认误差。在理想的情况下, 应该随着变大以维持一个稳定的伪标签采用比例。
- 同时由于类内多样性()以及类邻接 (相对较小),某些类的分类难度要大于其余类,我们应该对每个类设置一个局部阈值。
FreeMatch
FreeMatch包含两部分:自适应阈值 和 自适应公平正则化惩罚。下面分别进行介绍。
SELF-ADAPTIVE THRESHOLDING
如下图所示,自适应阈值具体可以分为自适应全局阈值、自适应局部阈值。局部阈值旨在以类特定的方式调整全局阈值,以考虑类内多样性和可能的类邻接。
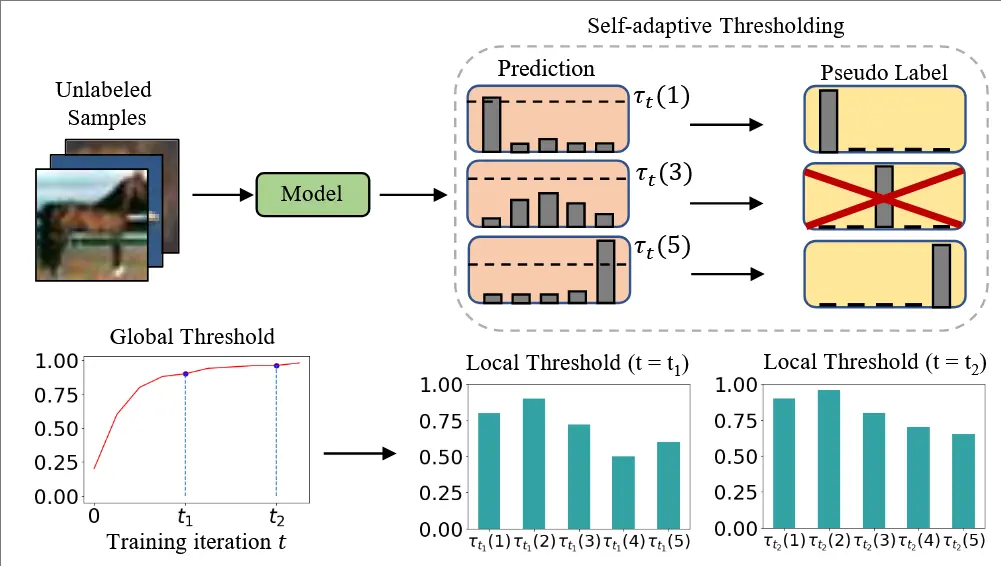
Self-adaptive Global Threshold
我们根据以下两个原则设计全局阈值。首先,全局阈值应该与模型对未标记数据的置信度相关,反映整体学习状态。此外,全局阈值应在训练期间稳定增加,以确保在训练后期丢弃噪声伪标签。我们将全局阈值设置为模型对未标记数据的平均置信度,其中表示第个时间步(迭代)。
然而,由于未标注数据数量庞大,在每个时间步甚至每个训练时期计算所有未标记数据的置信度将非常耗时。因此,我们将全局置信度估计为每个训练时间步长置信度的指数移动平均值 (EMA)。具体来说,我们将初始化为,其中表示类数。
具体而言,全局阈值定义和调整为:
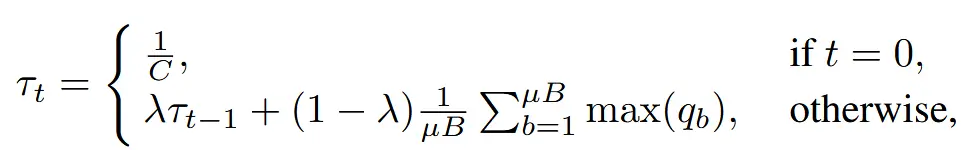
其中是 EMA 的动量衰减。
Self-adaptive Local Threshold
我们计算模型对每个类别的预测的期望,以估计特定于类别的学习状态:
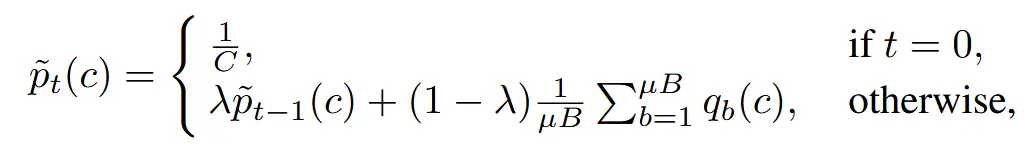
其中是包含所有的列表。
整合全局和局部阈值,我们得到最终的自适应阈值为:
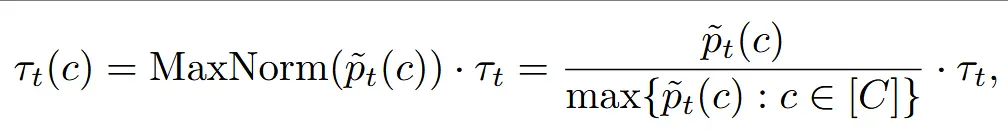
最后,第次迭代的无监督训练目标是:
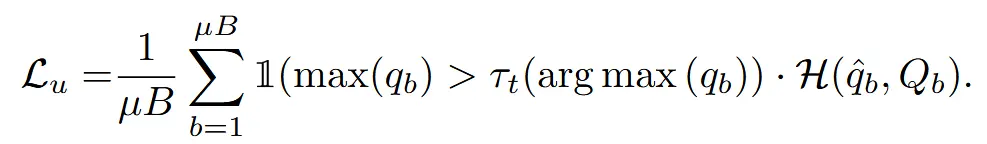
SELF-ADAPTIVE FAIRNESS
由于早期训练阶段模型尚未充分学习,可能会对某些类别特别有信心、而对其他类别不自信,从而导致:
- 模型倾向于只选择“容易预测”的类别伪标签;
- 造成类别不平衡 的训练,严重时会出现某些类伪标签数量几乎为 0;
- 对“难学类”不公平,导致模型误判严重。
SAF 的目标是鼓励模型在训练初期尽可能对所有类别产生“多样化”的预测,避免伪标签极端偏向于少数几个“容易类”。其设计了一个“伪标签类别分布”的损失函数,目标是让模型当前输出的类别分布尽可能接近它自己的长期平均分布(更稳定)。
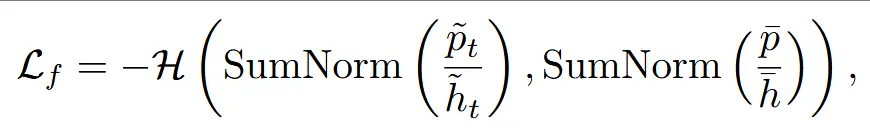
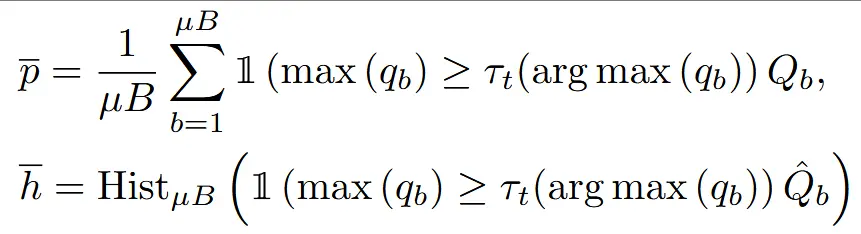
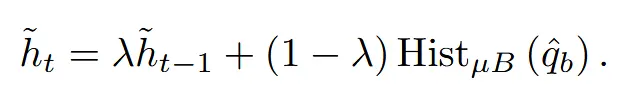
FreeMatch 的总损失为:
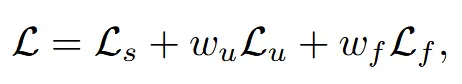
Experiments