Abstract
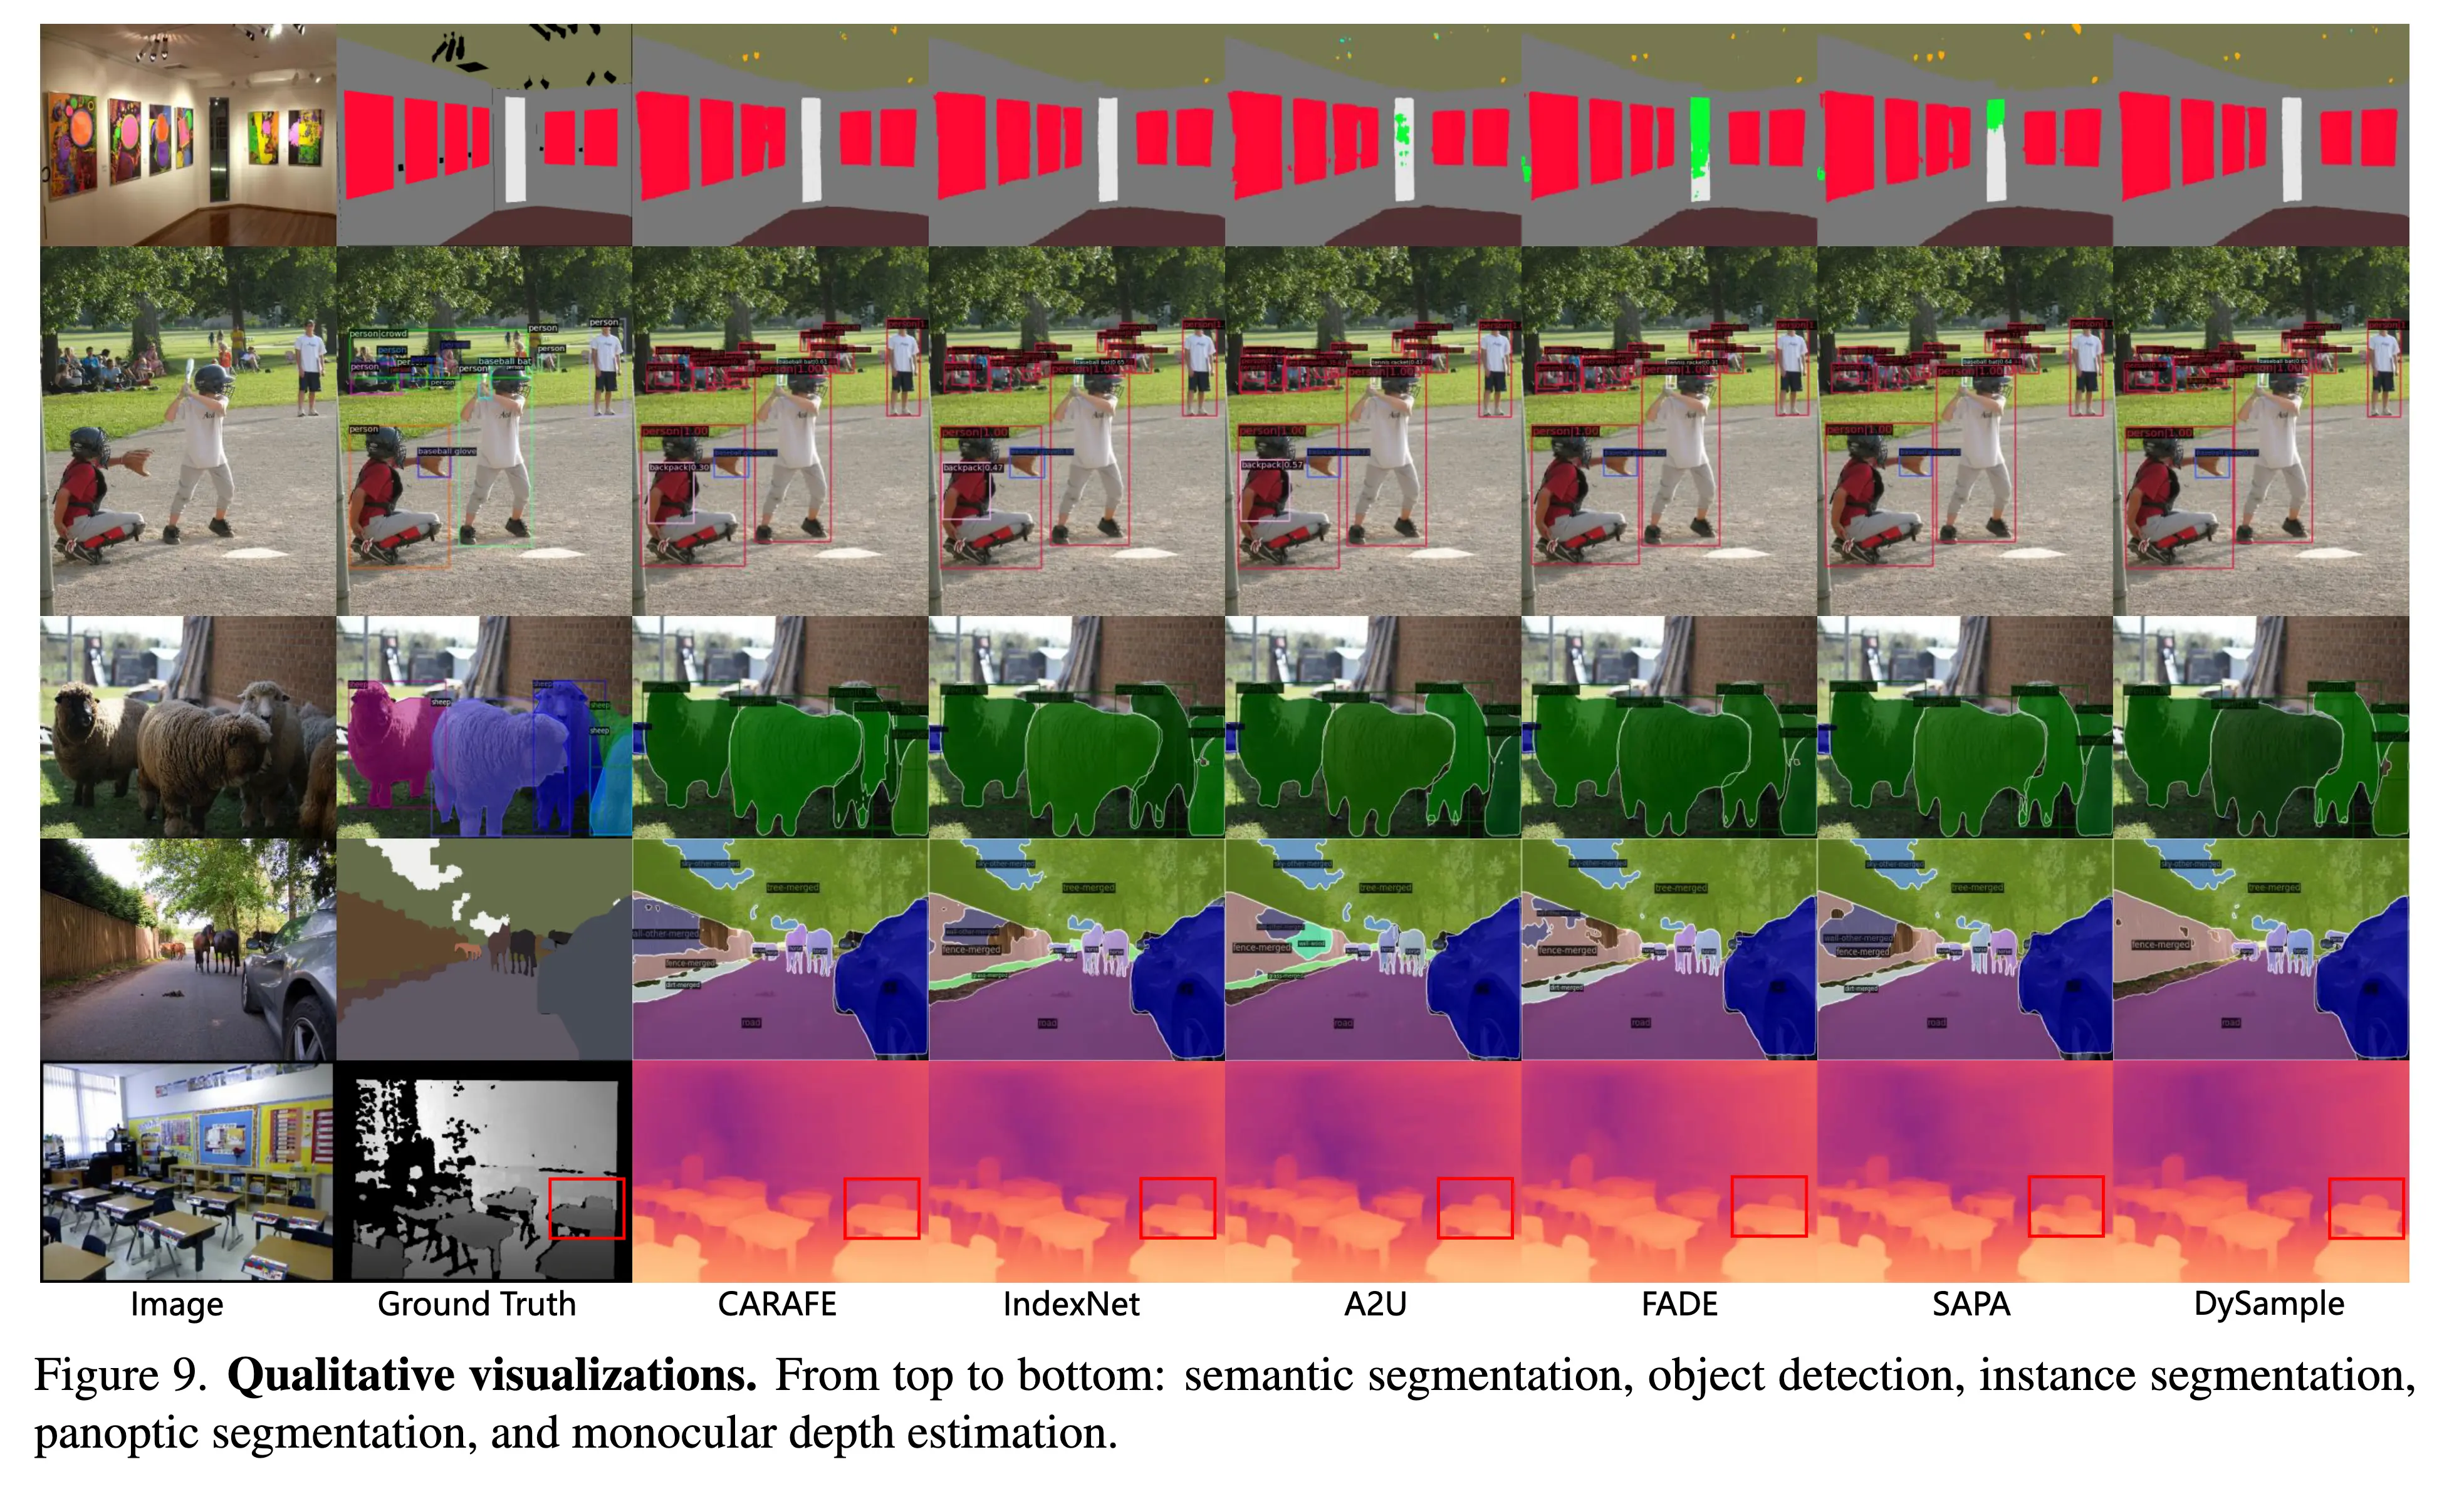
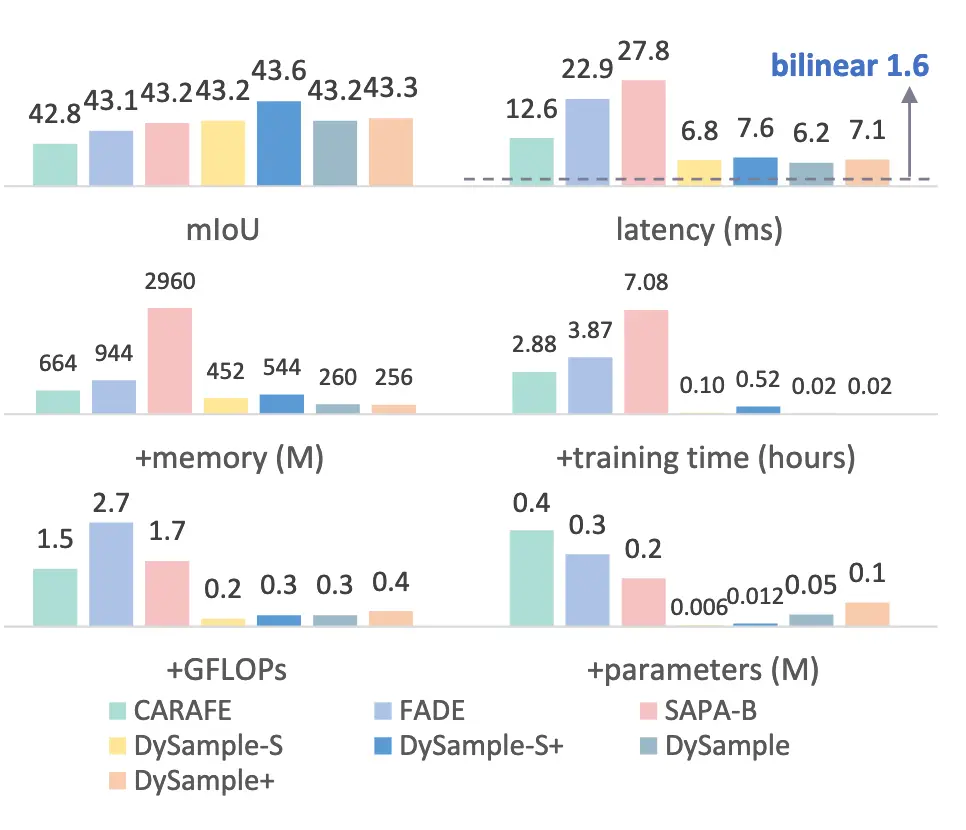
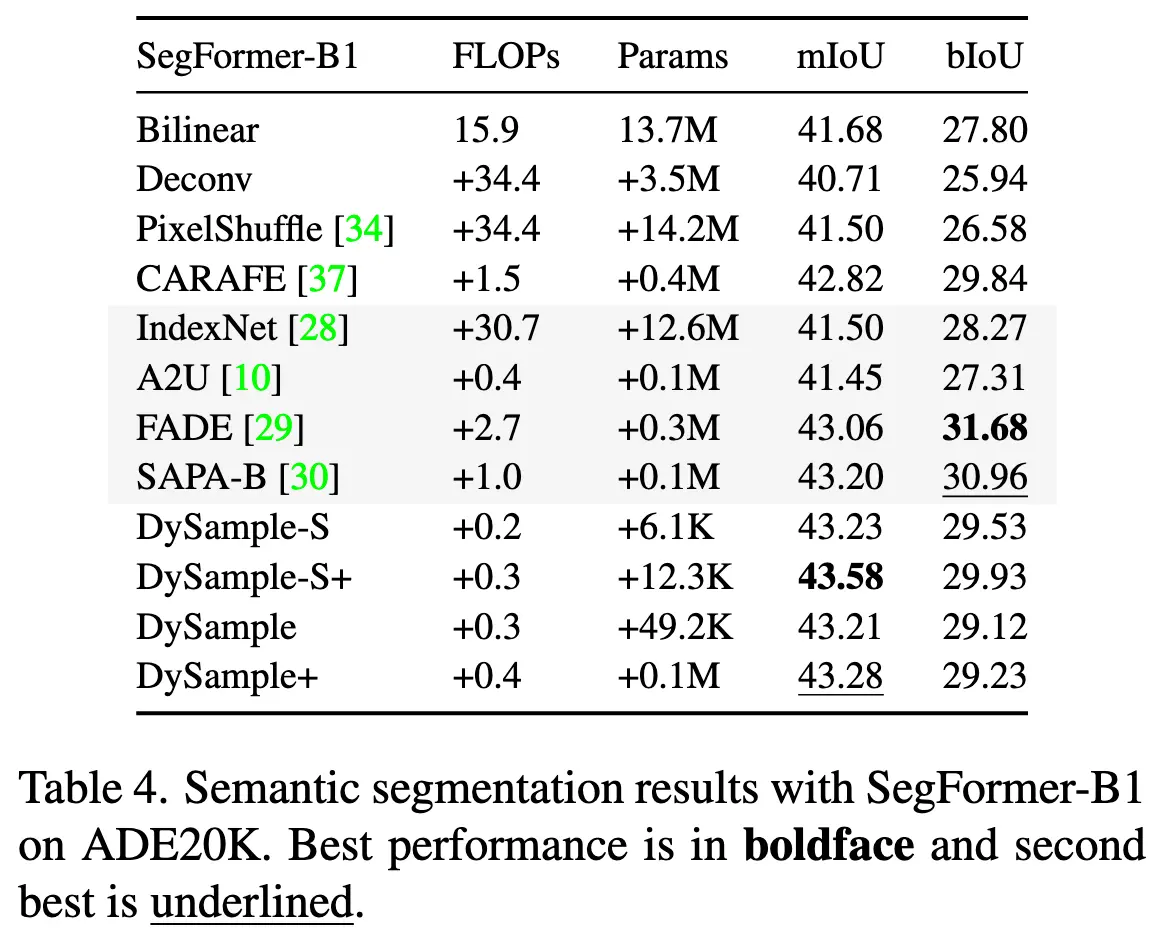
We present DySample, an ultra-lightweight and effective dynamic upsampler. While impressive performance gains have been witnessed from recent kernel-based dynamic upsamplers such as CARAFE, FADE, and SAPA, they introduce much workload, mostly due to the time-consuming dynamic convolution and the additional sub-network used to generate dynamic kernels. Further, the need for high-res feature guidance of FADE and SAPA somehow limits their application scenarios. To address these concerns, we bypass dynamic convolution and formulate upsampling from the perspective of point sampling, which is more resource-efficient and can be easily implemented with the standard built-in function in PyTorch. We first showcase a naive design, and then demonstrate how to strengthen its upsampling behavior step by step towards our new upsampler, DySample. Compared with former kernel-based dynamic upsamplers, DySample requires no customized CUDA package and has much fewer parameters, FLOPs, GPU memory, and latency. Besides the light-weight characteristics, DySample outperforms other upsamplers across five dense prediction tasks, including semantic segmentation, object detection, instance segmentation, panoptic segmentation, and monocular depth estimation.
Introduction
在密集预测模型中,特征上采样是逐步恢复特征分辨率的关键要素。最常用的上采样器是近邻(NN)和双线性插值,它们遵循固定规则对上采样值进行插值。随着动态网络的普及,一些动态上采样器在一些任务中显示出巨大的潜力,像 CARAFE、FADE 和 SAPA 建议将高分辨率引导特征和低分辨率输入特征结合起来生成动态内核,这样上采样过程就可以在高分辨率结构的引导下进行。这些动态上采样器通常结构复杂,需要定制的 CUDA 实现,推理时间比双线性插值要长得多。
现代架构中经常使用多尺度特征,因此可能不需要将高分辨率特征作为上采样器的输入。例如,在 FPN 中,高分辨率特征会在上采样后添加到低分辨率特征中。因此,我们认为设计良好的单输入动态上采样器就足够了。考虑到动态卷积带来的繁重工作量,我们绕过了基于内核的模式,回到了上采样的本质,即点采样,重新制定了上采样过程。
总之,我们认为 DySample 可以在现有的密集预测模型中取代 NN/双线性插值,不仅有效,而且高效。
Method
Grid Sampling
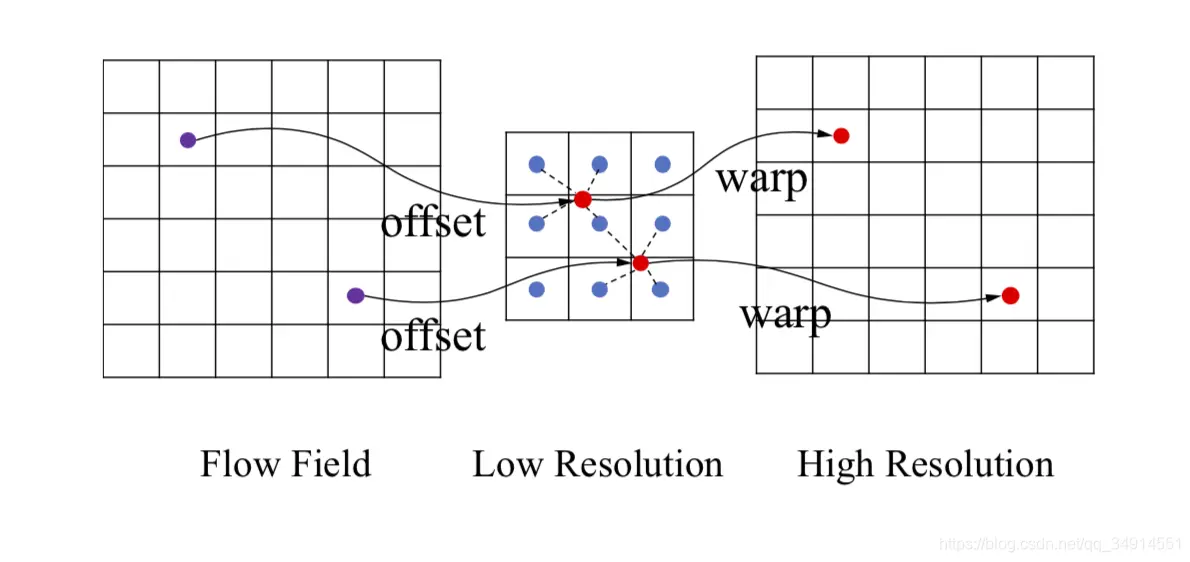
torch.nn.functional.grid_sample(input, grid, mode='bilinear', padding_mode='zeros', align_corners=None)给定
input和 Flow Fieldgrid,使用mode计算input和grid中的像素位置得到output。
对于input和grid来得到output,其中grid为采样点的坐标,其被归一到。
注意:这个grid只是代表着输出图的大小,而其中的采样点,则是坐标归一化后对应着输入中的位置。即,采样后的输出形状是根据grid的大小来定,而grid中具体的值是由采样点根据对应在输入中的坐标位置上的值,根据mode来得出。
采样和插值的区别:
插值:
- 用于对张量进行插值,改变其大小(如放大或缩小)。
- 常用于图像缩放、分辨率调整等操作。
- 不需要额外的采样网格,只需提供目标大小或缩放比例。
采样:
- 用于基于采样网格对输入张量进行采样。
- 常用于图像变形(如旋转、仿射变换、透视变换)或对图像的任意采样操作。
- 需要明确提供采样网格。
| 功能 | interpolate | grid_sample |
|---|---|---|
| 作用 | 简单插值缩放 | 基于采样网格的灵活变形 |
| 输入要求 | 输入张量和目标大小 | 输入张量和采样网格 |
| 常见应用 | 图像上采样或下采样 | 图像变形(旋转、仿射变换) |
| 插值模式 | 支持多种插值模式 | 默认双线性插值 |
邻近差值
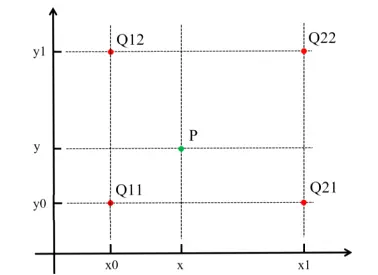
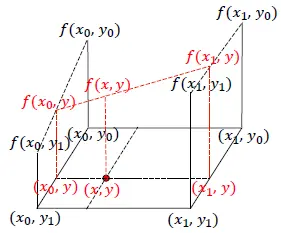
双线性插值
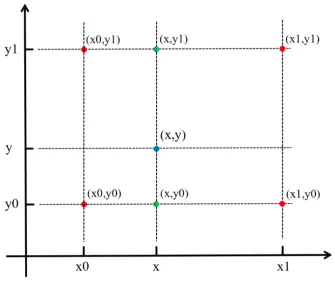
简单实现
通过将和缩放比例通过一个线性层得到偏移量,即,而grid则表示为,然后就可以使用torch.nn.functional.grid_sample这个函数了。
注意:这个在torch.nn.functional.grid_sample是输入,而他则是通过邻近差值自己生成。
通过动态采样进行上采样
初始位置
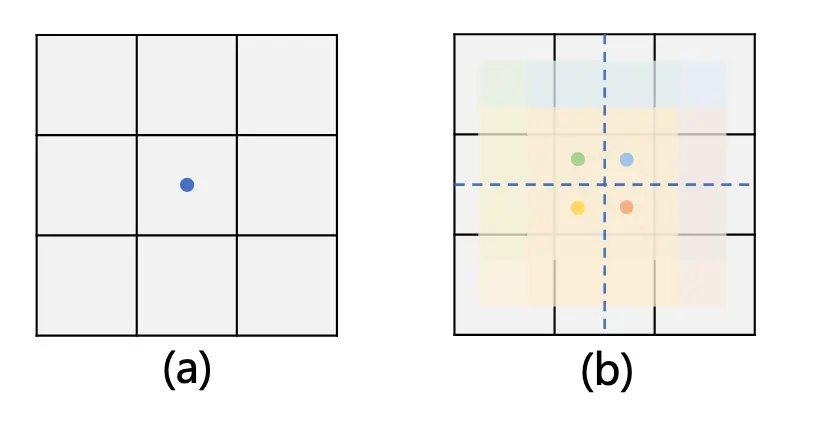
可以注意到,个上采样点的偏移位置忽略了位置关系,会导致不正确的点采样。初步版本中,对于中的一个点的个采样位置都固定在同一个初始位置,这种做法忽略了个相邻点之间的位置关系,导致初始采样位置分布不均。如果生成的偏移量部为零,则表示根本没有改变位置。在这种情况下,上采样看起来就像近邻插值。因此将初始位置改为bilinear。
偏移范围
由于坐标往往会归一化到,这就可能导致了采样位置的重叠,如下图:
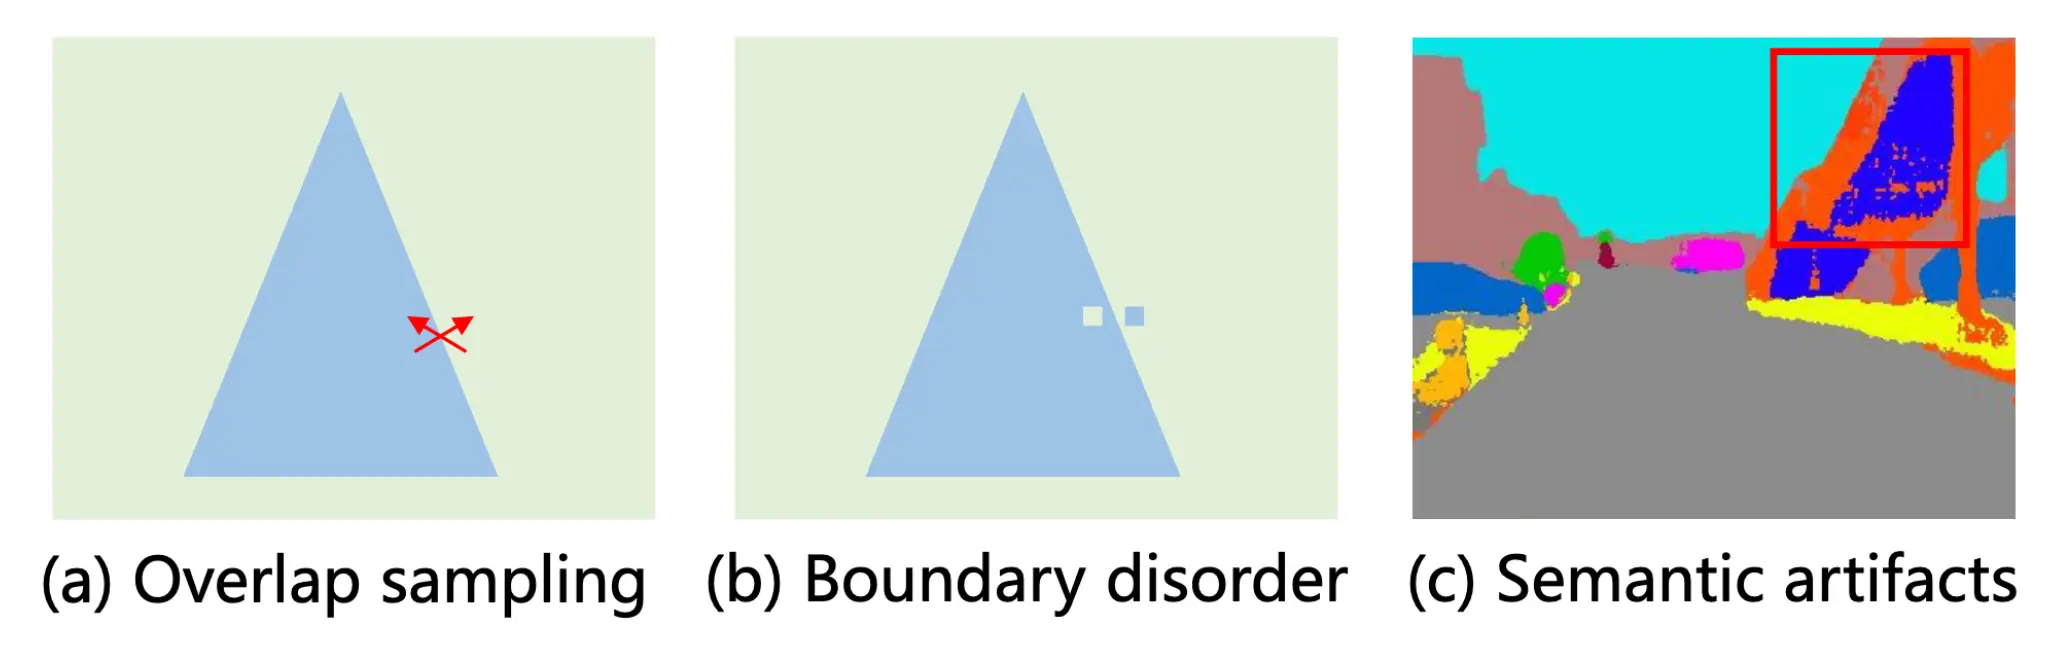
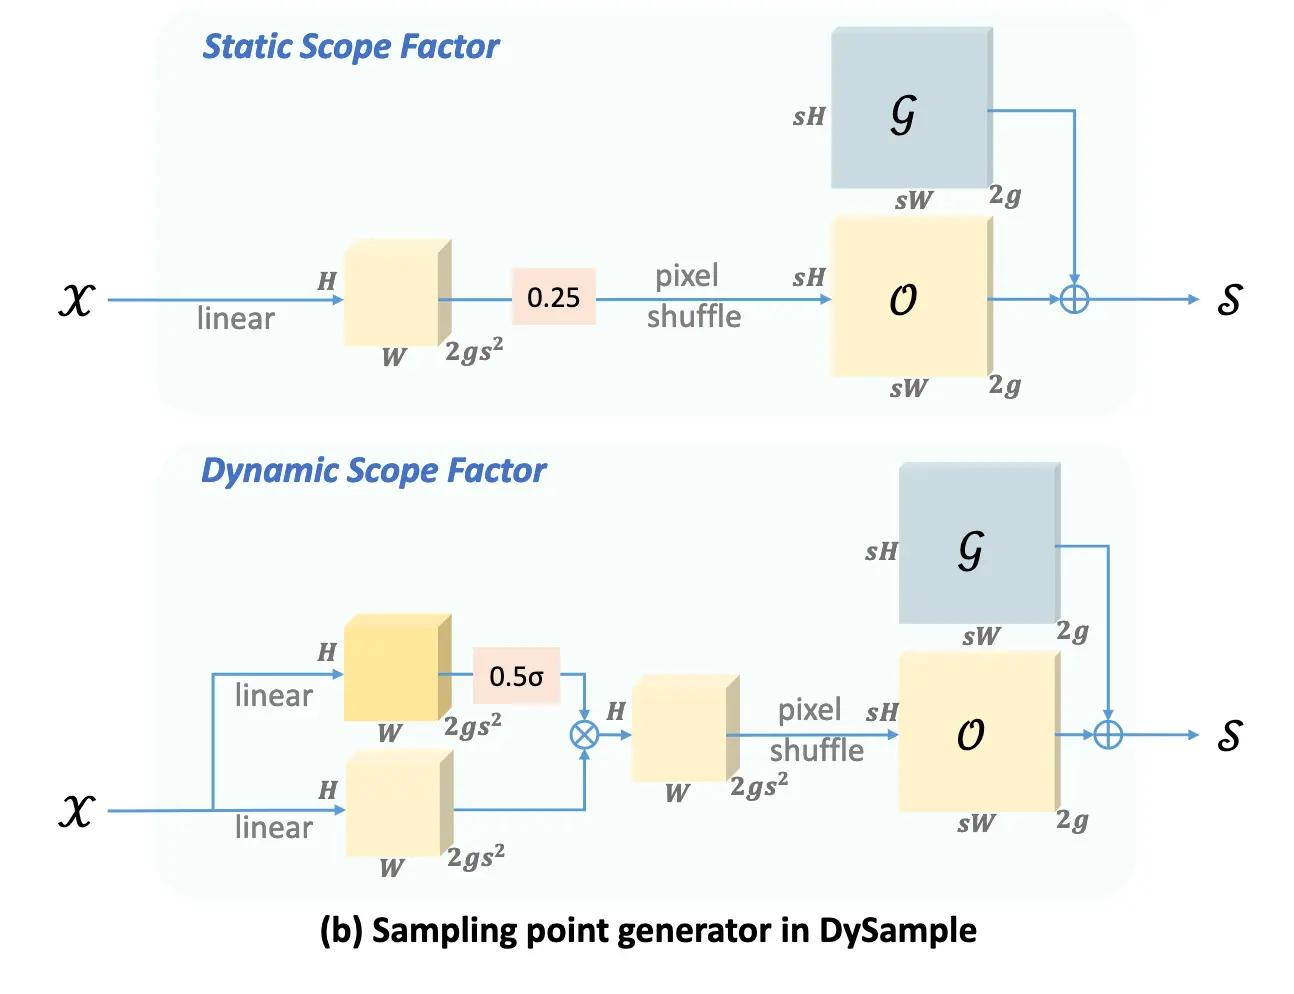
为了缓解这一问题,我们将偏移量乘以一个 0.25 的系数,这个系数刚好满足重叠与非重叠之间的理论边际条件。这个系数被称为 “静态范围系数”,这样采样位置的行走范围就会受到局部限制。
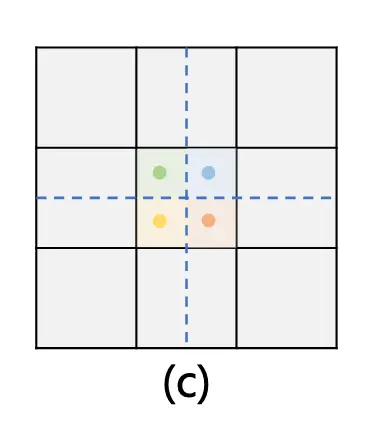
注意:乘以系数只是问题的一种软解决方案,并不能完全解决问题。
分组
在这里,我们研究的是分组向上采样,即每个分组中的特征共享相同的采样集。具体来说,我们可以沿通道维度将特征图划分为 g 组,并生成 g 组偏移量。
动态范围系数
为了增加偏移量的灵活性,我们通过对输入特征进行线性投影,进一步生成点状 “动态范围系数”。通过使用 sigmoid 函数和 0.5 的静态因子,动态范围取值范围为,以 0.25 为中心。
偏移生成风格
在上述设计中,首先使用线性投影产生。然后对进行 reshpe,以满足空间大小的要求。我们称这一过程为 “Linear + Pixel shuffle”(LP)。为了节省参数和 FLOPs,我们可以提前执行 reshape 操作,然后将其线性投影到上,这就叫做 Pixel shuffle + Linear(PL)。在其他超参数固定的情况下,PL 设置下的参数数量可减少到。此外,我们还发现,在语义分割上,PL 版本比 LP 版本效果更好,但在其他测试模型上效果稍差。
DySample 系列
- DySample: LP-style with the static scope factor;
- DySample+: LP-style with the dynamic scope factor;
- DySample-S: PL-style with the static scope factor;
- DySample-S+: PL-style with dynamic scope factor.
DySample 如何起效的?
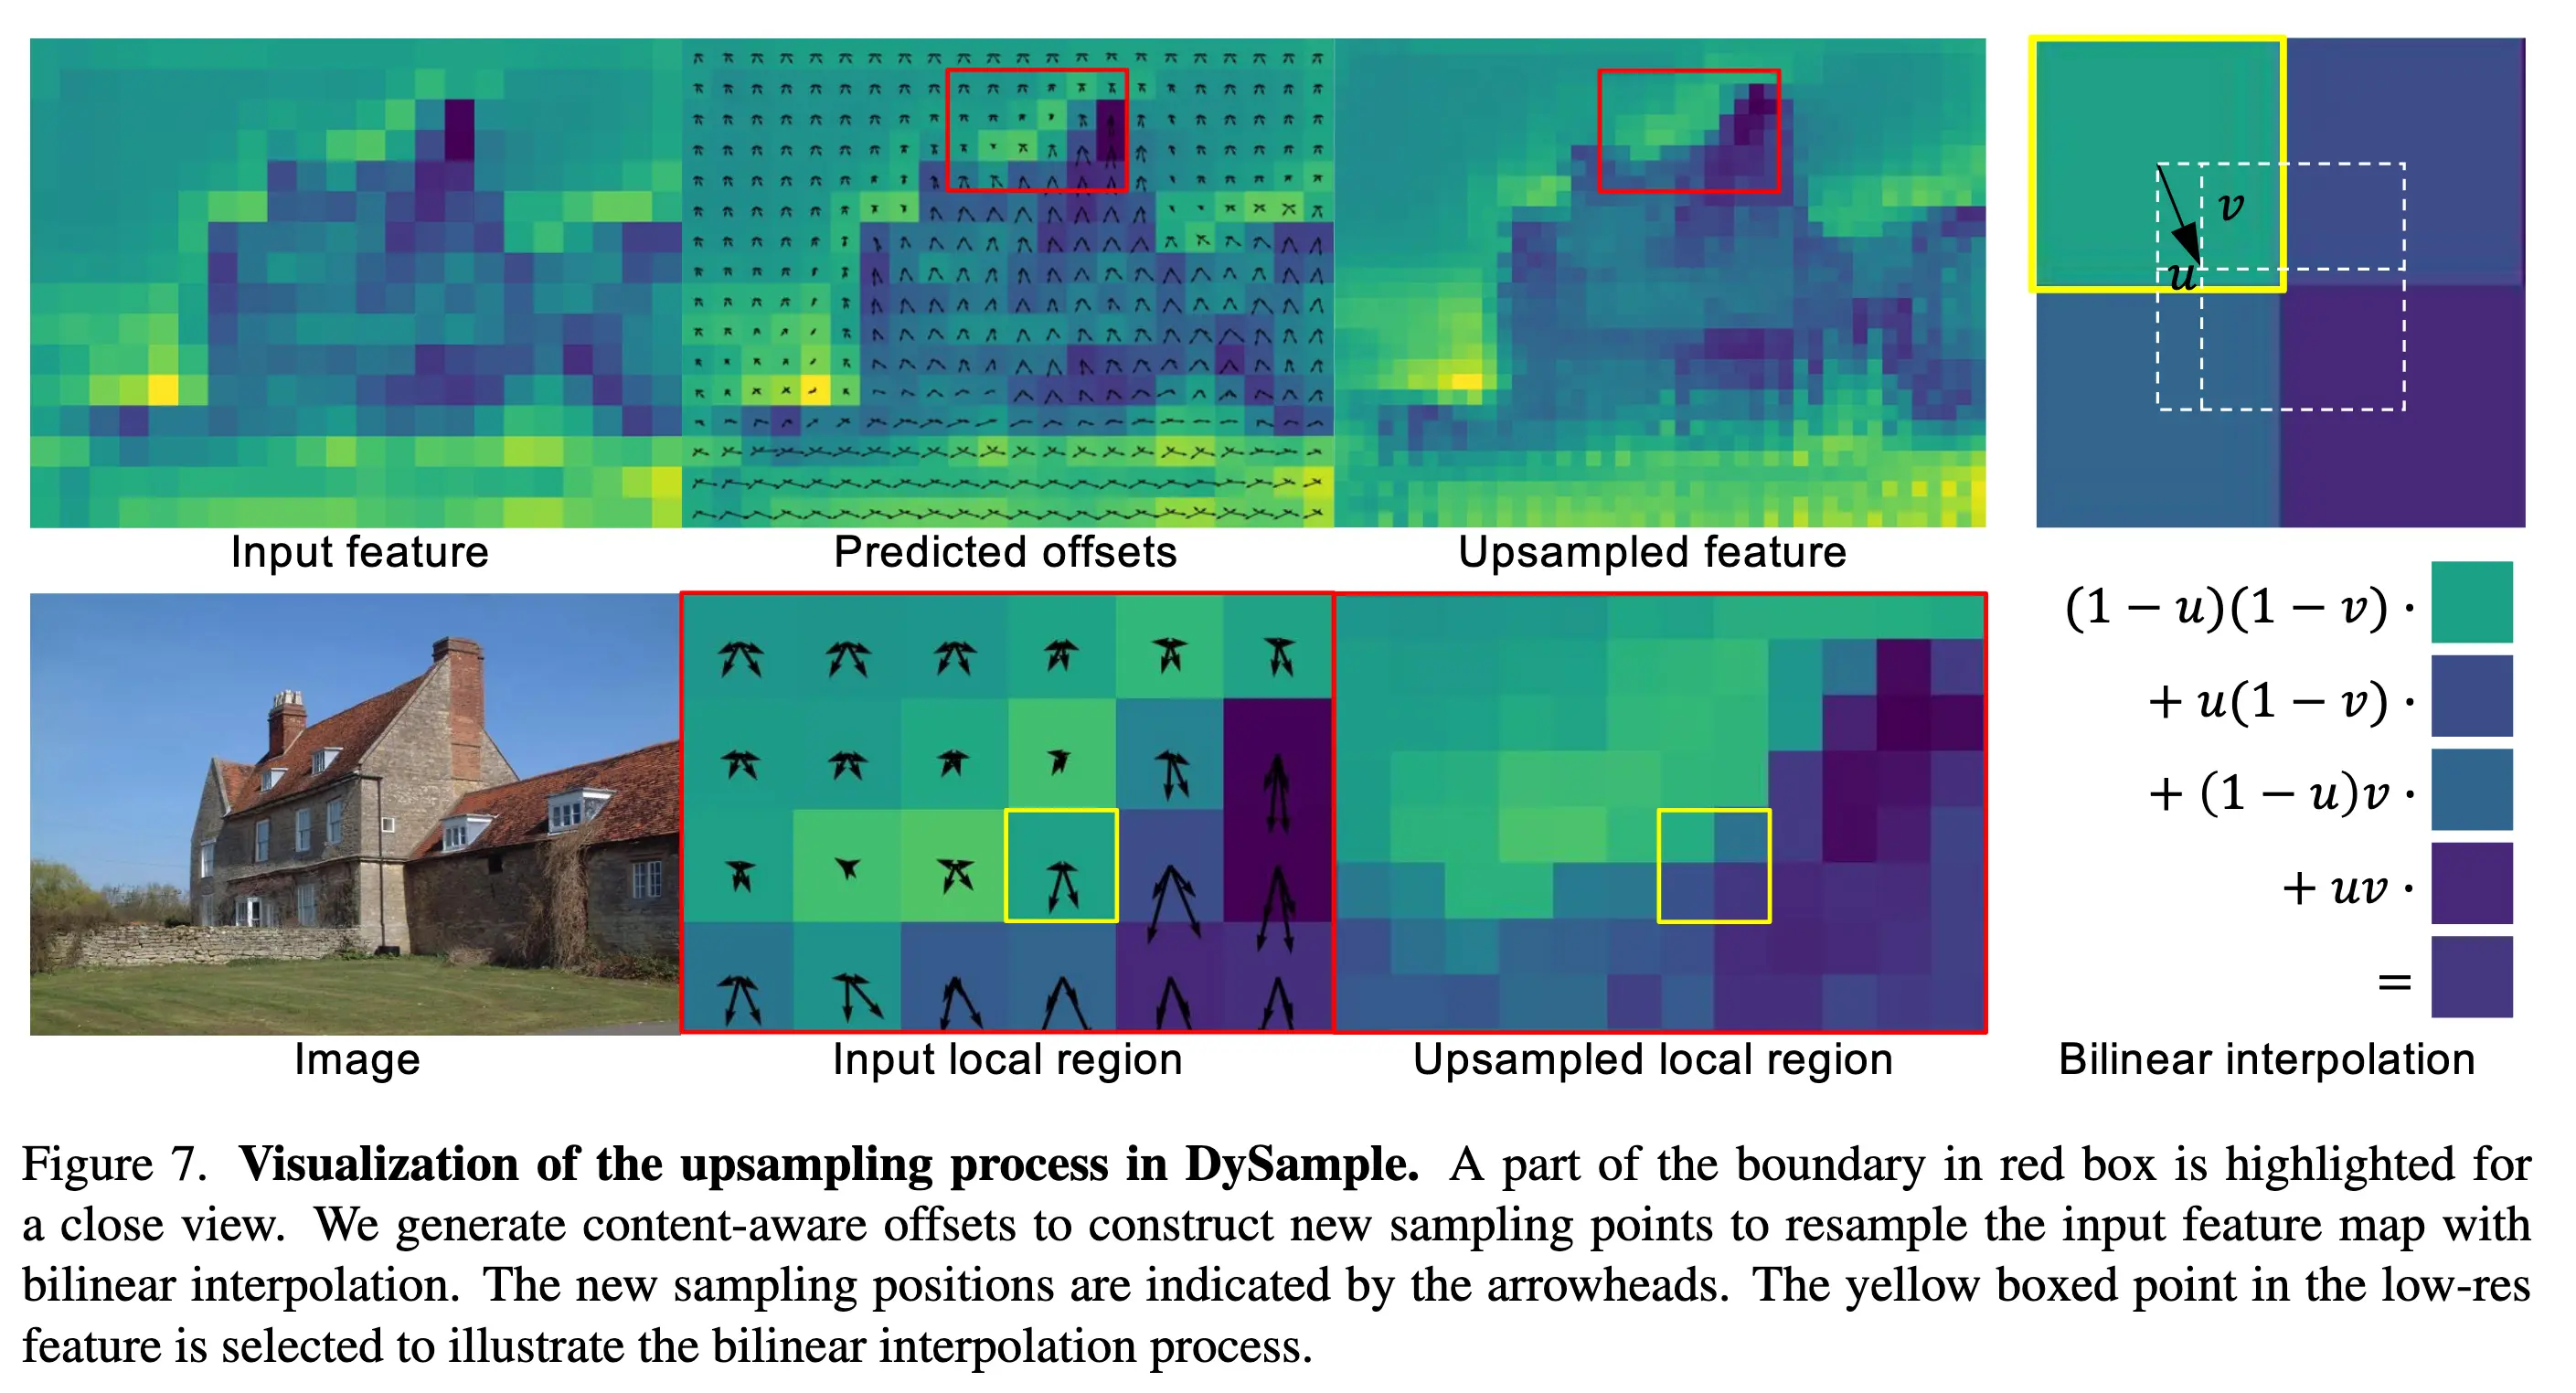
下图展示了 DySample 的采样过程。我们突出显示了一个(红色方框)局部区域,以展示 DySample 如何将边缘上的一个点分成四个,使边缘更加清晰。对于黄色方框内的点,DySample 会生成四个偏移量,分别指向双线性插值意义上的四个上采样点。在本例中,左上角的点被划分为 “天空”(浅色),而其他三个点被划分为 “房屋”(深色)。最右侧的子图显示了右下角上采样点的形成过程。
实验
复杂度分析
定量分析
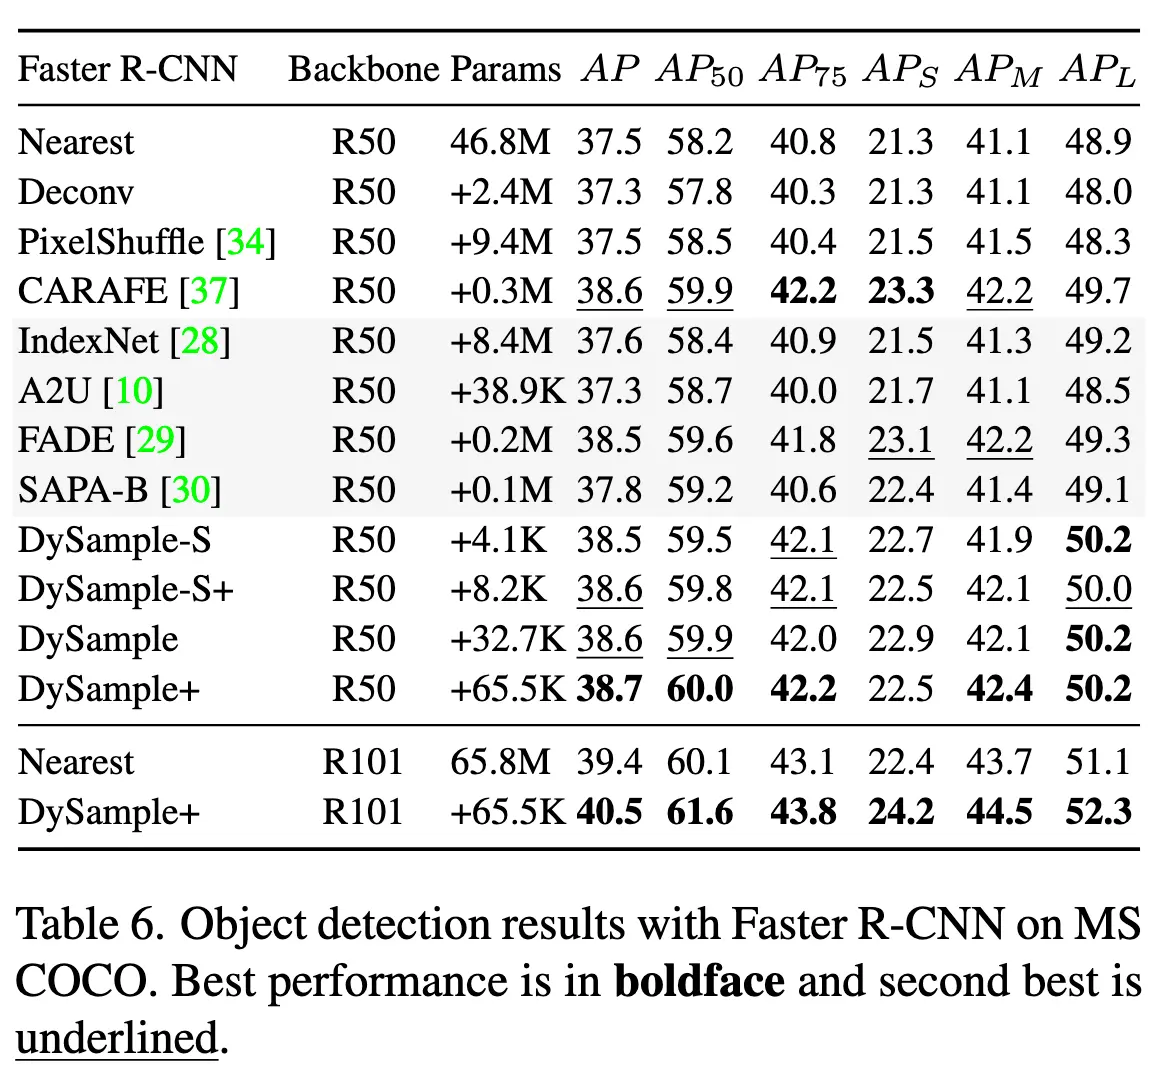
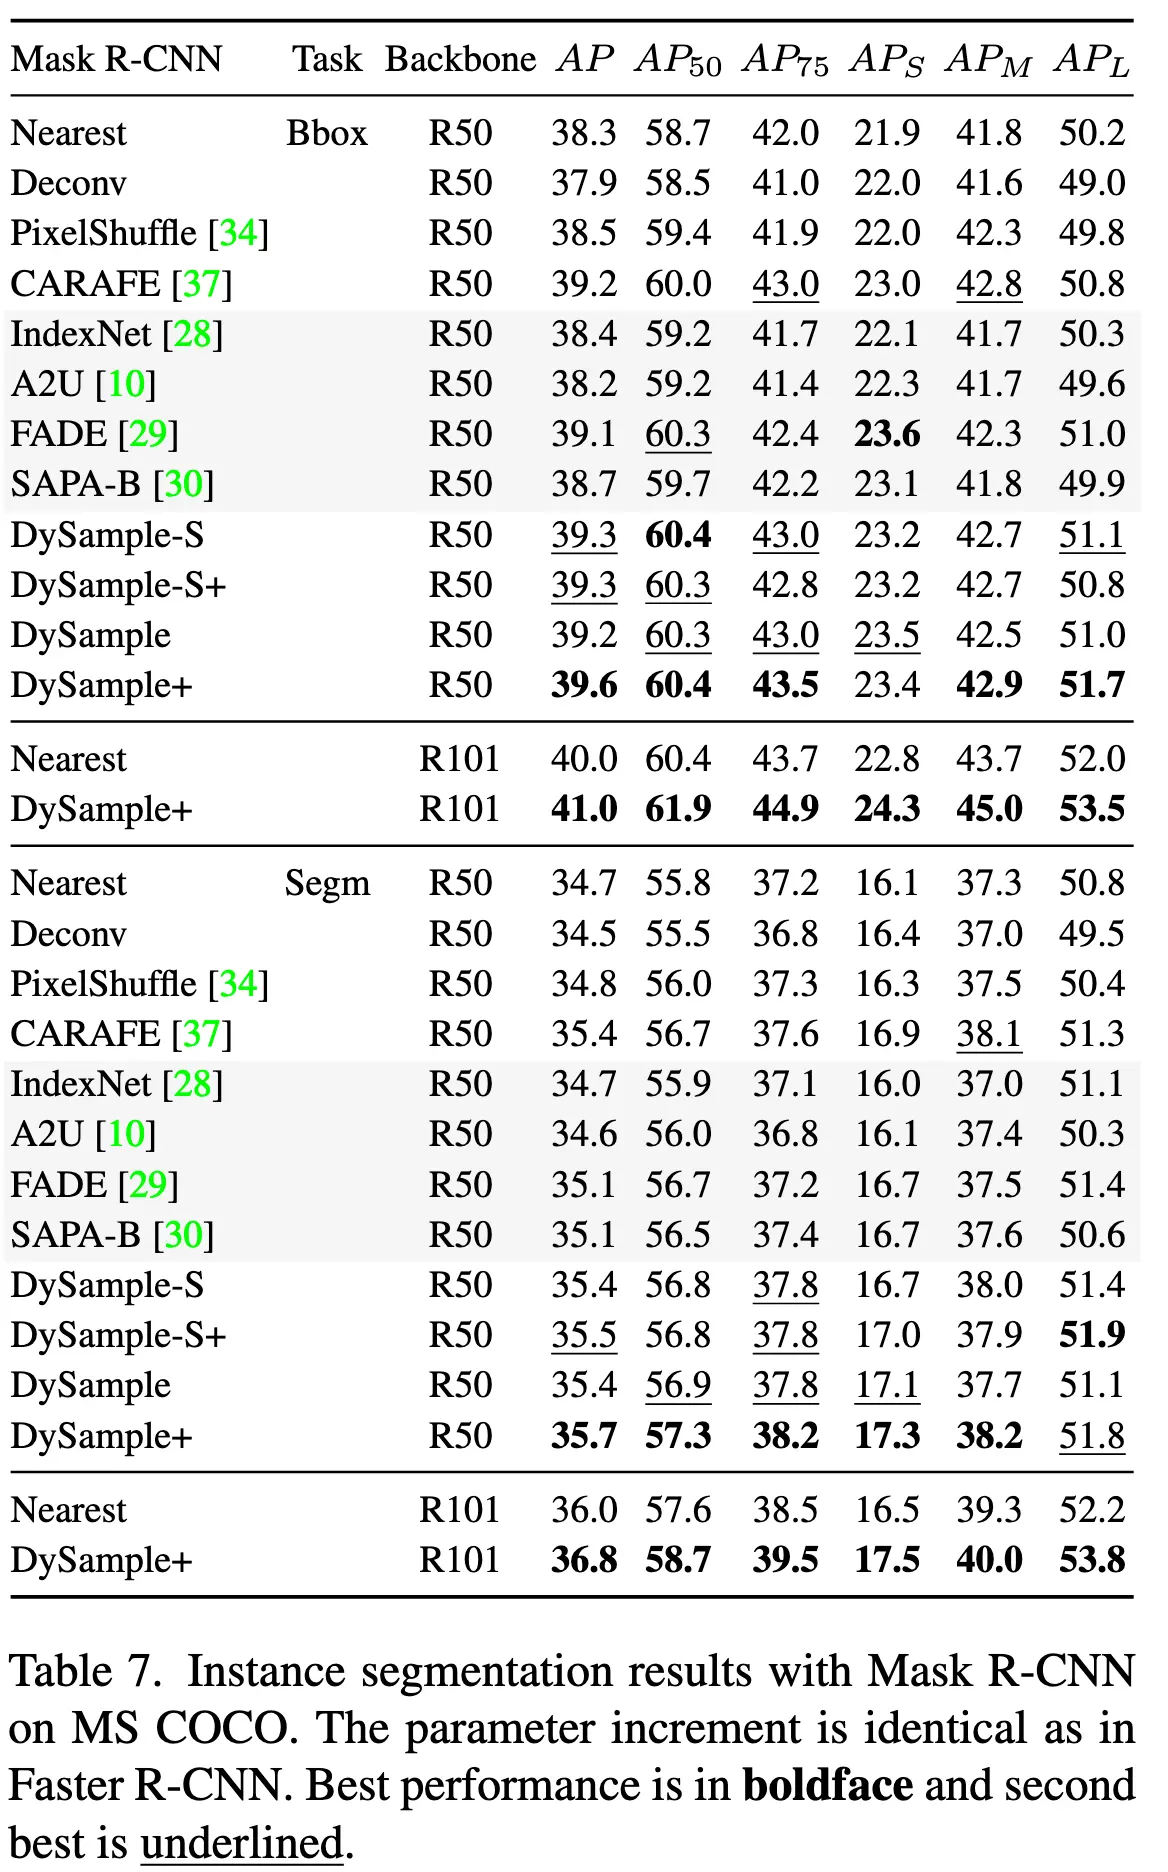
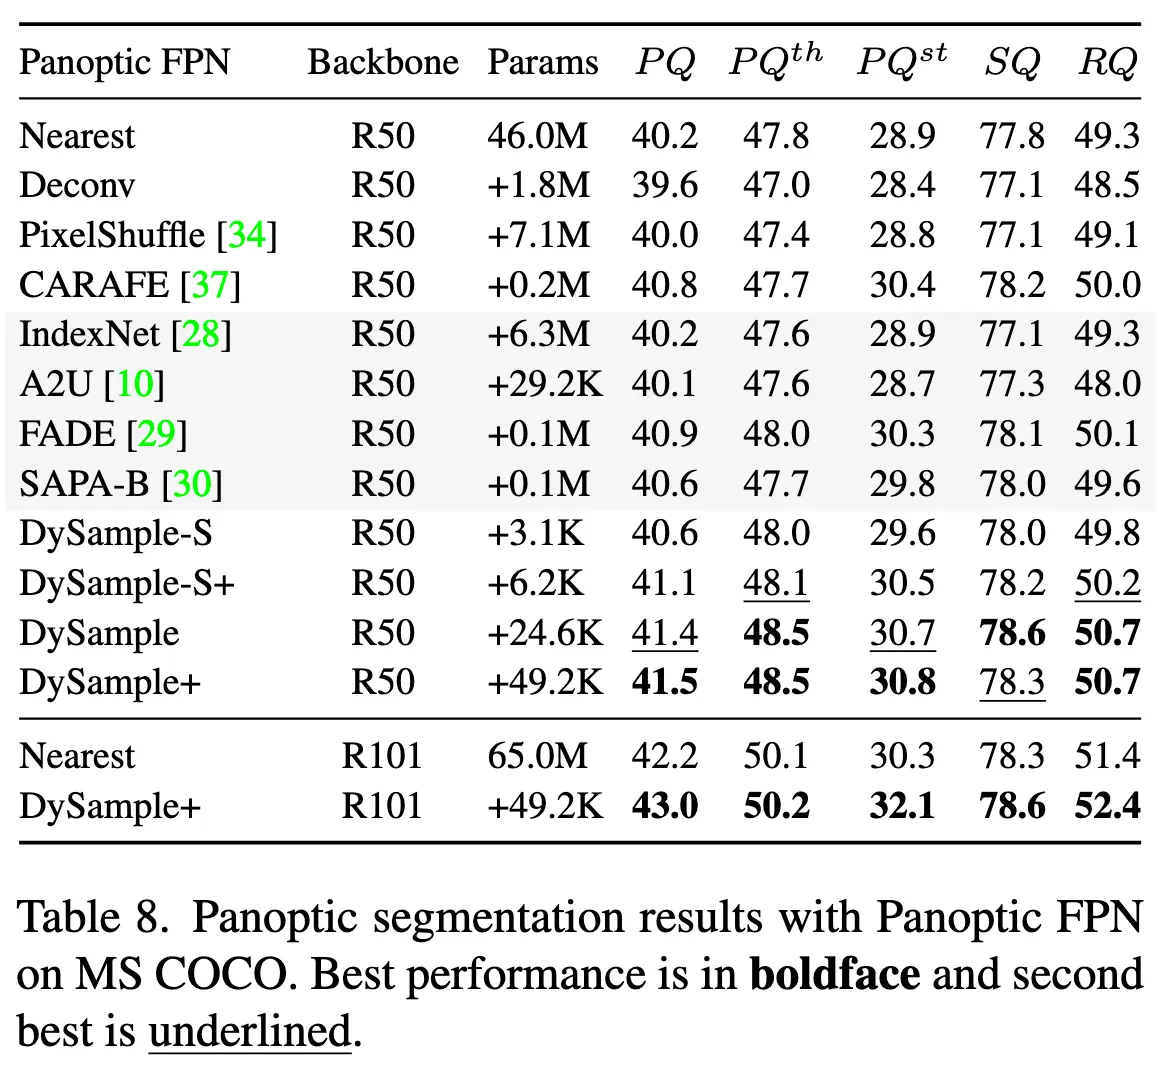
定性分析