Enabling Deep Residual Networks for Weakly Supervised Object Detection
Abstract
Weakly supervised object detection (WSOD) has attracted extensive research attention due to its great flexibility of exploiting largescale image-level annotation for detector training. Whilst deep residual networks such as ResNet and DenseNet have become the standard backbones for many computer vision tasks, the cutting-edge WSOD methods still rely on plain networks, e.g., VGG, as backbones. It is indeed not trivial to employ deep residual networks for WSOD, which even shows significant deterioration of detection accuracy and non-convergence. In this paper, we discover the intrinsic root with sophisticated analysis and propose a sequence of design principles to take full advantages of deep residual learning for WSOD from the perspectives of adding redundancy, improving robustness and aligning features. First, a redundant adaptation neck is key for effective object instance localization and discriminative feature learning. Second, small-kernel convolutions and MaxPool down-samplings help improve the robustness of information flow, which gives finer object boundaries and make the detector more sensitivity to small objects. Third, dilated convolution is essential to align the proposal features and exploit diverse local information by extracting highresolution feature maps. Extensive experiments show that the proposed principles enable deep residual networks to establishes new state-of-thearts on PASCAL VOC and MS COCO.
Introduction
弱监督目标检测(Weakly supervised object detection - WSOD) 相比全监督目标检测(Fully Supervised Object Detection - FSOD)所需的标注可以接受许多标注成本和带来更高的应用灵活性。
很少有人在 WSOD 解决 Backbone 的问题,大部份还在用 VGG 和 AlexNet,但是直接替换残差网络影响性能。其根本问题是 WSOD 头对模型初始化敏感并且不稳定,这可能会将不确定和错误的梯度反向传播到主干网,并恶化视觉表示学习。
提出三个方法解决这个问题:
- Redundant adaptation neck
- Robust information flow
- Proposal feature alignment
基于上三个原则,提出:
- ResNet-WS
- DenseNet-WS
Related Work
Weakly Supervised Object Detection
前沿的 WSOD 工作通常集中于两个阶段:
- 对象发现(Object Discovery,Object Mining)
- 实例细化(Instance Refinement)
对象发现(Object Discovery,Object Mining)
物体发现阶段结合了多实例学习(MIL)和 CNN,利用图像级标签对潜在物体位置进行隐式建模。WSDDN 通过并行检测和分类分支选择了一些 Proposal。还有利用上下文信息、注意力机制、显著性图和语义分割来学习优秀的 Proposal。还有做 WSOD 的高精度对象 Proposal 的。一些方法侧重于使用深度特征图、类激活图和生成对抗学习等无 Proposals 范式。有些研究还利用额外的信息来提高性能,例如物体大小估计、实例数量注释、视频运动线索和人工验证。在数据和任务方面,知识转移也被用于跨领域适应。
实例细化(Instance Refinement)
实例细化阶段旨在利用对象发现阶段的预测,明确学习对象的位置。从物体发现阶段生成的得分最高的 Proposal 被用作训练实例细化分类器的监督。此外,还提出了其他不同的策略来生成伪GT框和标签 Proposal。一些方法利用最小熵先验、多视图学习和延续 MIL 来联合学习两阶段模块,以改进整体框架的优化。此外,还提出了分割与检测之间的协作机制,以利用弱监督任务的互补解释。
目标检测网络结构
人们在为 FSOD 任务设计网络架构方面付出了巨大努力。DSOD 和 Root-ResNet 用于从头开始训练单例探测器(即 SSD),而 PeleeNet 则用于训练移动设备的 SSD。也有人提出了用于 FSOD 的 DetNet 骨干网。精细特征图对于检测 FPN 中观察到的小物体也很有用。
总之,大多数传统骨干网络通常是为图像分类或 FSOD 而设计的。我们还没有发现有任何一种方法可以探索用于 WSOD 的骨干网络。此外,前沿的 WSOD 方法沿用了 ImageNet 预训练朴素网络(即 VGG 型网络)的管道。毫无疑问,近期深度残差架构中的高级模块尚未在 WSOD 中得到探索。
Baseline WSOD
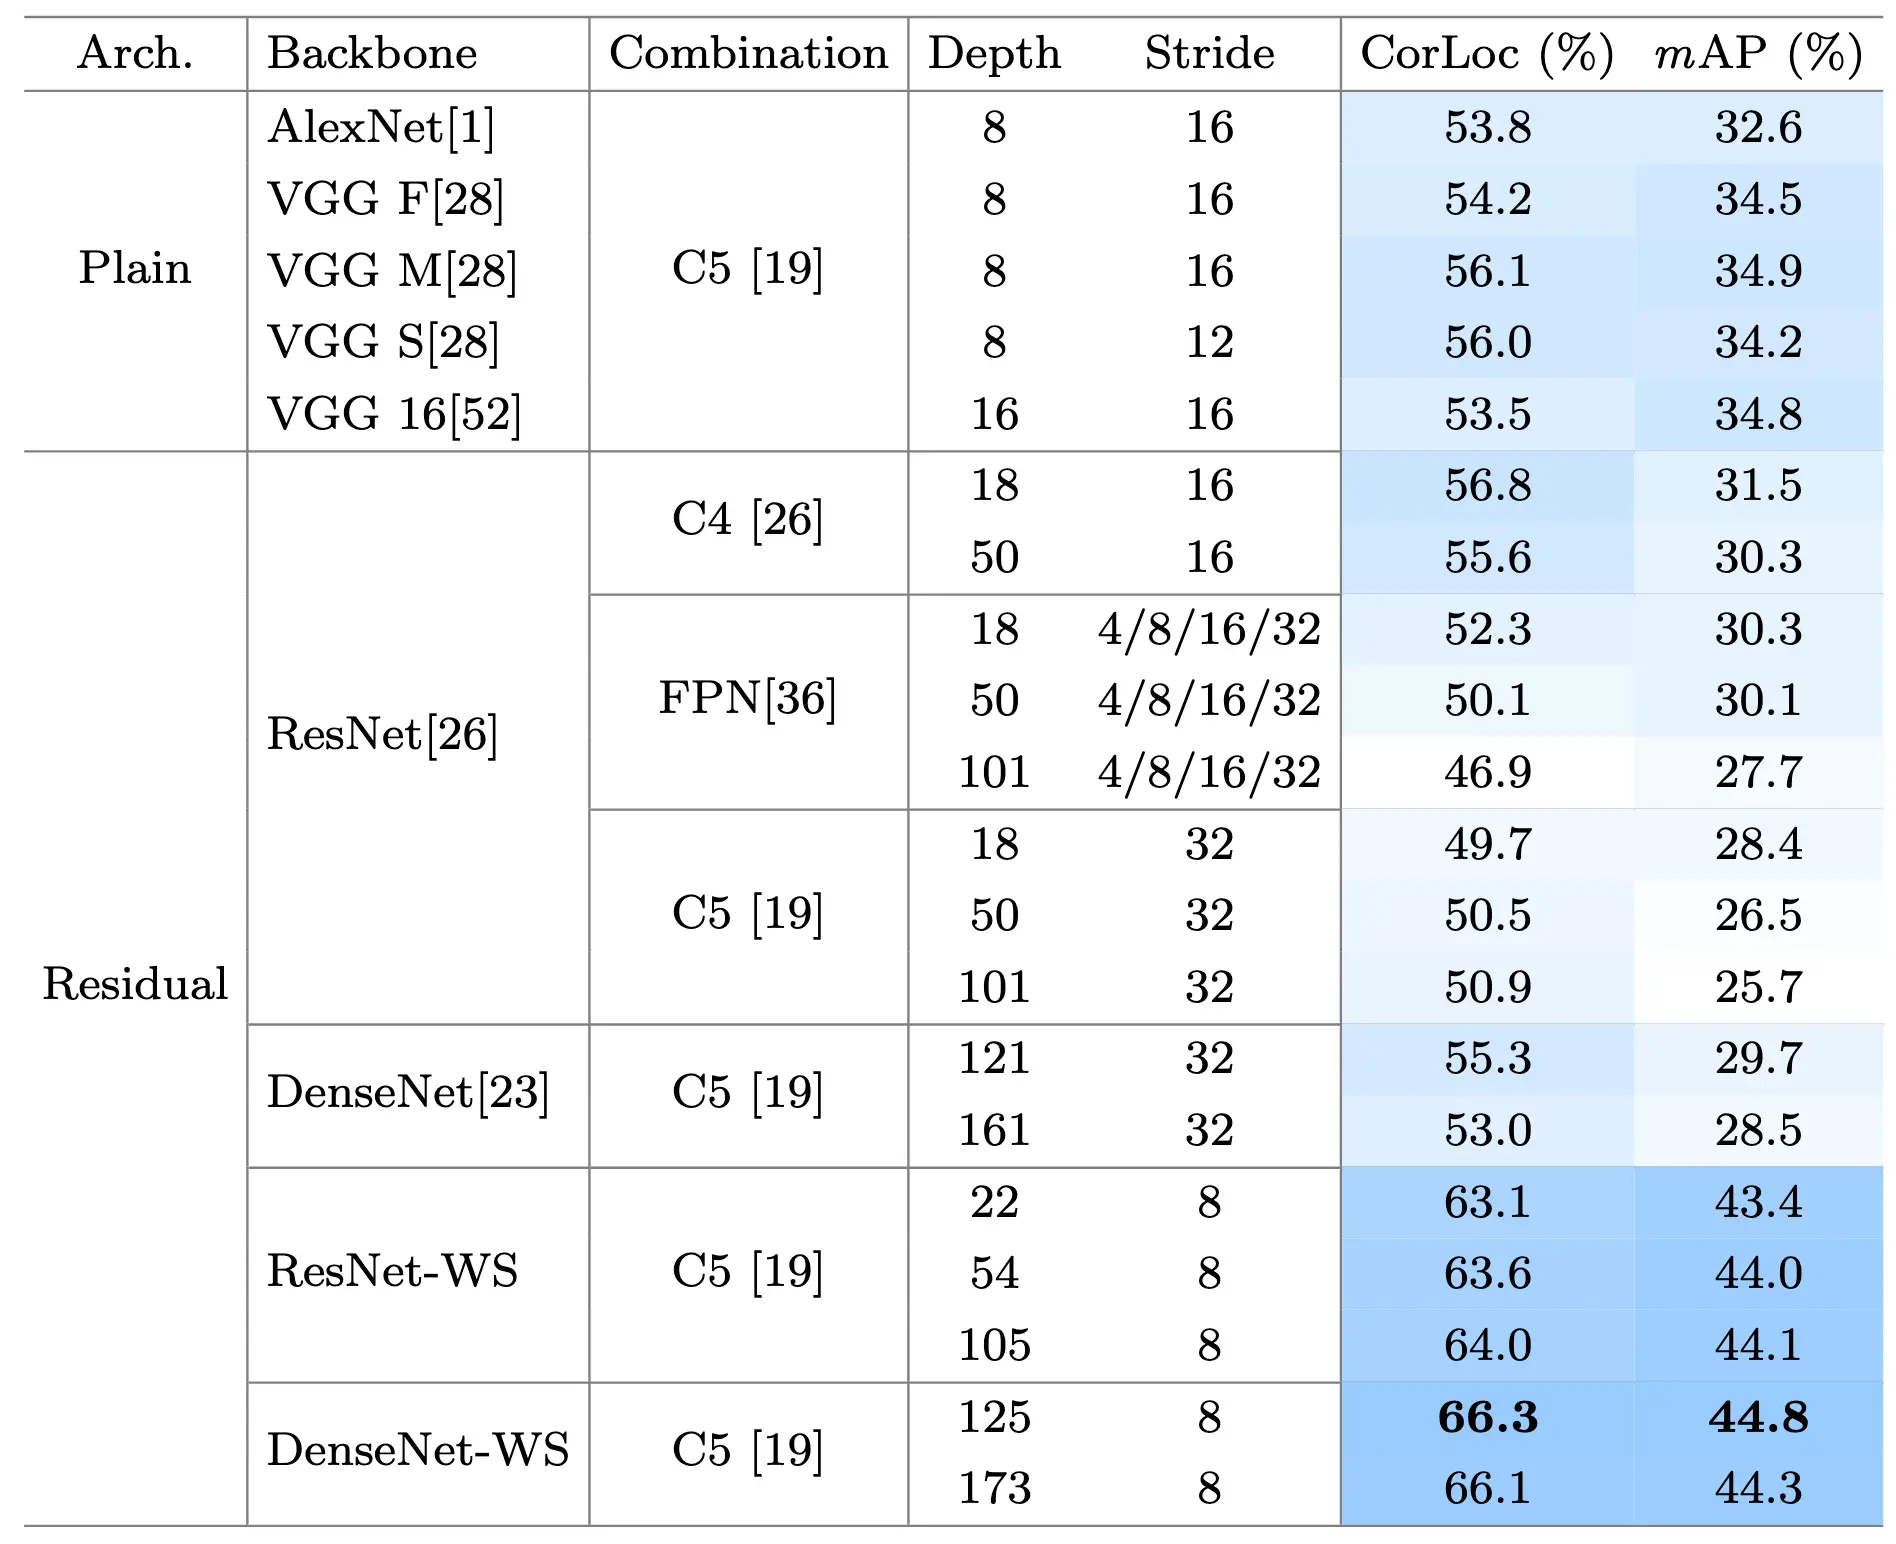
首先研究了 FSOD 中的几种常见组合方案,以在 ResNet 和 DenseNet 上构建 WSOD 头,这些方案广泛用于 Faster RCNN。
在 WSOD 任务中直接使用 ResNet 和 DenseNet 会显著降低各种组合的性能。C4 组合的最佳性能为 31.5 mAP,在 mAP 方面仍然不如浅层 AlexNet 骨干网。此外,一些 SOTA 方法也无法收敛。由于 C4 和 FPN 组合在 WSOD 设置中各有缺点,因此本文接下来将重点讨论 C5 组合。
C4 组合需要为每个 Proposal 计算整个 conv5 阶段。因此,与 C5 组合相比,当每幅图像有大约 2,000 个 Proposal 时,C4 组合将额外花费 10 倍的训练时间和一倍的内存使用率。FPN 组合需要自上而下地学习具有横向联系的全图像特征金字塔,这将带来额外的负担。
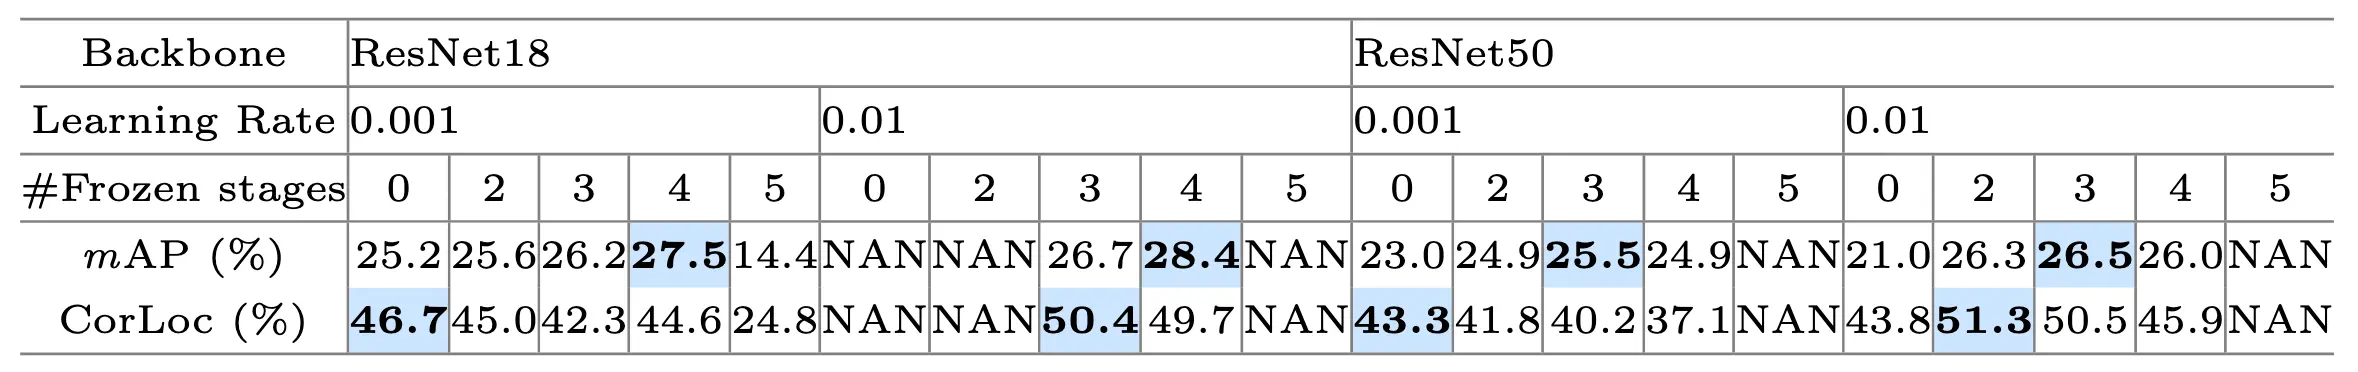
与 FSOD 不同,WSOD 没有足够的监督,通常通过多实例学习(MIL)来表述,这对模型初始化很敏感,并且存在不稳定性。从这个意义上讲,WSOD 的头部可能会将不确定和错误的梯度反向传播到骨干网络,而深度残差网络则会扩大错误信息并恶化视觉表征学习,从而导致检测性能大幅下降。为了进一步验证上述分析,我们在 ResNet 中冻结了不同数量的阶段,总结如下:
- 通过将预训练层冻结到阶段 4,mAP 的检测性能逐步提高,因为这样可以防止骨干网中的卷积层接收到来自 WSOD 头的错误信息。
- 当冻结整个骨干网,即全部 5 个冻结阶段时,模型的表征学习能力不足(mAP 大幅下降),甚至无法收敛。
- 学习率越大,即 0.01,3 个和 4 个冻结阶段模型的性能就越好。然而,如此大的学习率也会扩大错误信息,导致 0 个和 2 个冻结阶段的模型不收敛。
- 与测试集的 mAP 相比,在训练和验证集上评估的定位性能 CorLoc 随着冻结阶段的增加而变差,这主要是由于过度拟合造成的。
Redundant Adaptation Neck
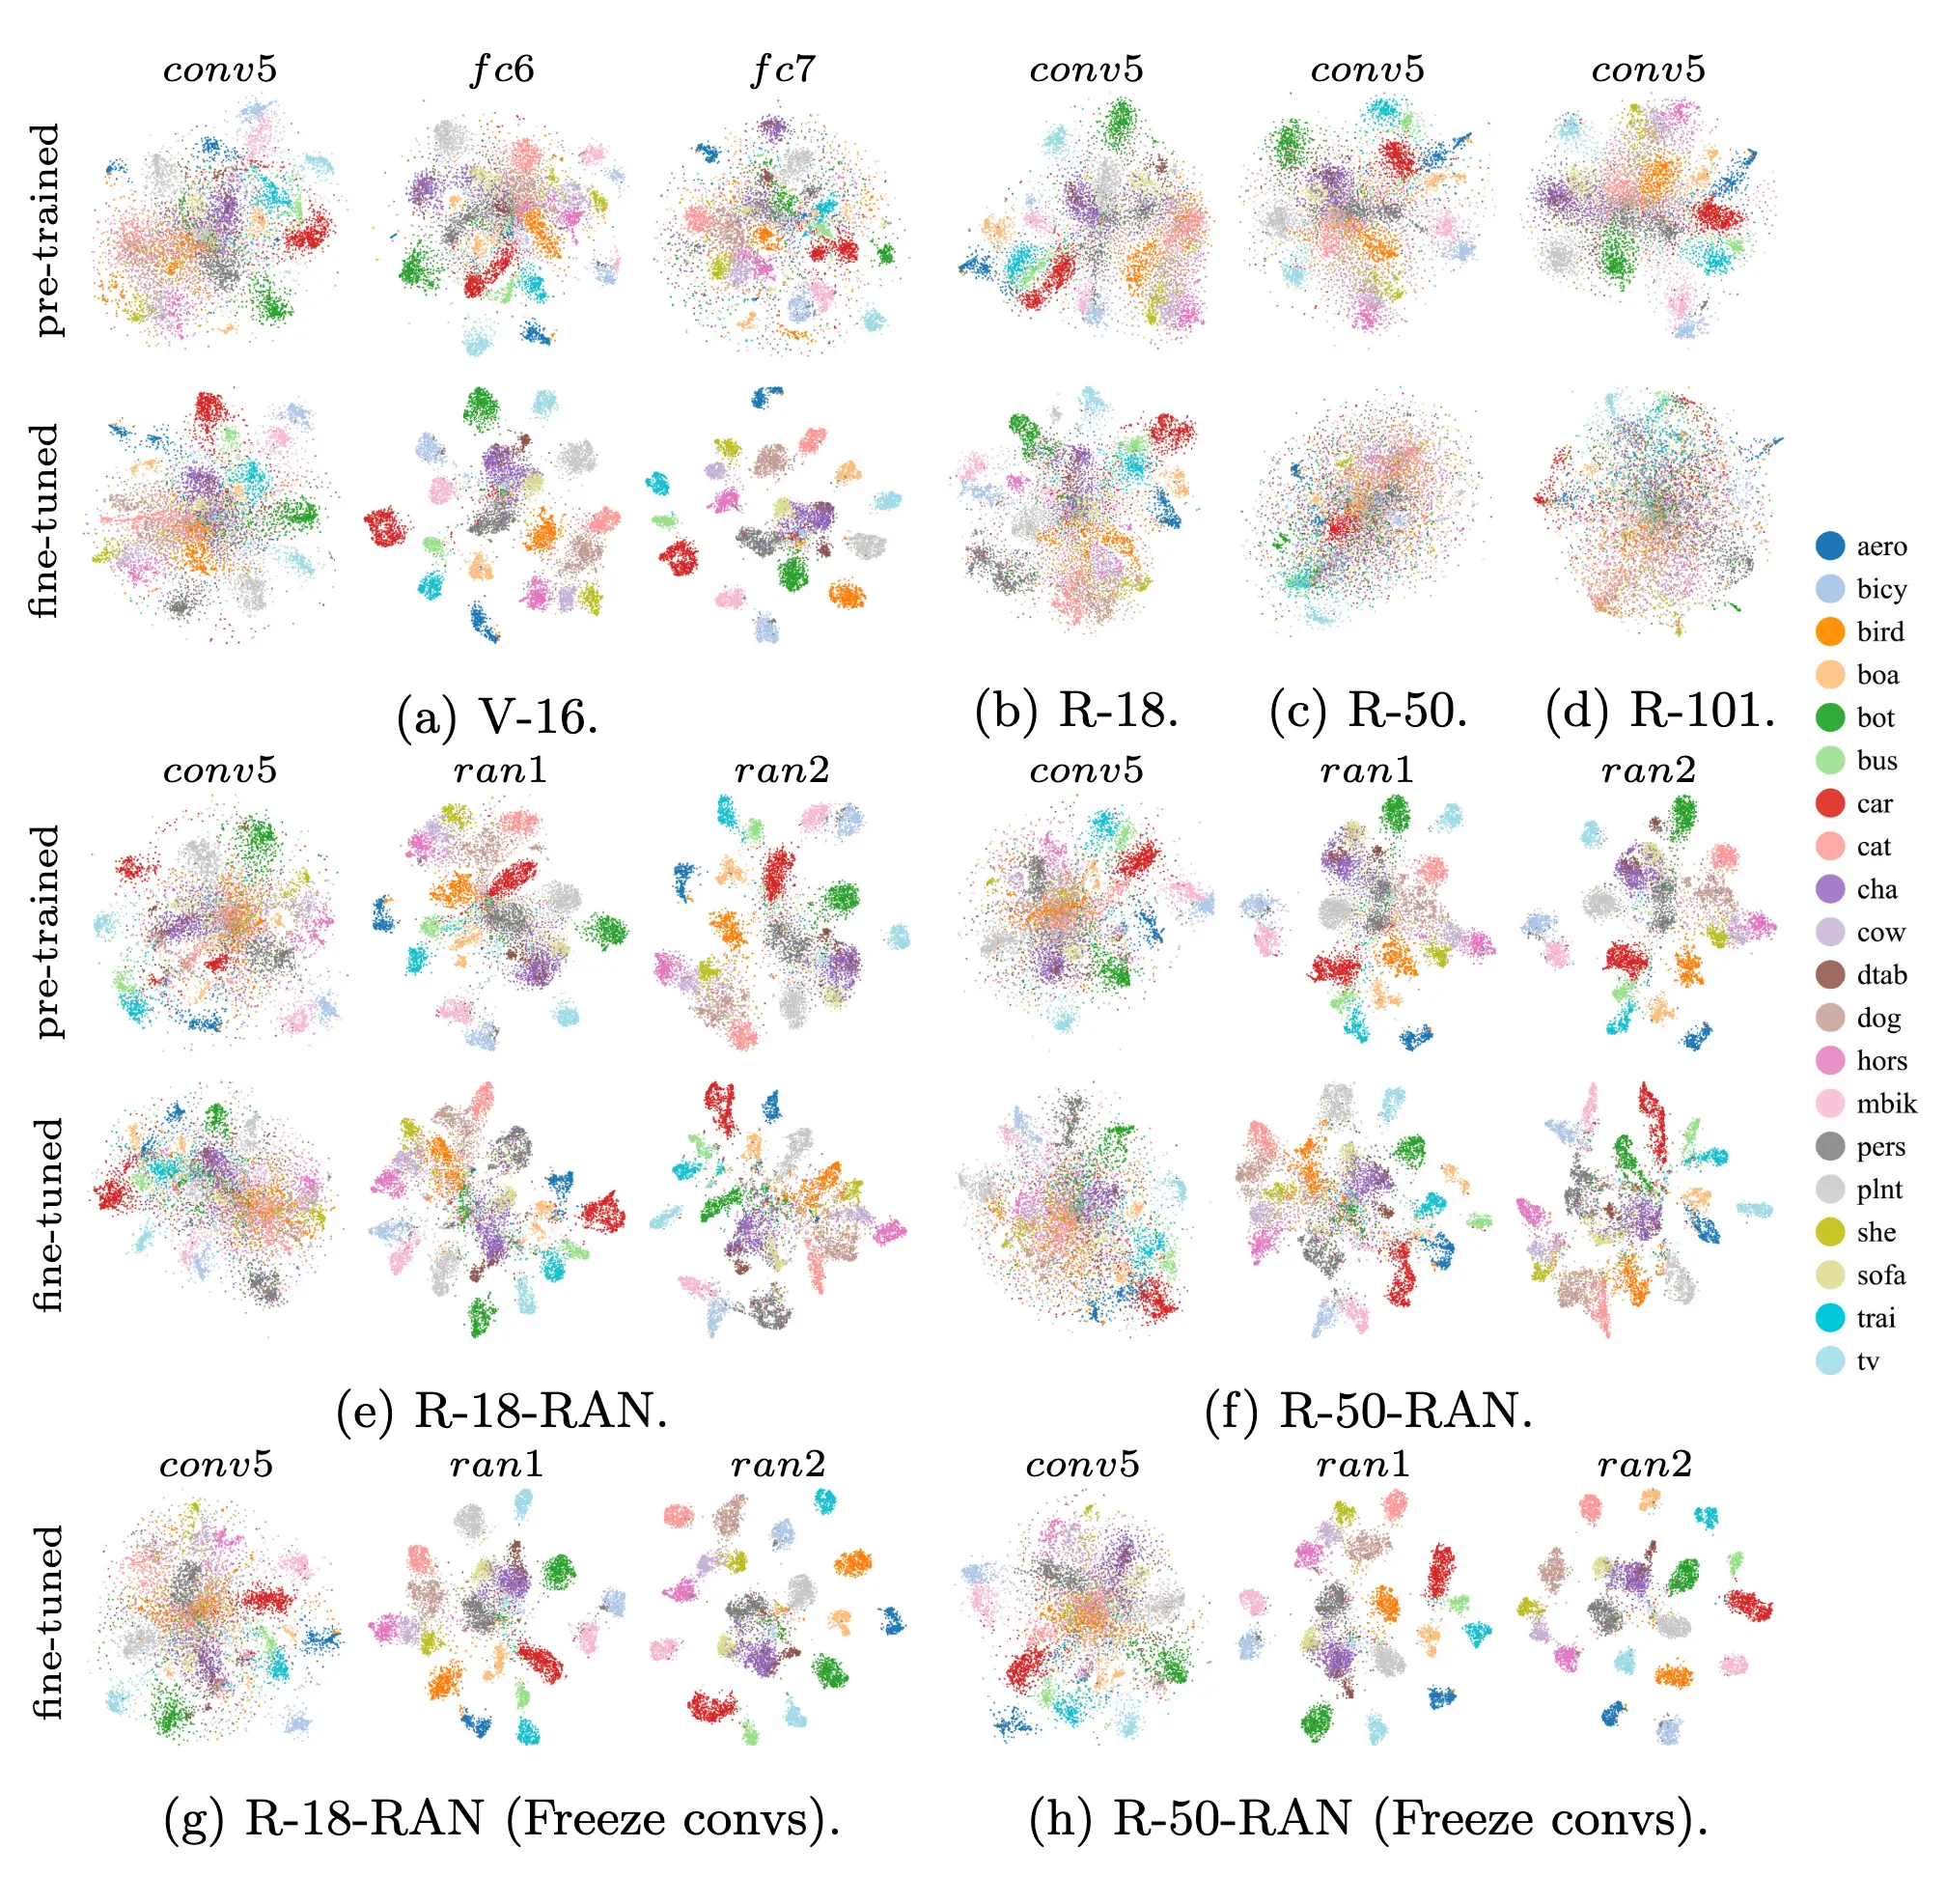
上图显示了使用 t-SNE 从 PASCAL VOC 2007 训练值集中均匀采样的 Proposal 特征的分布情况。我们将 VGG16(V-16)与 18 层(R-18)、50 层(R-50)和 101 层(R-101)的 ResNet 进行了比较。图中显示了来自 RoIPool 和后续层的 Proposal 特征,即 VGG16 的 conv5、fc6 和 fc7 以及 ResNet 的 conv5。 在图 a 中,我们观察到微调后的 VGG16 的 FC 层的 Proposal 特征比预训练的特征更具区分度,而 conv5 的特征分布仅有轻微变化。然而,图 b、c 和 d 表明,ResNet 的 Proposal 特征在区分不同类别方面的区分度不够。 更有甚者,ResNet50 和 ResNet101 的 Proposal 特征与预训练的对应特征相比,效果更差。为了进一步探讨训练过程,我们还在下图中绘制了不同骨干网的优化景观分析曲线。一般来说,优化损失表明了模型对 Proposal 关系的推理程度,以满足 WSOD 中施加的约束条件。 与收敛到不理想局部最小值的 ResNet 骨干网相比,VGG16 的收敛速度更快,损失更低。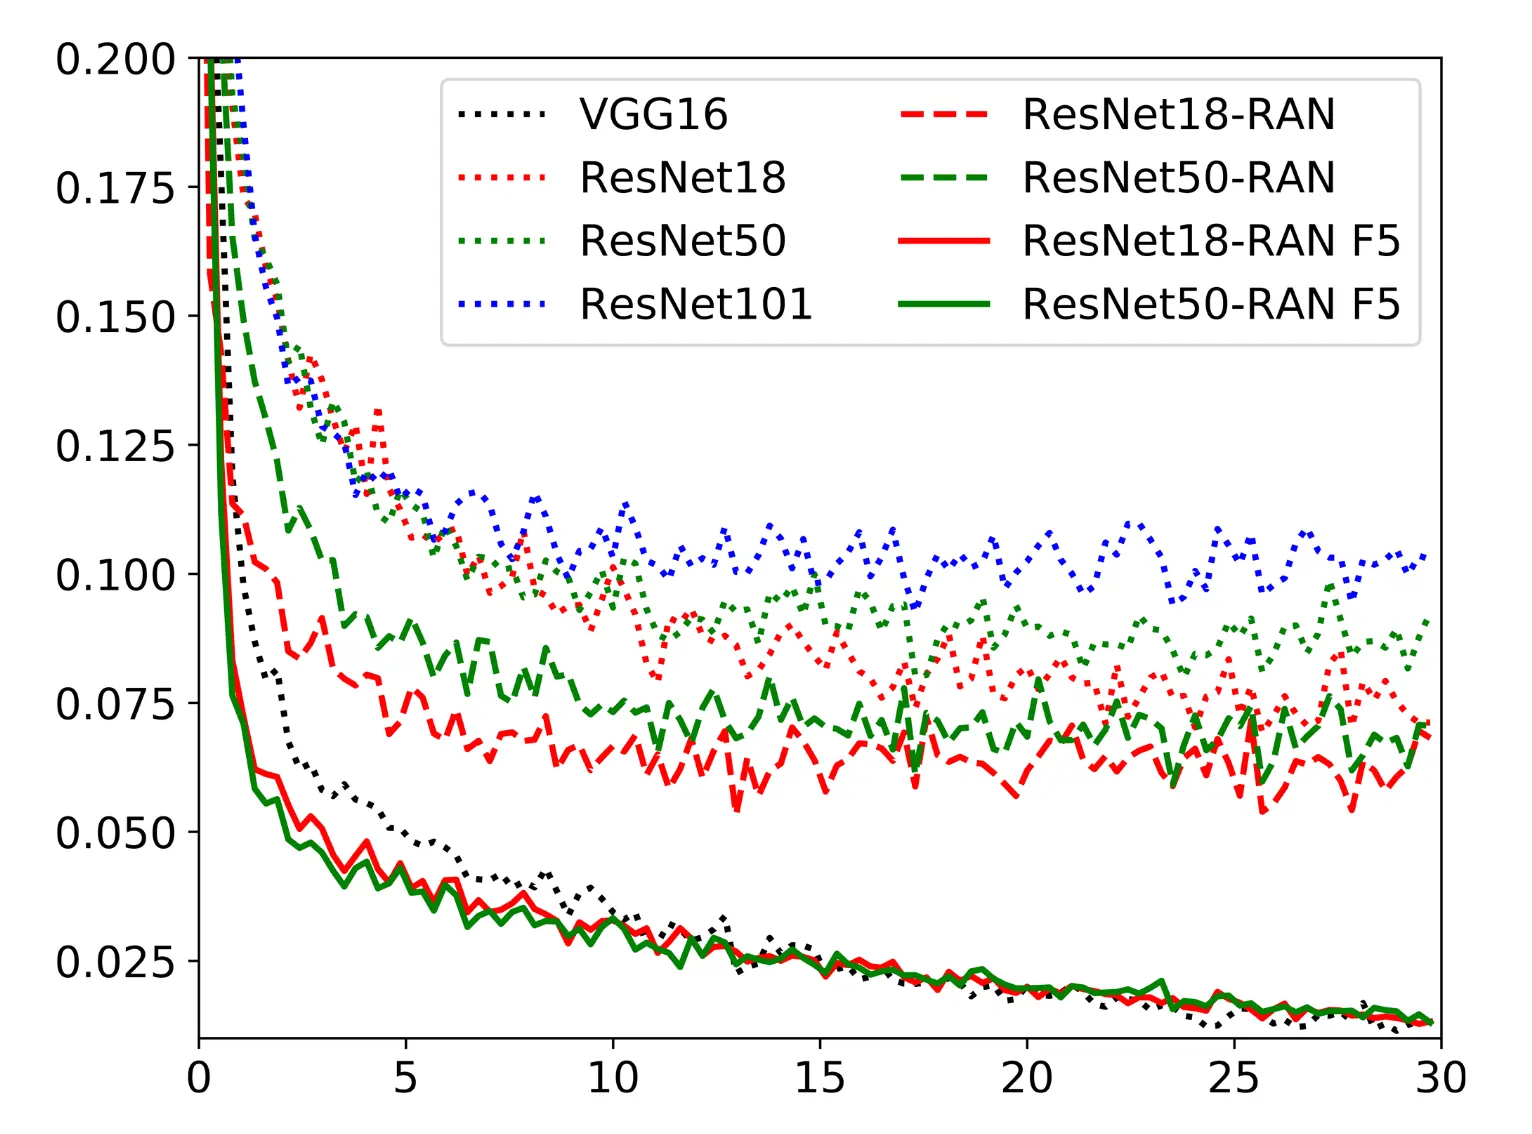
总之,在 WSOD 任务中直接使用 ResNet 主干网时,我们观察到了不加以区别的 Proposal 表示和收敛性差的问题,这导致了检测性能的下降。由于 WSOD 需要定位对象实例,并在只有图像级标签的情况下联合学习 Proposal 特征。因此,直接在残差网络上堆叠 WSOD 头对卷积特征学习有很大的负面影响。而且在反向传播过程中,残差块中的捷径连接也会扩大 WSOD 头在整个骨干网中的不确定性和错误梯度,从而影响优化步骤的方向,无法推理出 Proposal 级分类器。从增加冗余的角度出发,我们提出了第一个原则,即在深度残差网络骨干和 WSOD 头之间学习 Proposal 的高维视觉表示的冗余适应颈(RAN)是定位对象实例和联合学习判别特征的关键。我们的直觉是,冗余特征表示确保了弱监督下的各种 WSOD 约束,并降低了来自 WSOD 头的不确定和错误梯度的负面影响,而卷积层则专注于全图像特征学习。我们为 ResNet(ResNet-RAN)实现了这一原理并将其可视化。我们没有通过堆叠卷积层来实例化 RAN,而是使用了多个感知层,这些感知层在提取约 2,000 个 Proposal 的高维度特征方面具有内存可行性。具体来说,在 WSDDN 头之前,ResNet 中的最后一个全局池化层被两个高维度为 2,048-4096 的 FC 层取代。 我们在图 e 和 f 中展示了来自 conv5 和来自 RAN 的两个 FC 层(即 ran1 和 ran2)的 Proposal 特征。ResNet18-RAN 和 ResNet50-RAN 在 ran1 和 ran2 层获得了具有区分性的 Proposal 特征。上图显示,ResNet-RAN 也收敛到了更好的最小值。这表明,定位对象实例和学习 Proposal 特征这两项纠缠在一起的任务是共同优化的。为了进一步探索 RAN 的极限,我们冻结了骨干层中的所有卷积层,从而完全消除了 WSOD 头对卷积层的影响。图 g 和 h 表明,Proposal 的特征具有更强的区分度。同时,上图中的优化景观也得到了改善(ResNet-RAN F5)。这一有趣的观察结果表明,RAN 具有弹性能力,可以容纳纠缠不清的任务。
Robust Information Flow
残差学习通过跳跃连接增强信息流,极大地缓解了深度网络中梯度消失的问题。然而,深度残差网络仍然存在两个主要缺点,即 ResNet 和 DenseNet 阻碍了弱监督下信息流对不确定和错误梯度的鲁棒性。首先,Stem 块中的大核(7 × 7)卷积削弱了对象边界的信息,导致对象边界的不确定性。其次,非极大下采样(即 2 × 2 Strided 卷积和 AveragePool)也可能会损害信息流,使小实例难以察觉,因为在弱监督下,非极大下采样可能无法保留流经网络的信息激活和梯度。
从提高鲁棒性的角度出发,我们提出了在 Backbone 中使用小核(Small-Kernel SK)卷积和 MaxPool(MP)下采样来提高信息流鲁棒性的原理,从而使物体边界更精细,对小物体更敏感。具体来说,我们用三次保守的 3 × 3 卷积来替换原始 Stem 块,第一和第三次卷积之后是 2 × 2 MaxPool 层。在向下采样时,我们用 MaxPool 代替分步卷积或 AveragePool 操作,MaxPool 设置为 2 × 2,分步为 2 × 2,以避免输入激活之间的重叠。 保守卷积 Conservative Convolutions Conservative convolutions 是一种卷积神经网络(CNN)中的卷积方式,它主要关注于在输入和输出之间保持信息的一致性。这种卷积操作特别注重输入特征图中的信息不会在卷积操作中流失或被忽略,因此被称为 “conservative”(保守)。
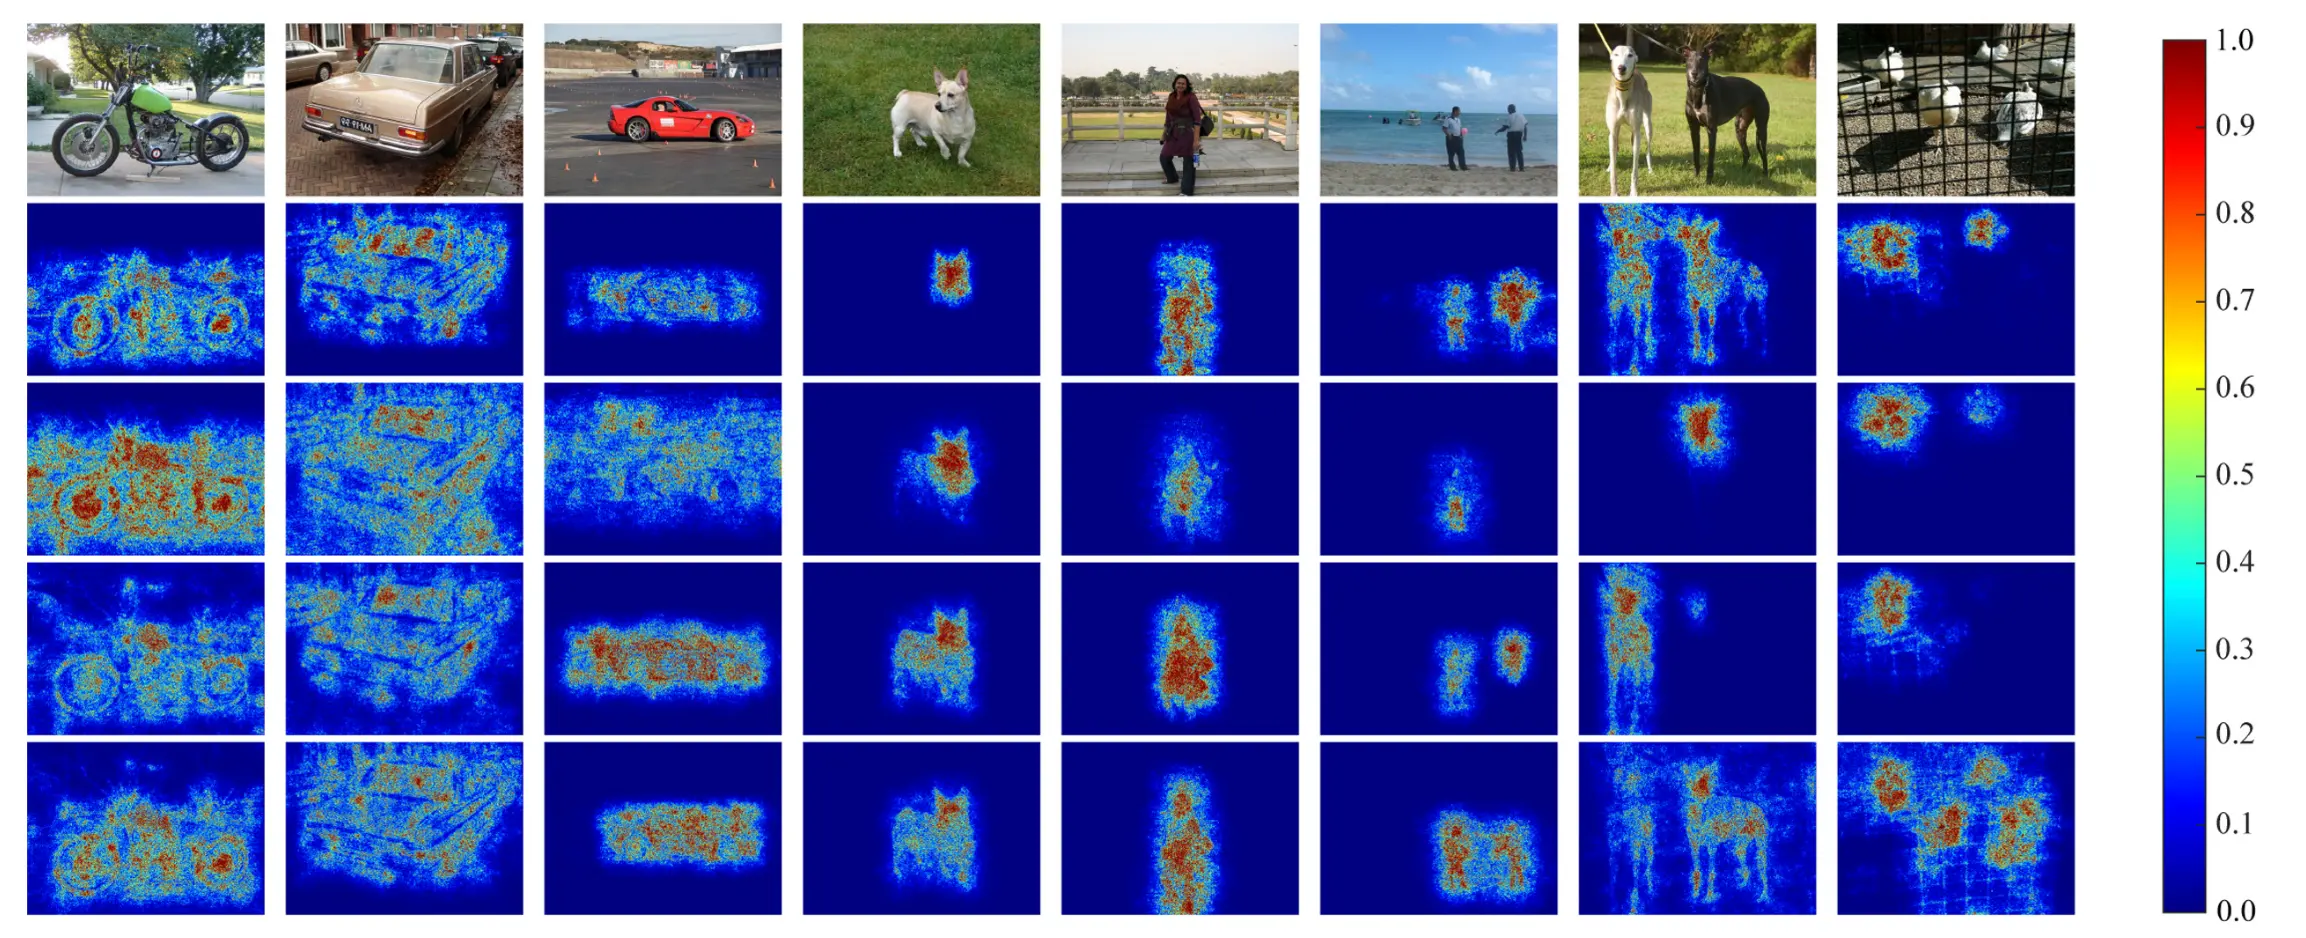
我们利用输入图像的梯度图来观察信息如何在网络中流动。在下图的第二行和第三行中,我们观察到 R-18-RAN 中物体边界的梯度比 VGG16 更模糊。而且 R-18-RAN 中遗漏了一些物体部分和小实例的梯度。然而,R-18-RAN-SK 的梯度图提供了更精细的物体边界,R-18-RAN-SK-MP 对多个小物体做出了响应。
Proposal Feature Alignment
现代深度残差网络通常使用 5 个阶段,以 32× 子采样提取全图像特征图。这带来了较大的有效感受野,而这对高分类准确性至关重要。然而,大跨度可能会导致 Region Proposal 和来自 RoIPool 层的池化特征之间的错位。造成特征不对齐的原因有两个:除 Stride 后的坐标取整,以及将投影 Proposal 分割成离散分区。虽然错位对 FSOD 的负面影响不大,但它会在 WSOD 中引入严重的特征模糊性,从而进一步引发不稳定问题。
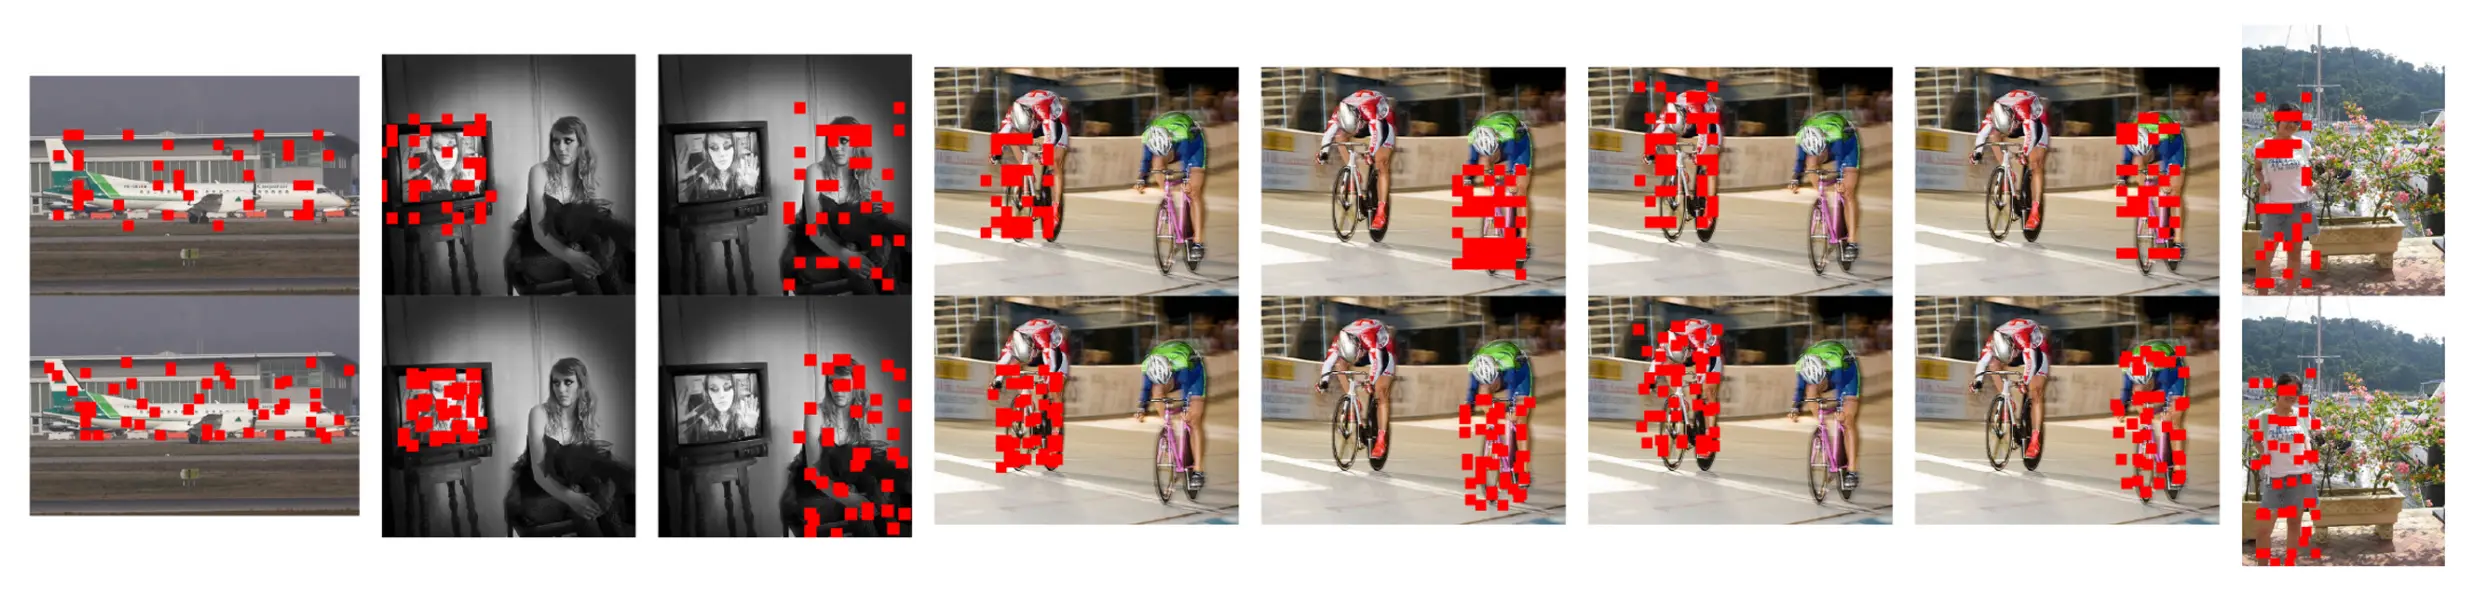
为了解决 Proposal 特征不对齐的问题,我们利用扩张卷积(Dilated Convolution - DC)为 WSOD 提取高分辨率全图像特征图。具体来说,我们在第 3 阶段后固定空间大小,并在随后的阶段中使用倍率为 2 的扩张卷积,这样只需 8 倍的子采样。下图显示了 RoIPool 的采样位置。在前三列中,R-18-RAN 中 RoIPool 的采样位置可能会超出 Proposal 的边界,这是因为坐标是圆形的,而 R-18-RAN-DC 则限制了 Proposal 内部的采样区域。如下图最后五列所示,在低分辨率特征图中将 Proposal 量化为离散的分区也会导致采样位置的多样性降低,而通过扩张卷积得到的高分辨率特征图则能提供更多样化的信息。 扩张卷积 扩张卷积(Dilated Convolution) 是一种在标准卷积的基础上进行扩展的卷积操作,它通过在卷积核中的元素之间插入空洞(即“扩张”)来增加感受野,而不增加参数数量或计算量。扩张卷积也被称为空洞卷积(Atrous Convolution),它在计算机视觉任务中,如语义分割、物体检测等,得到了广泛应用。
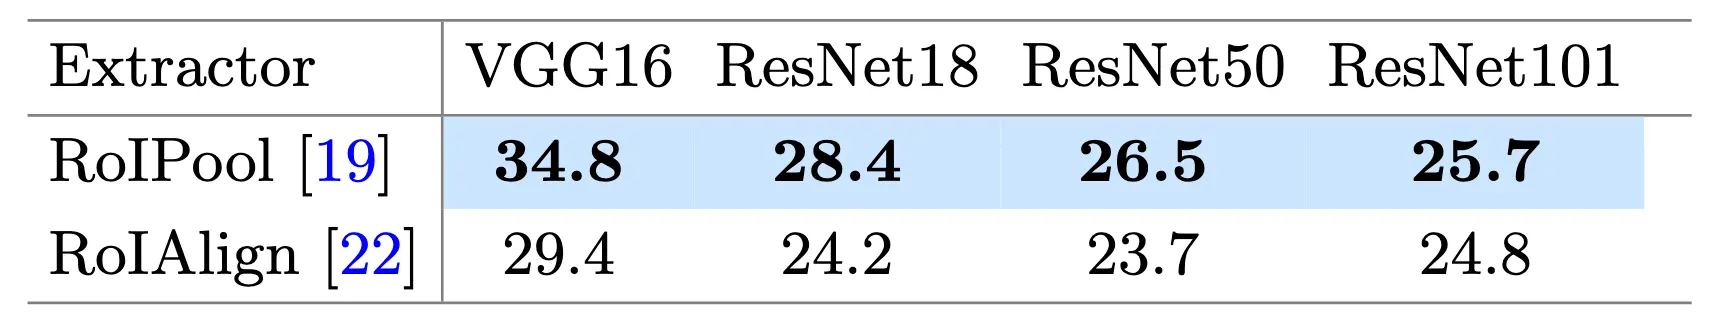
值得注意的是,RoIAlign 使用双线性插值来计算离散箱中采样位置的精确值,旨在解决量化误差。然而,RoIAlign 在固定位置采样激活,这导致性能较差。
结果量化
数据集
- PASCAL VOC 2007
- PASCAL VOC 2012
- MS COCO
指标
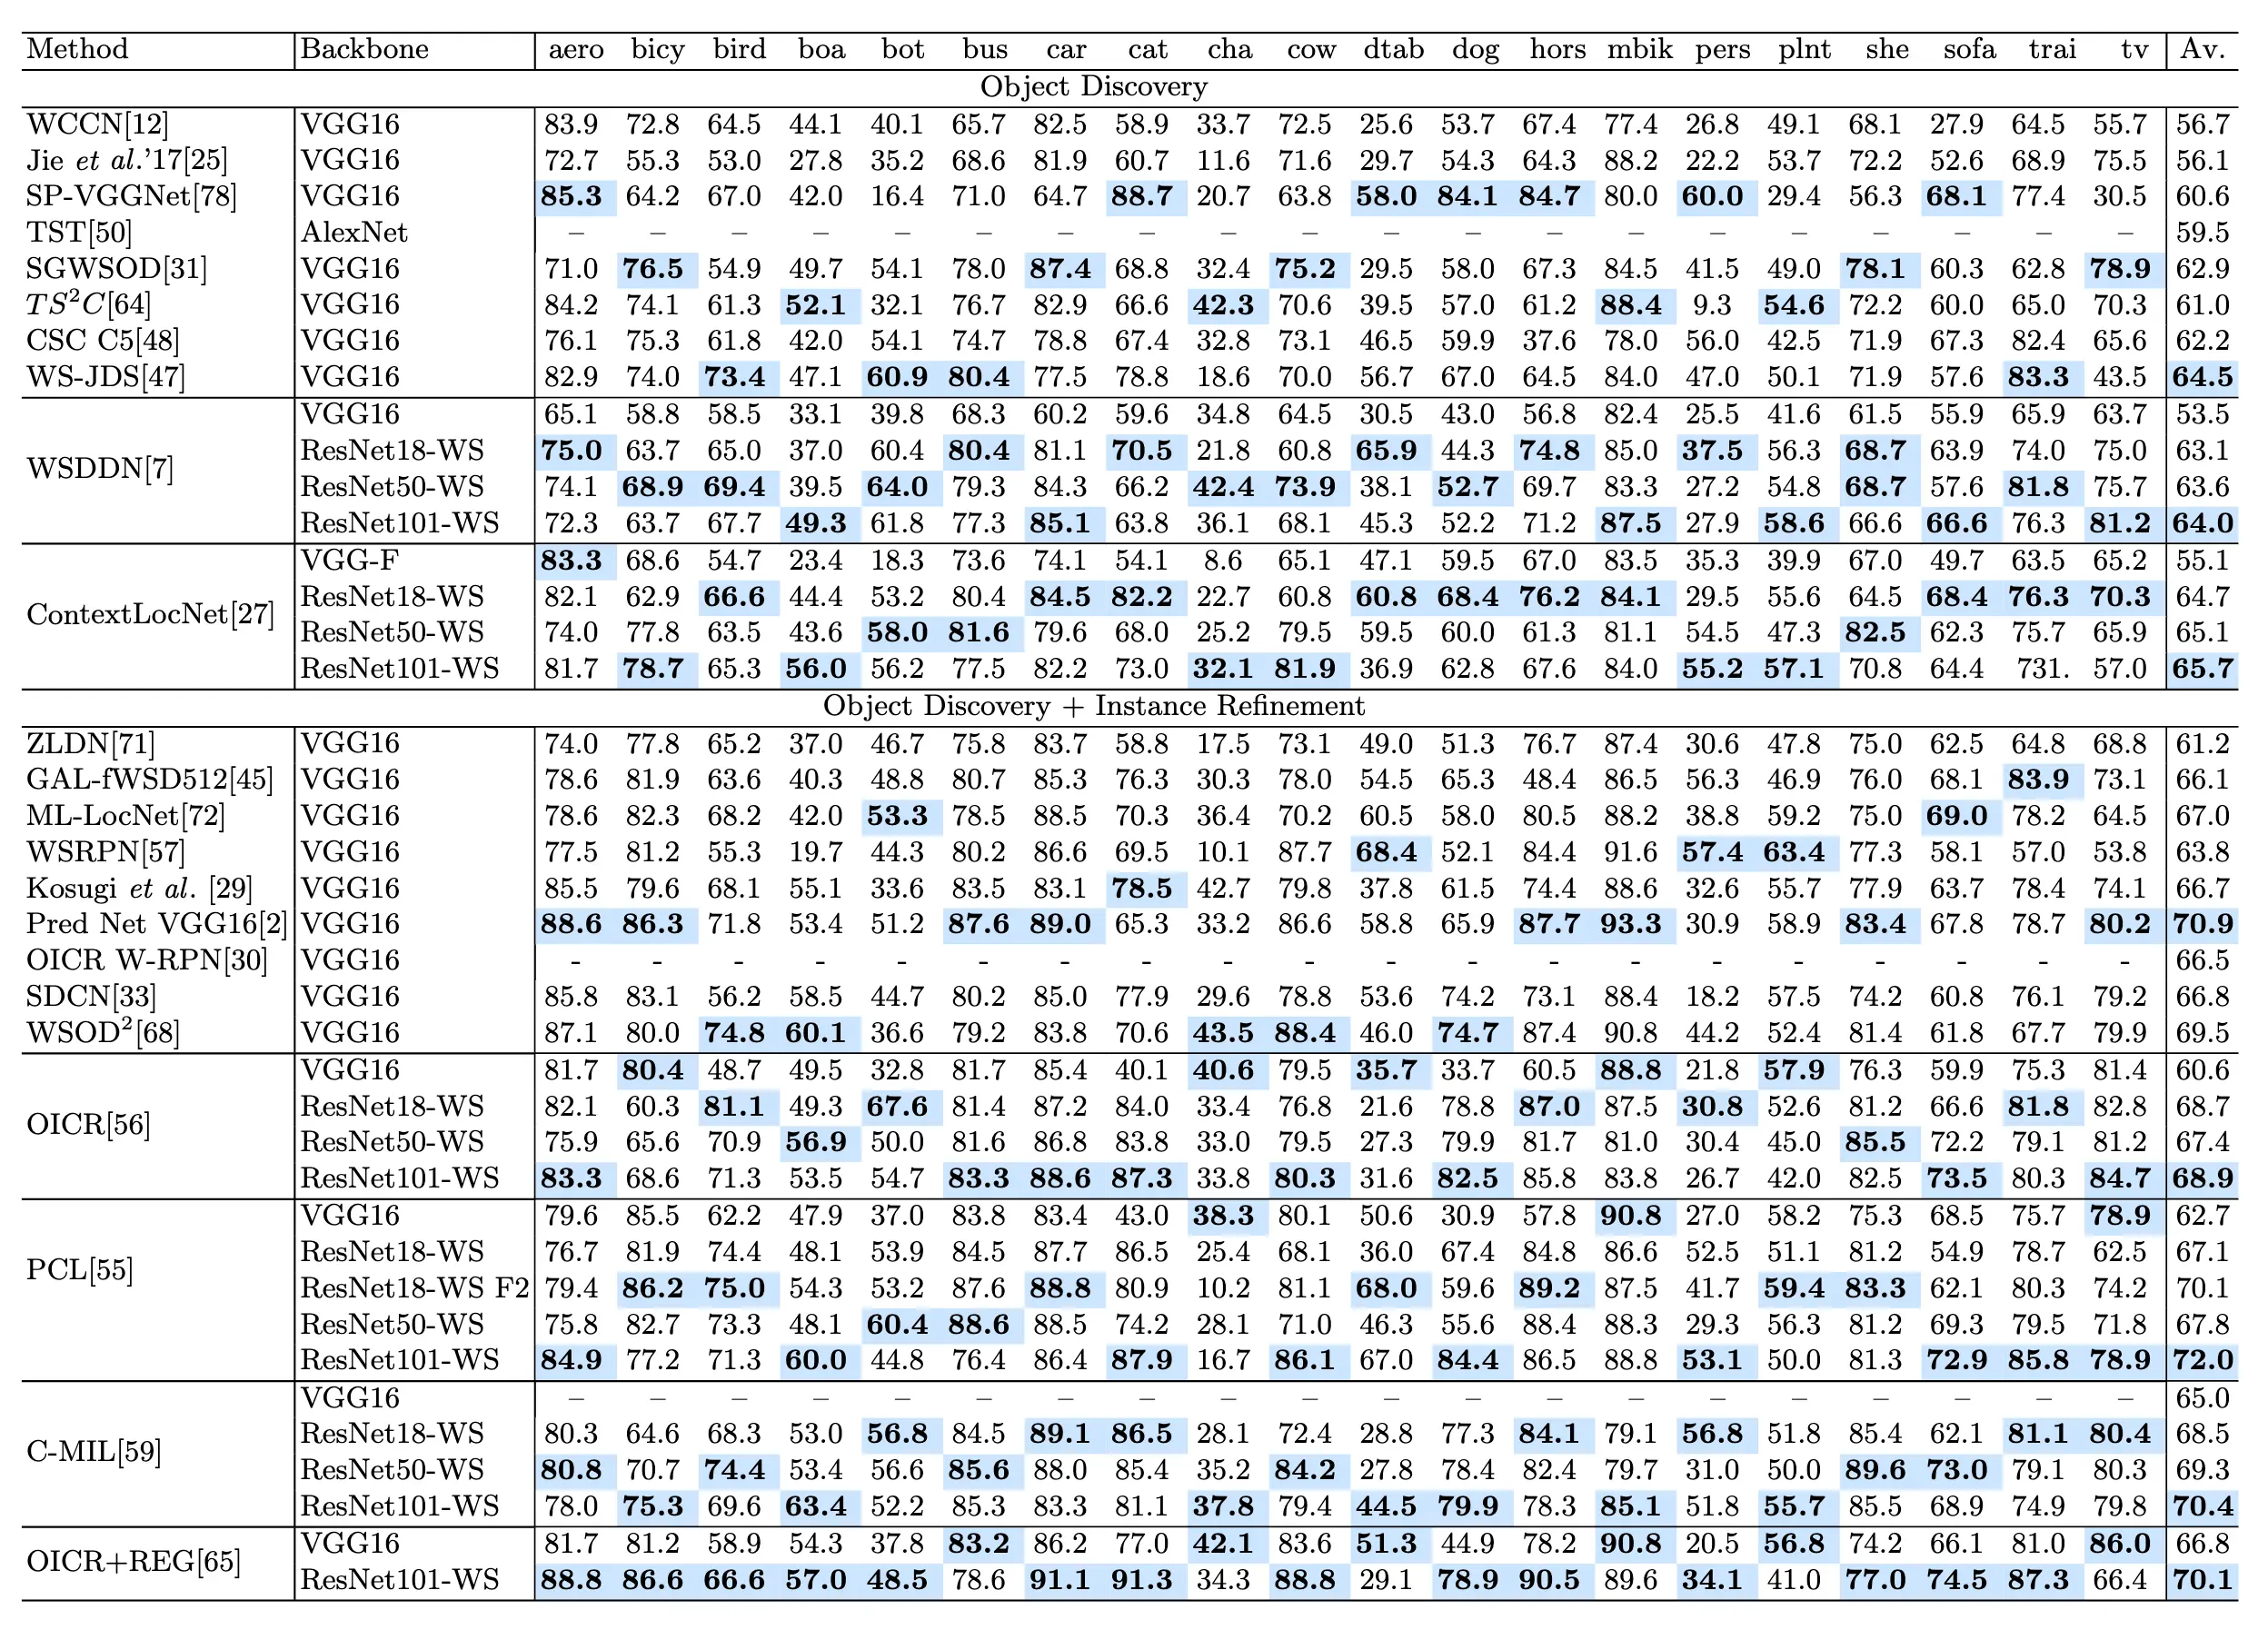
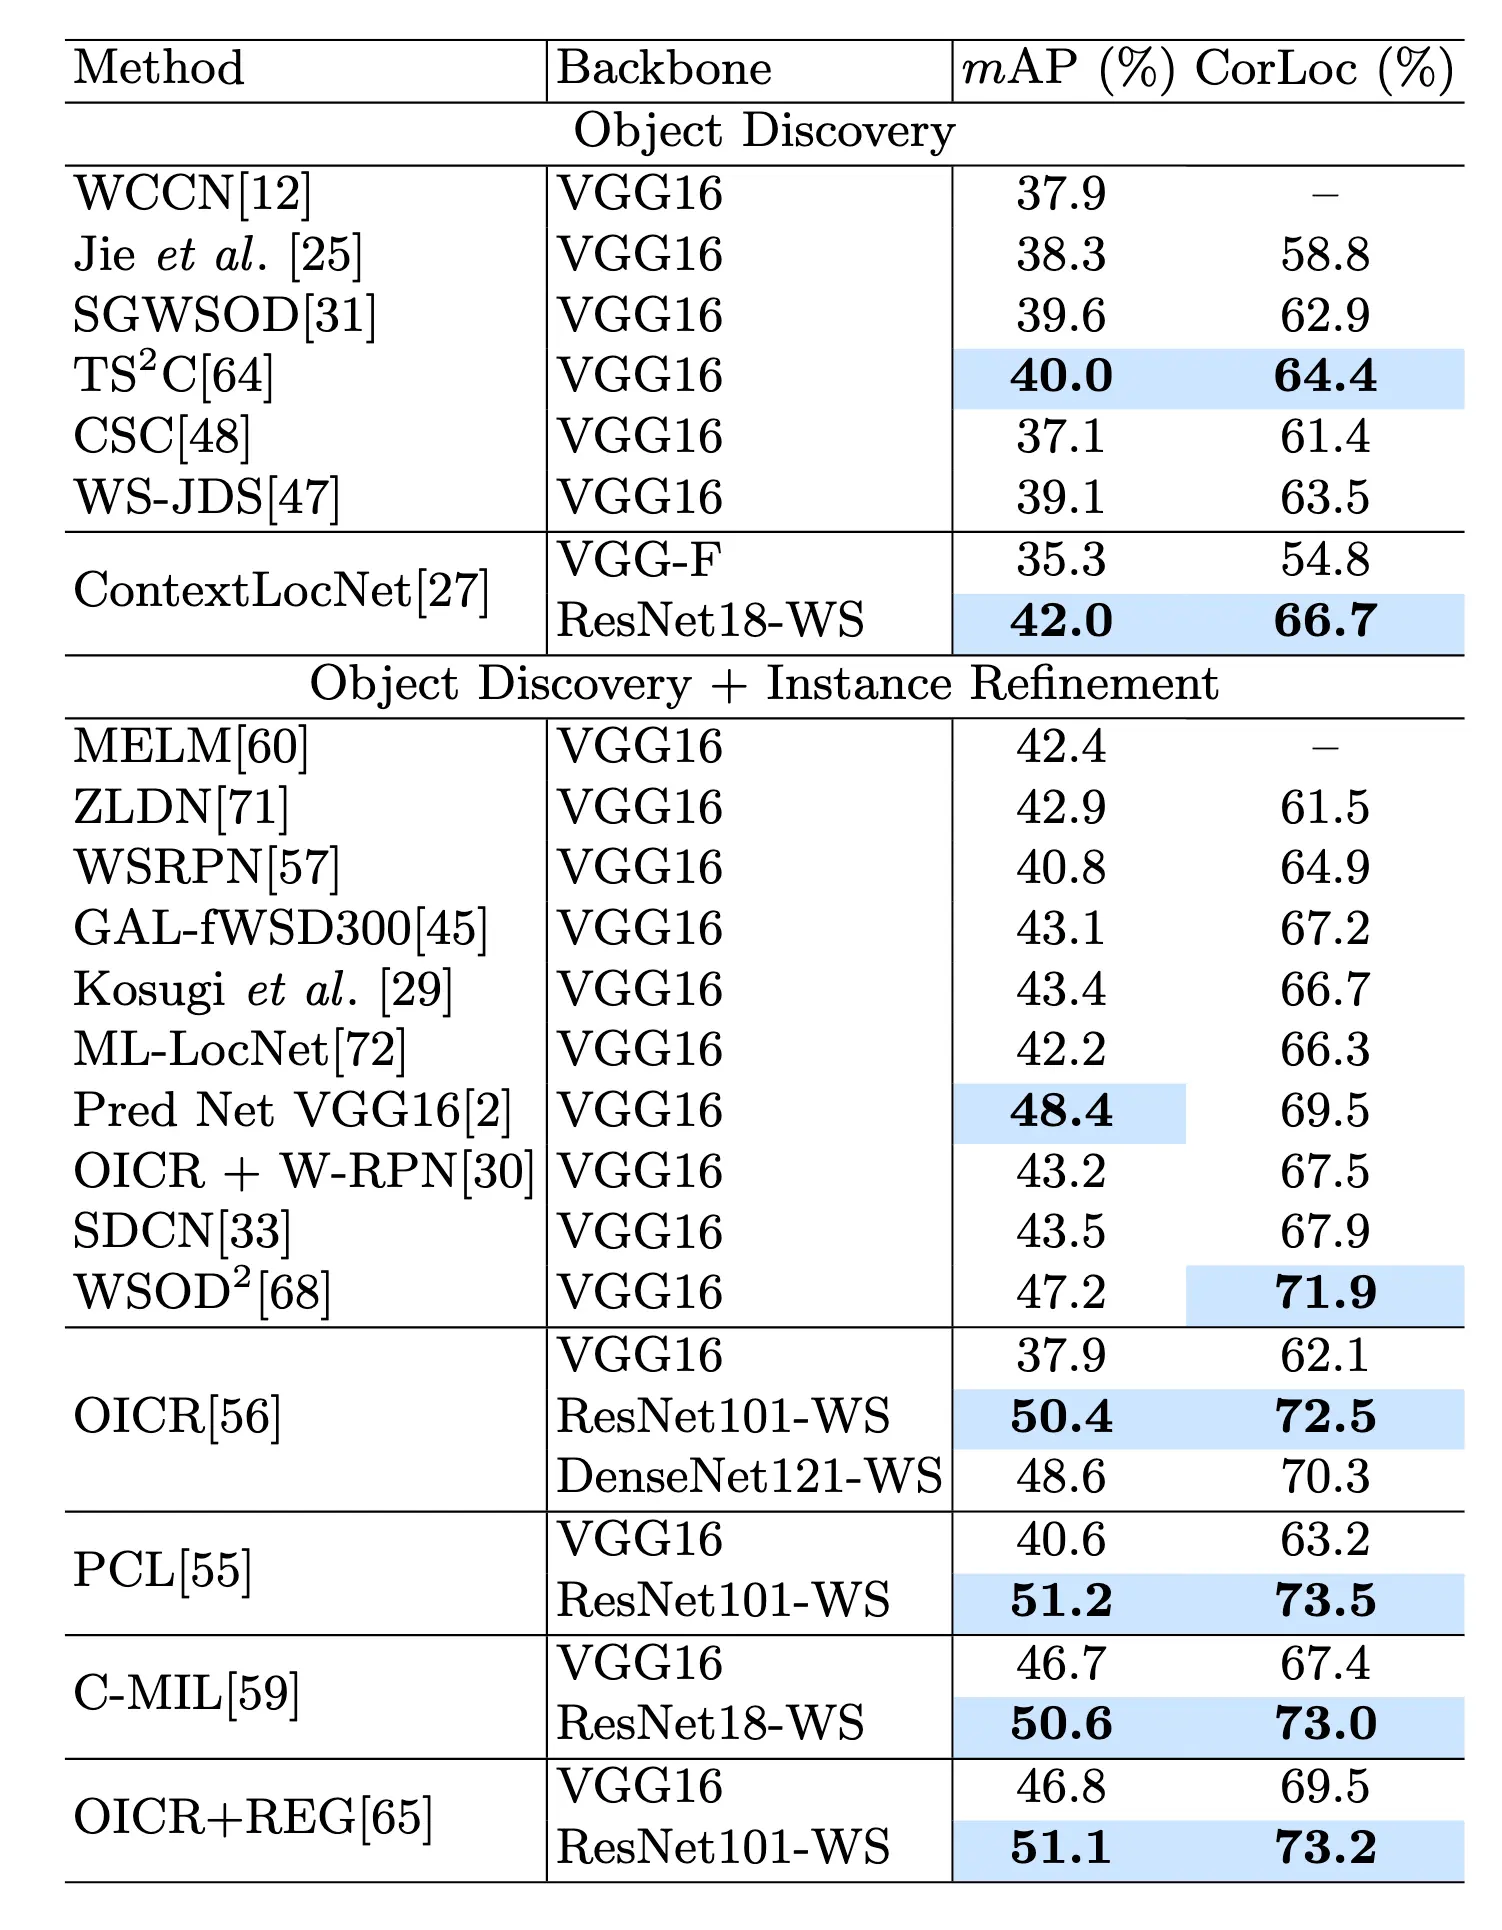
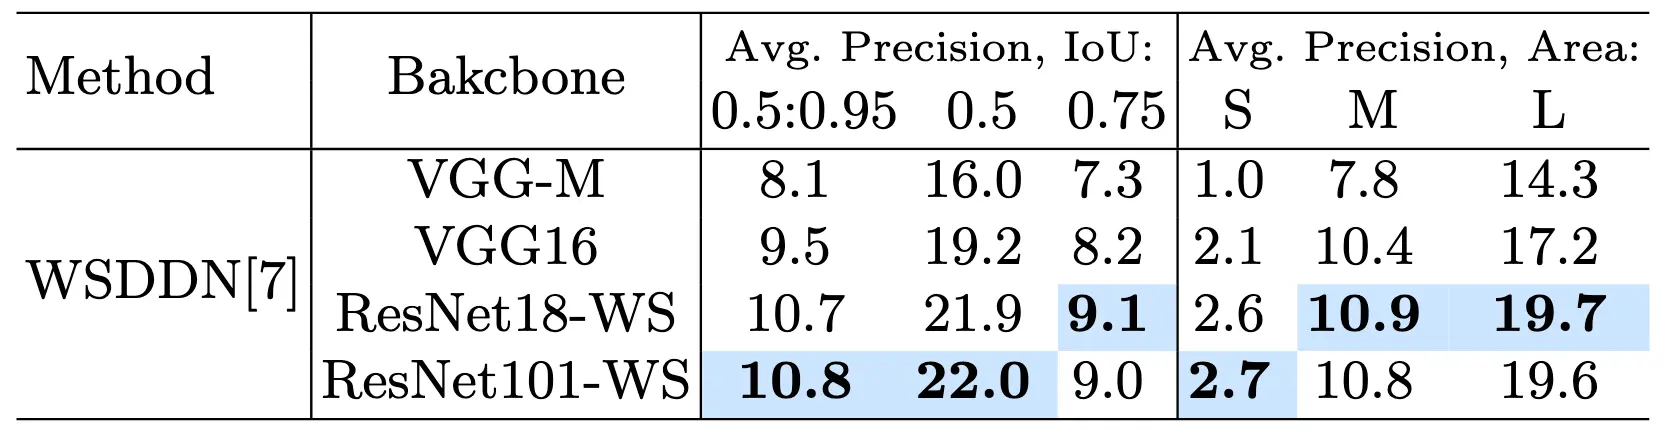
CorLoc 表示一种方法根据 PASCAL 标准正确定位目标类别对象的图像百分比。mAP 遵循标准 PASCAL VOC 协议,使用预测方框与 GT 方框 50% IoU 的 mAP(mAP-50)。对于 MS COCO 数据,使用标准 COCO 指标,包括不同 IoU 阈值和实例尺度下的 AP。
实验细节
所有主干网络均使用 ImageNet ILSVRC 上预训练的权重进行初始化。我们在 4 个 GPU 上使用同步 SGD 训练。小批量涉及每个 GPU 1 个图像。在多尺度设置中,我们使用的尺度为 {480, 576, 688, 864, 1200}。我们将图像中 Proposal 的最大数量设置为 2000。除非另有说明,否则我们会冻结主干中所有预先训练的卷积层。测试成绩是所有尺度和翻转的平均值。检测结果使用阈值0.3通过非极大值抑制进行后处理。
消融实验
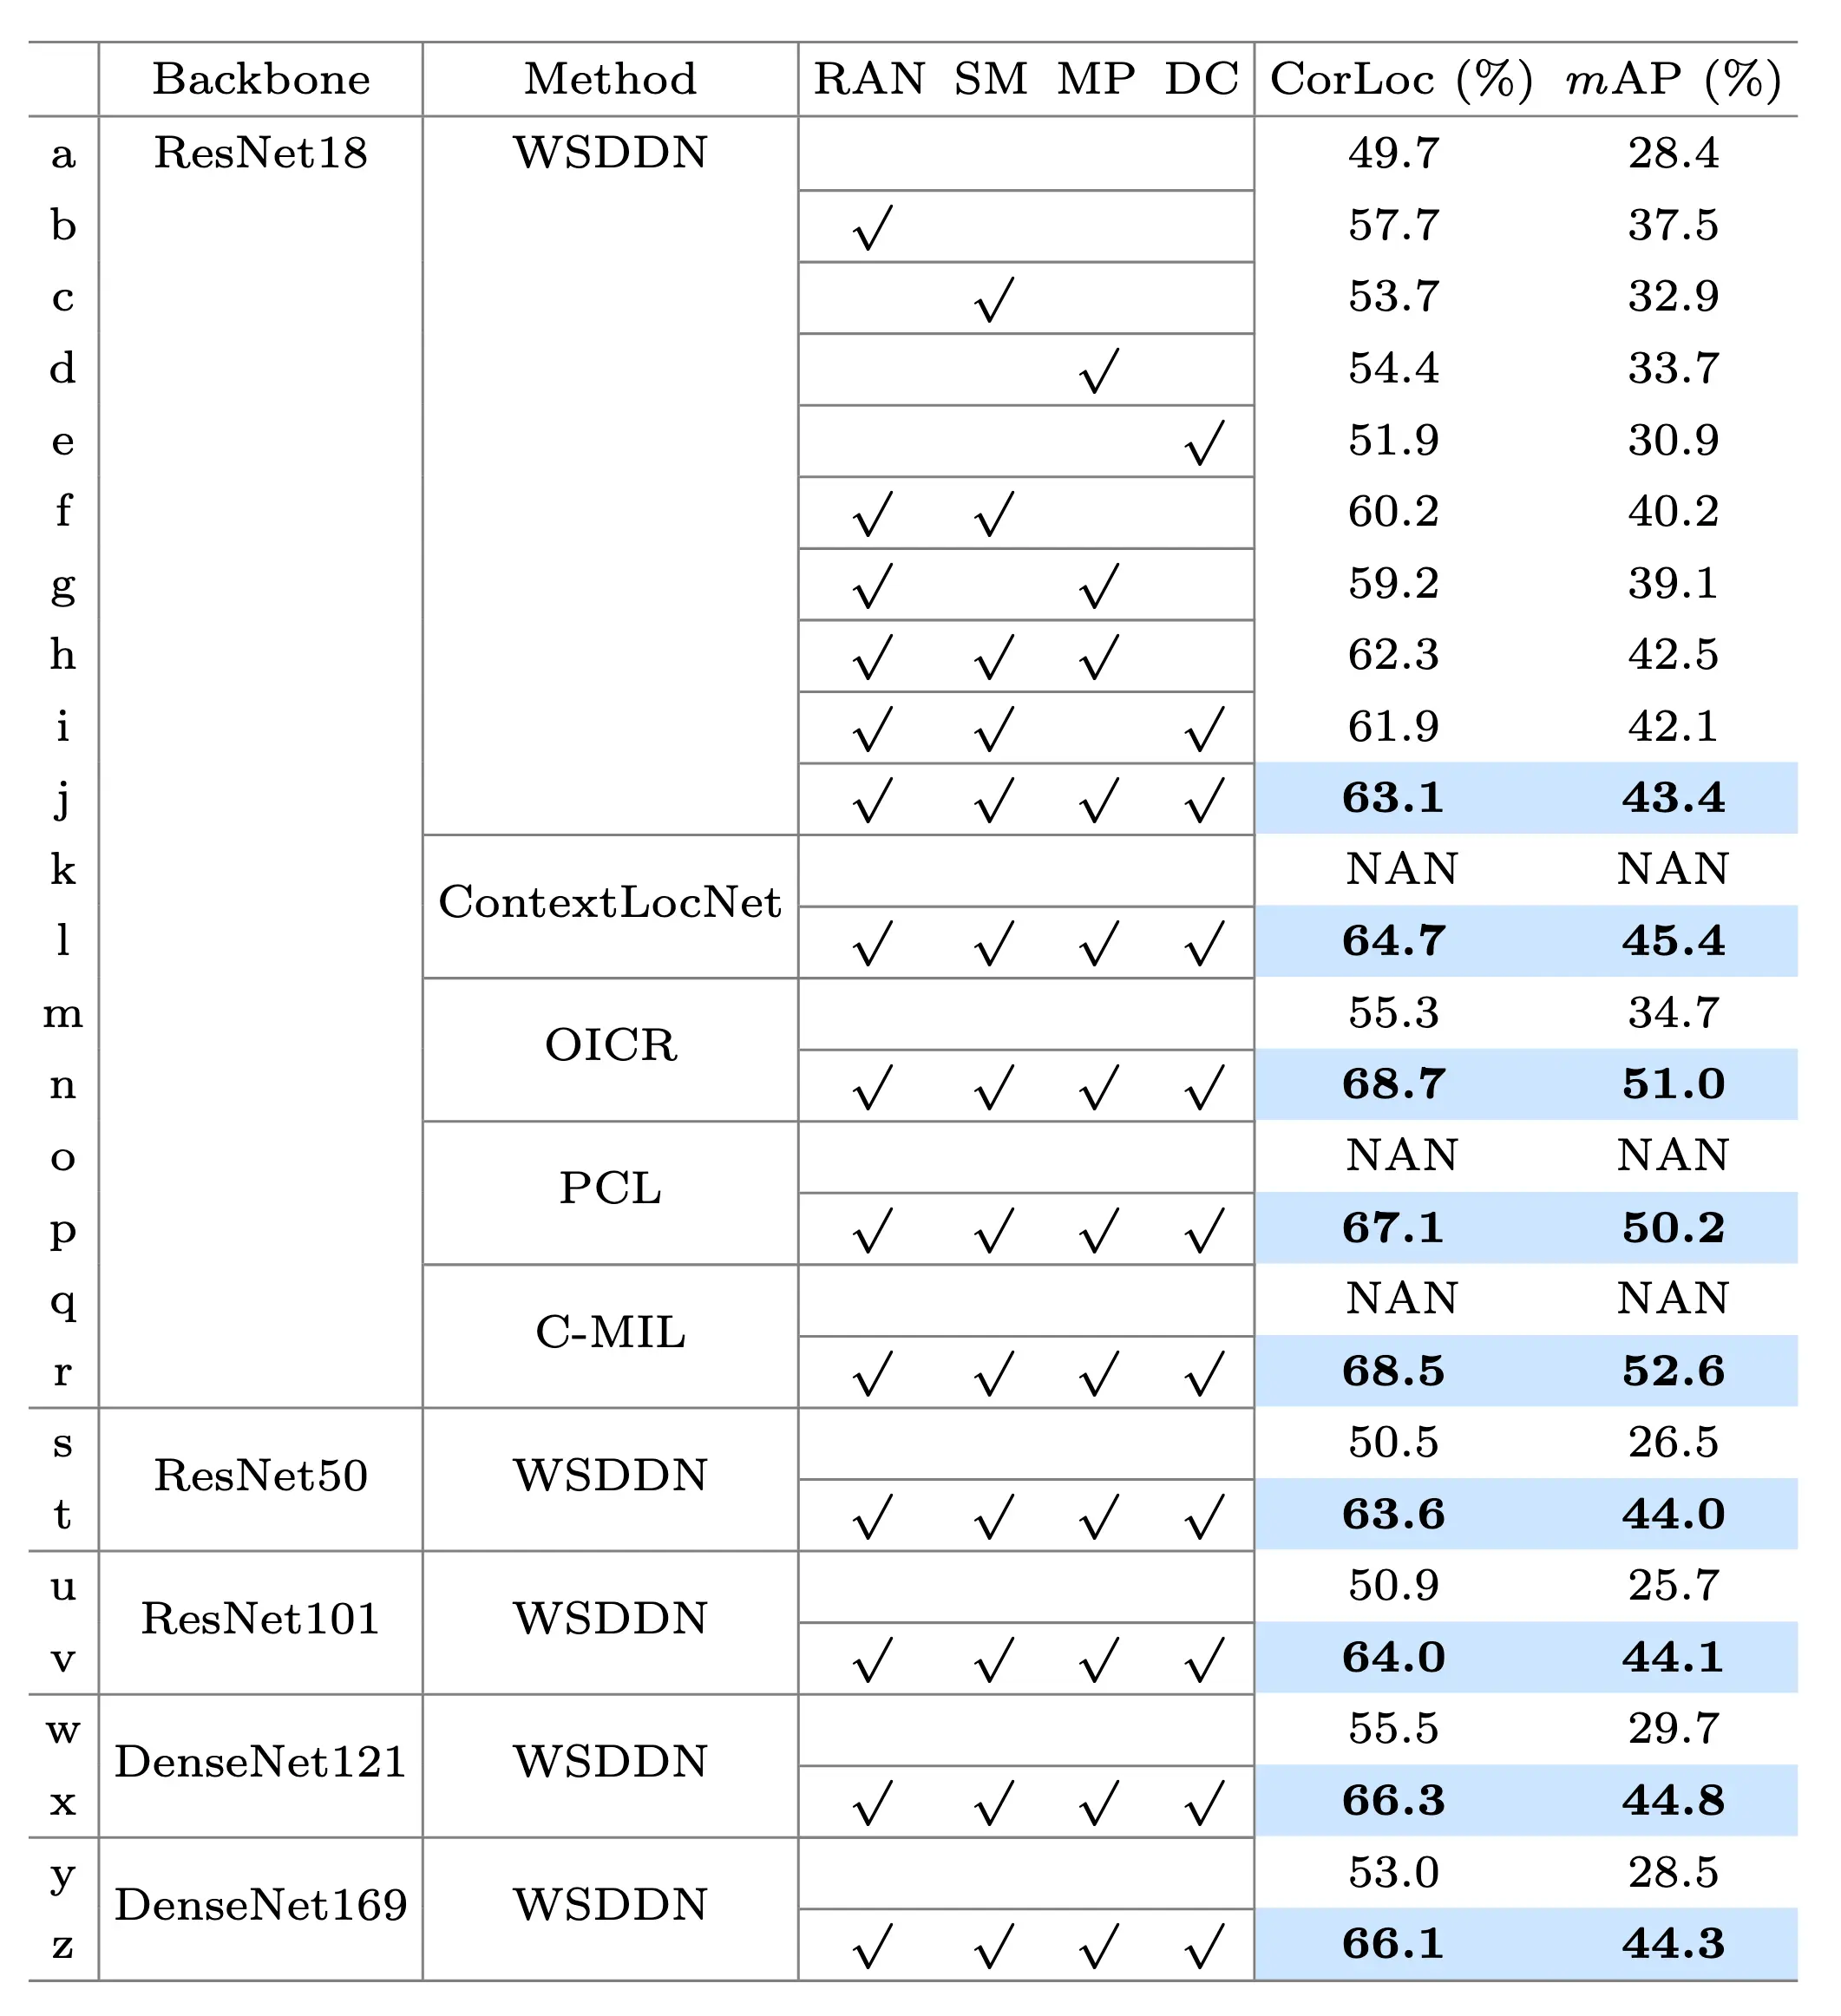
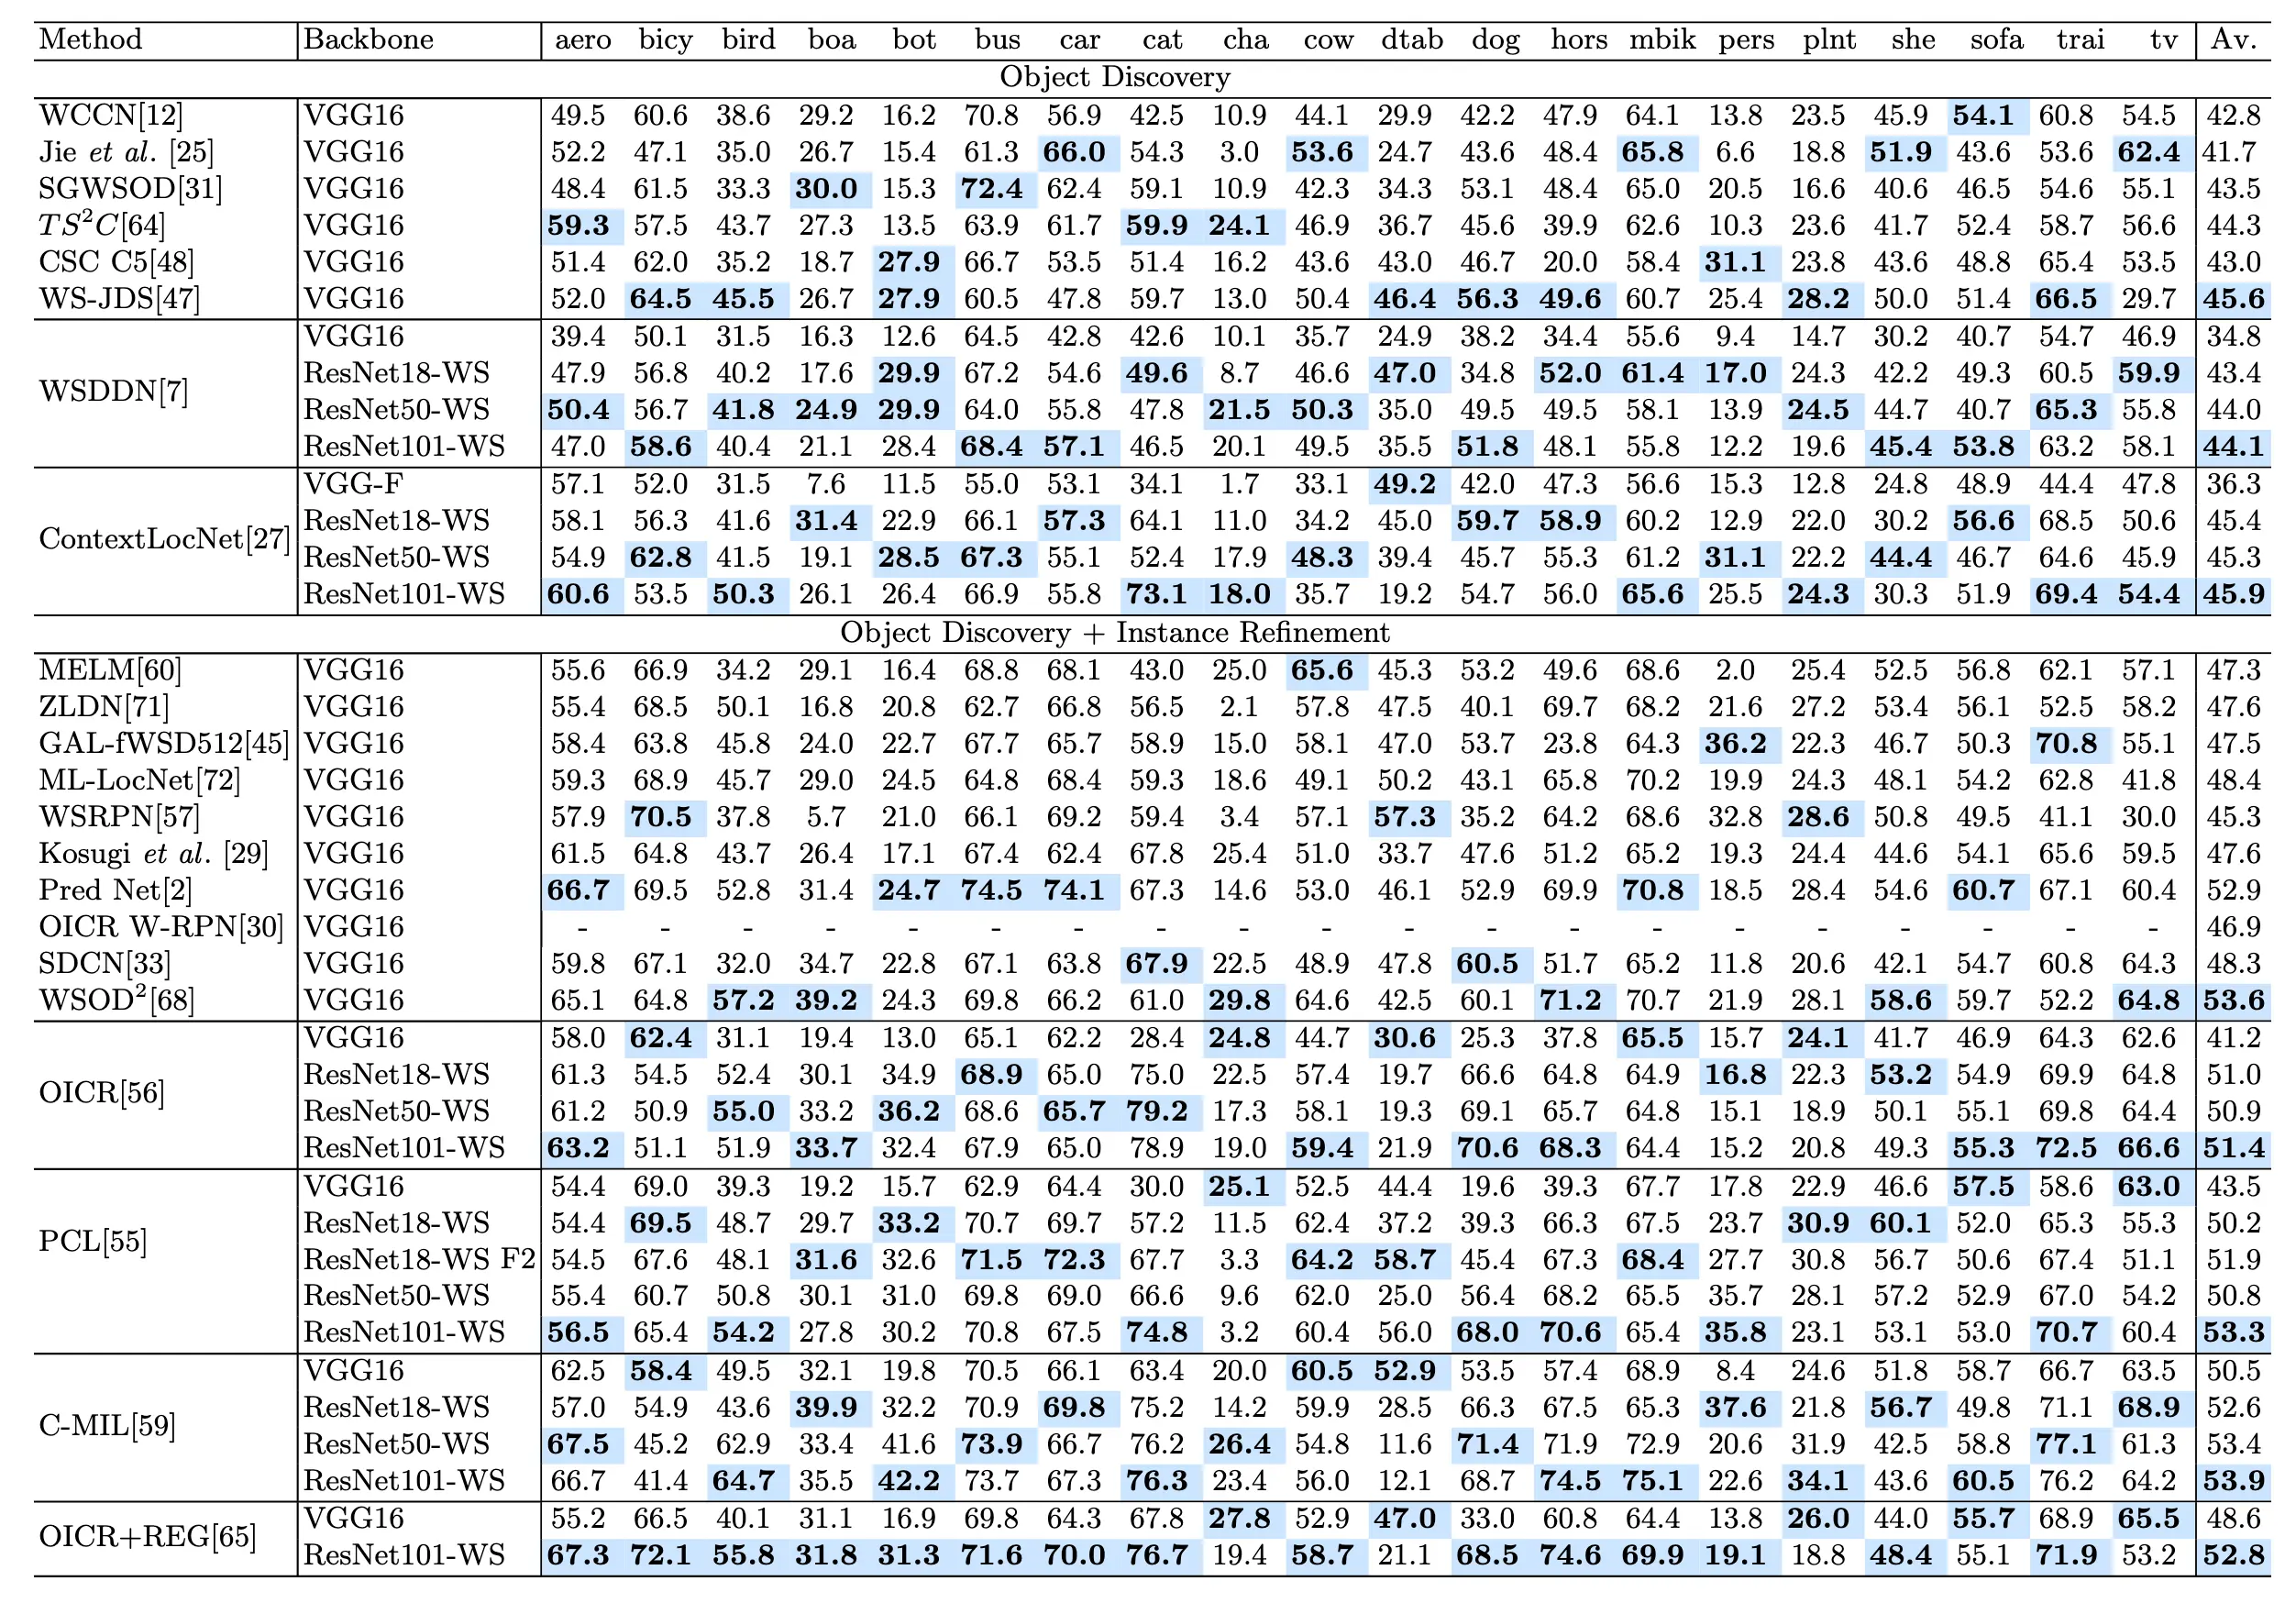
与 SOTA 相比
结论
本文提出了一系列设计原则,以充分发挥深度残差学习在 WSOD 任务中的优势。广泛的实验表明,与普通网络相比,所提出的原则使深度残差网络在各种 WSOD 方法中实现了显著的性能提升,同时也确立了新的技术水平。请注意,我们的贡献并不局限于 ResNet 或 DenseNet,其他骨干网络(如 GoogLeNet、WideResNet)也可以从针对 WSOD 任务提出的原理中受益。