基本概念
问题定义
弱监督目标检测(Weakly-Supervised Object Detection,WSOD)旨在仅使用图像级标签进行训练,同时完成对象实例的分类与定位。
如下图所示,给定一张包含猫和狗的图像,WSOD 不仅需要识别图中的猫和狗,还需要使用边界框定位它们。与训练阶段使用实例级标注的全监督目标检测(Fully-Supervised Object Detection,FSOD)不同,WSOD 只能访问图像级标签。
由于监督信息有限,尽管目前已经提出了大量 WSOD 方法,但 WSOD 与 FSOD 之间仍然存在较大的性能差距。例如,当时较先进的 FSOD 与 WSOD 方法在 PASCAL VOC 2007 数据集上的 mAP 分别为 86.9% 和 56.8%。因此,如何提高检测性能仍然是 WSOD 的主要研究方向。
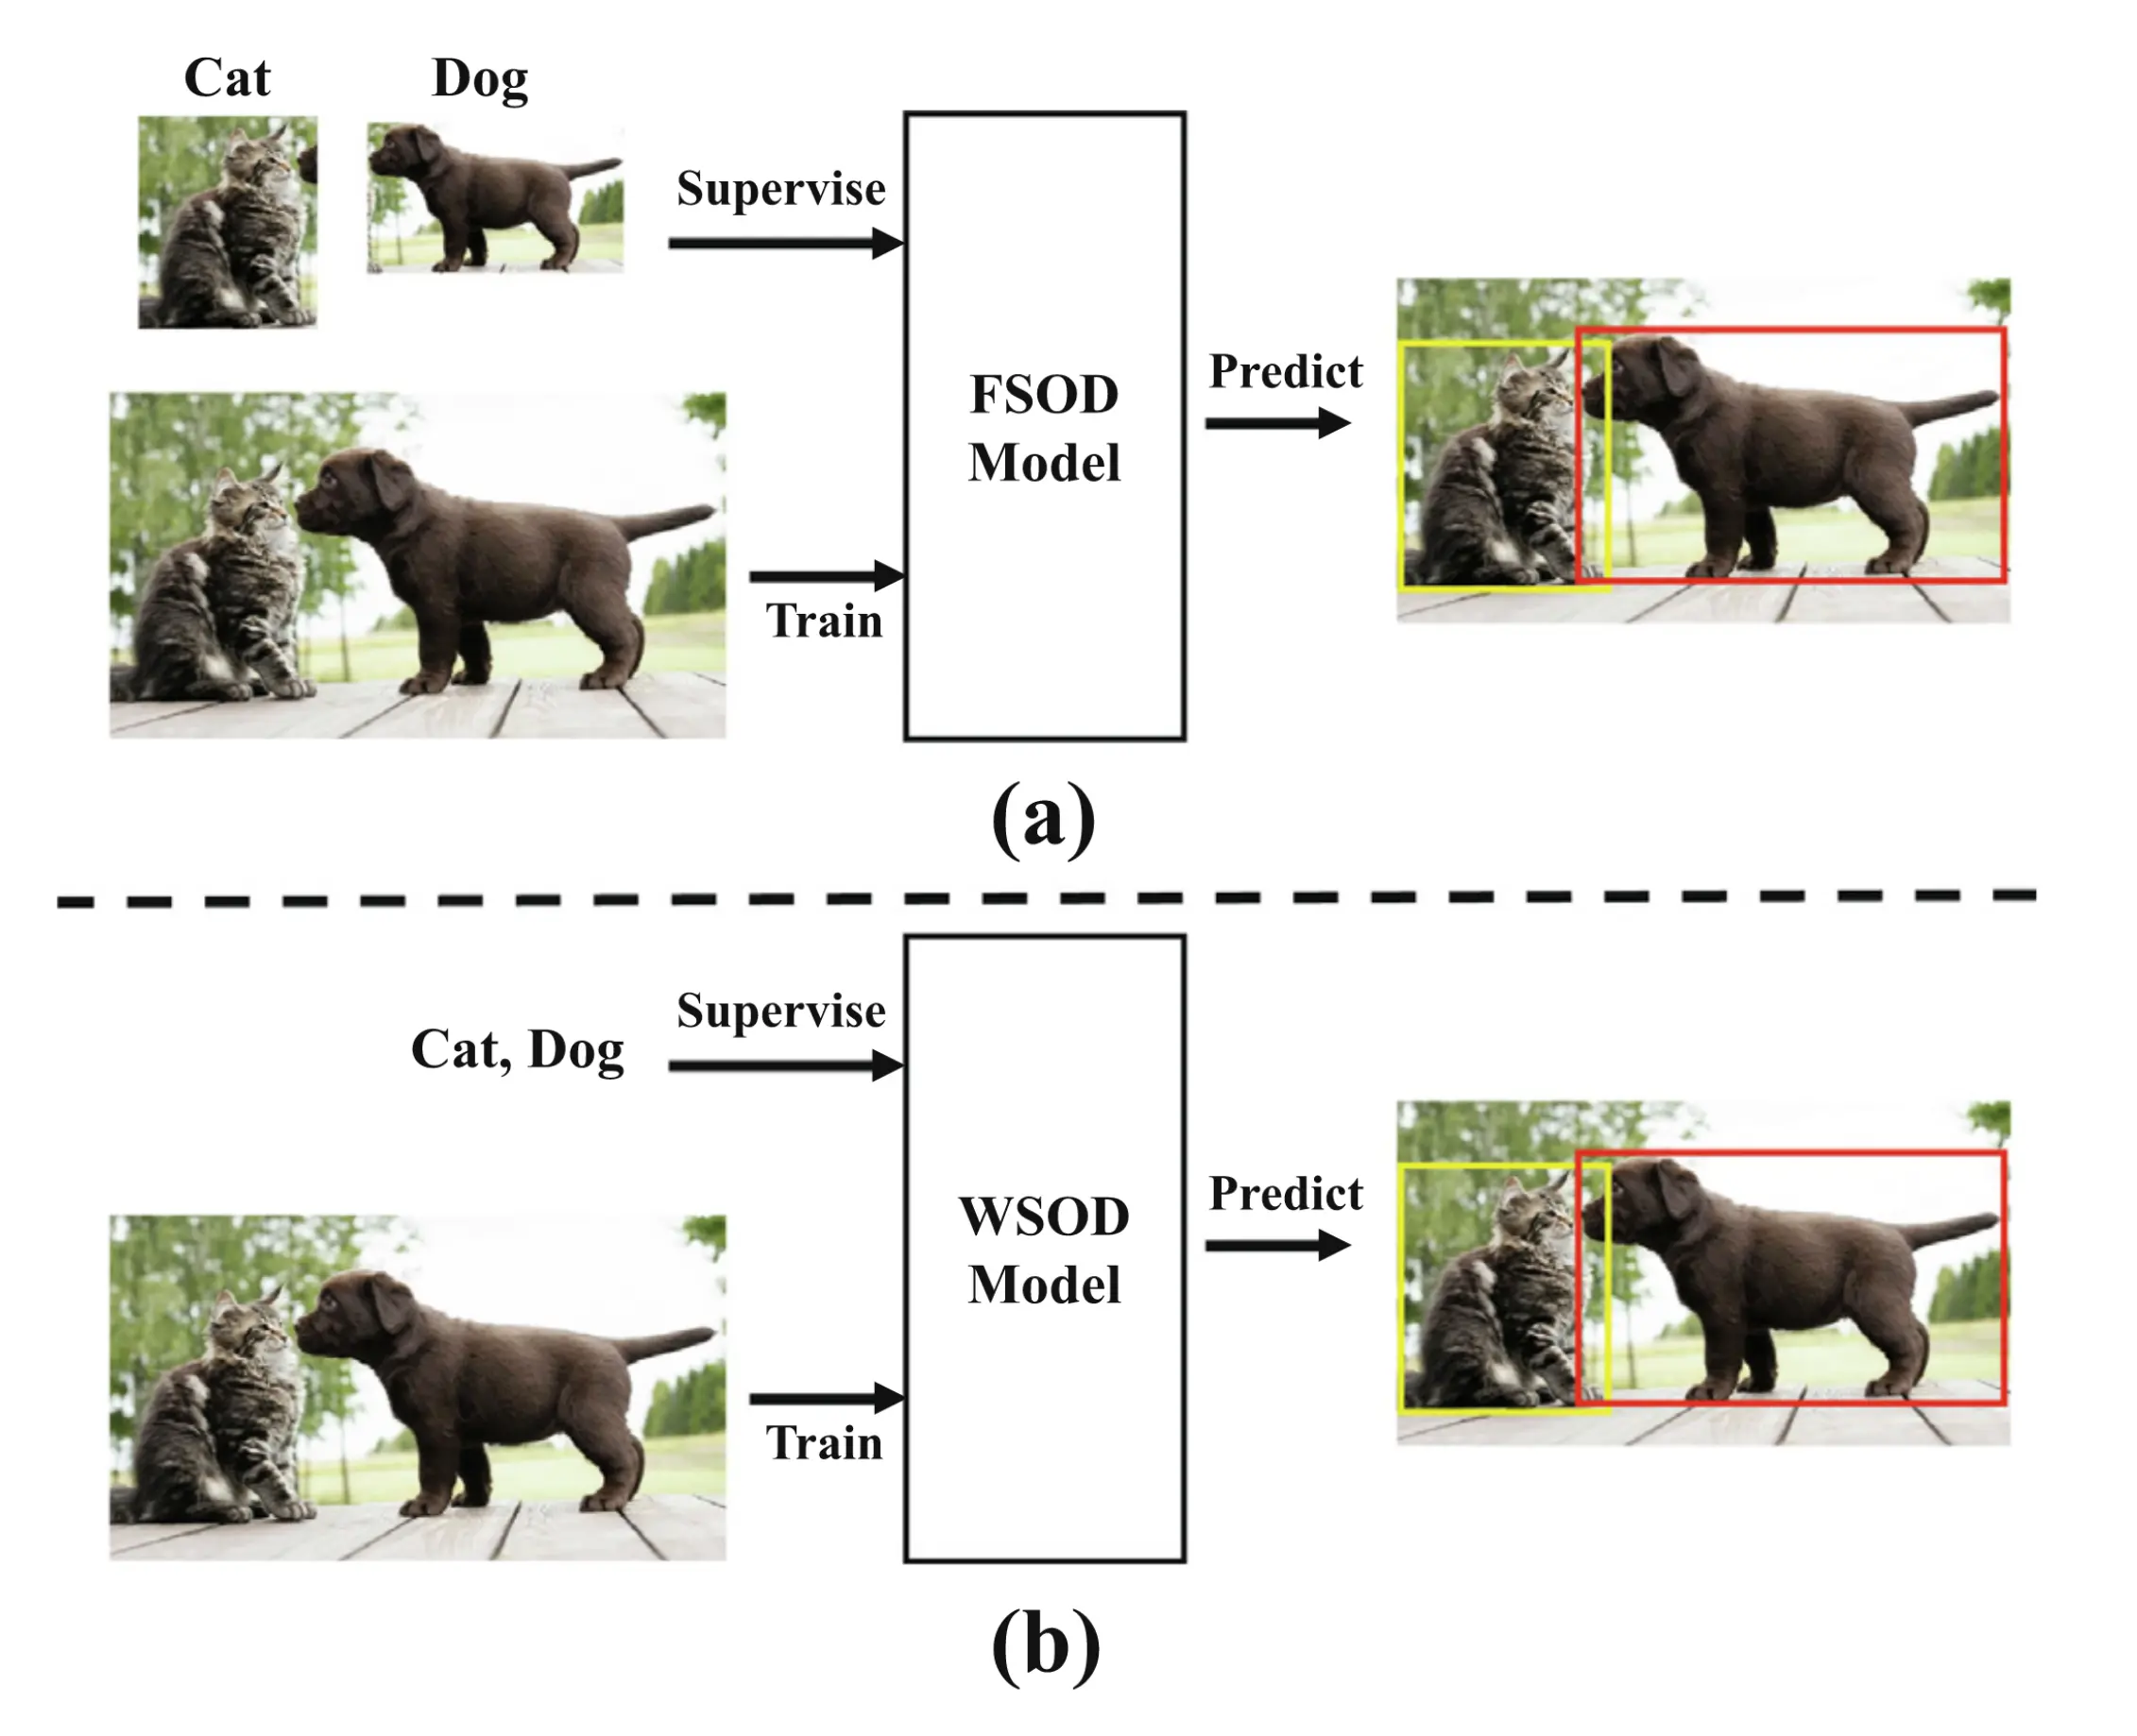
图 1:全监督目标检测(FSOD)与弱监督目标检测(WSOD)对比。
主要问题
判别区域问题
检测器倾向于关注物体中最具判别力的局部区域。在训练过程中,一个对象周围可能存在多个候选区域(Proposal),其中最具判别力的局部区域往往具有最高分数。例如,下图中的 A 区域比其他区域得分更高。如果模型仅根据分数选择正候选区域(Positive Proposal),就很容易只关注对象中最具判别力的部分,而不是完整的对象范围。
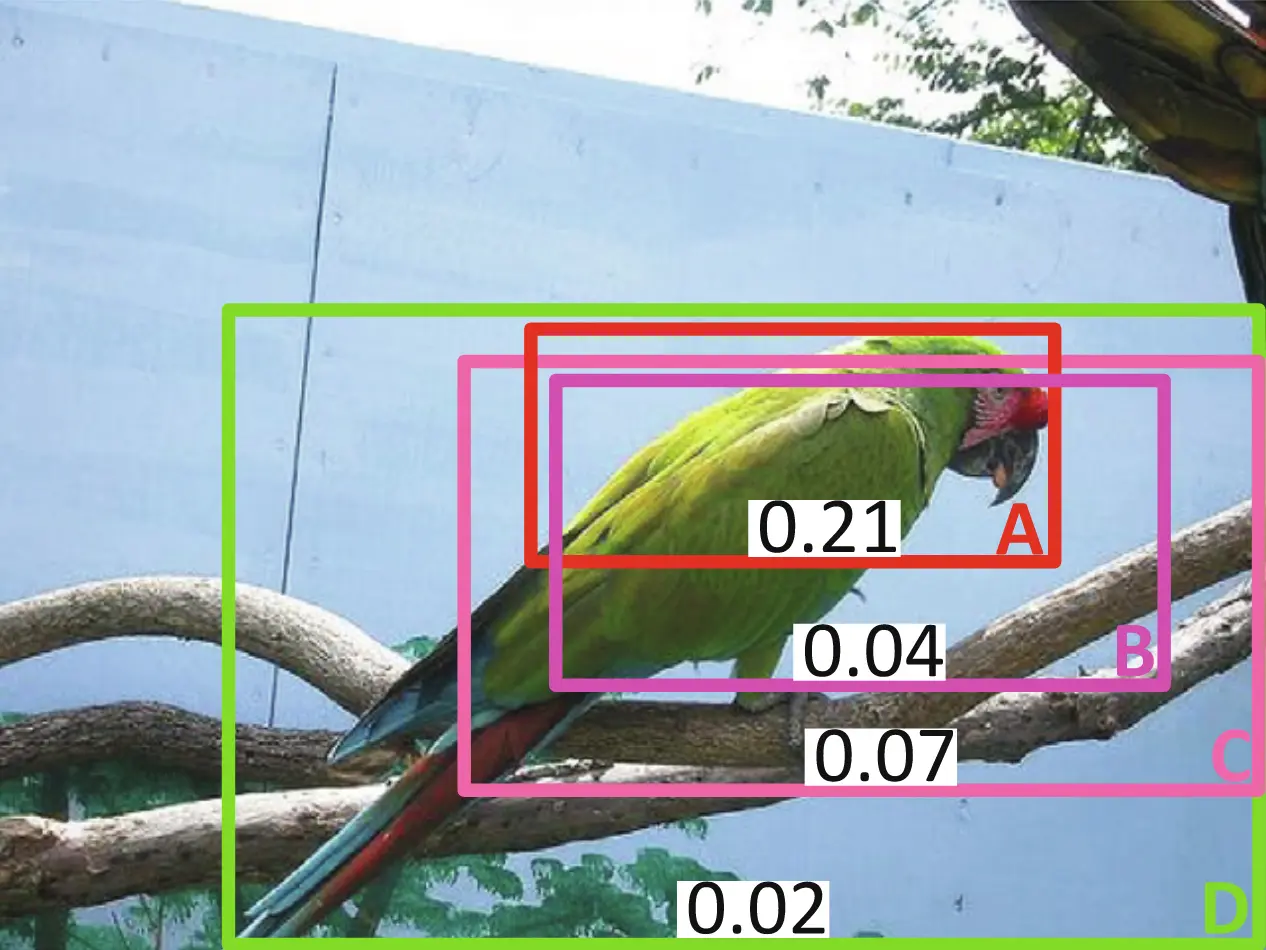
图 2:检测器容易关注局部判别区域,而非完整对象。
多实例问题
当一张图像中存在多个同类别对象时,准确检测所有实例是一项很大的挑战。检测器通常倾向于选择每个类别中得分最高的候选区域作为正候选区域,从而忽略其他可能的实例候选区域。
速度问题
WSOD 中广泛使用的候选区域生成器(Proposal Generator),如选择性搜索(Selective Search,SS)、边缘框(Edge Boxes,EB)和滑动窗口(Sliding Window,SW),通常较为耗时。
具体而言,SS 和 EB 生成 5,000 个高质量候选区域分别需要约 10 秒和 0.25 秒;典型的滑动窗口检测器需要对每张图像进行约 次分类,显著增加了计算成本。例如,典型的滑动窗口检测器 OverFeat 处理每张图像约需 2 秒。
主要框架
基于多示例学习(MIL)
多示例学习(Multiple Instance Learning,MIL)的训练集由一组具有分类标签的包(Bag)组成,每个包中包含若干没有分类标签的实例(Instance)。
如果一个包中至少包含一个正类实例(Positive Instance),该包就被标记为正包;如果包中所有实例均为负类实例(Negative Instance),该包就被标记为负包。
多示例学习的目标是通过学习带有分类标签的包,建立多示例分类器,并将其应用于未知包的预测。
更通俗地说,可以设想有若干人,每个人手中都有一个钥匙串(Bag),每串包含若干把钥匙(Instance)。我们只知道某个钥匙串能否打开一扇特定的门,却不知道串上的哪把钥匙能够开门。学习任务既要判断哪个钥匙串能开门,也要找出其中真正能开门的钥匙。
基于 MIL 的网络大多采用 WSDDN 的结构,主要由候选区域生成器、主干网络和检测头组成。
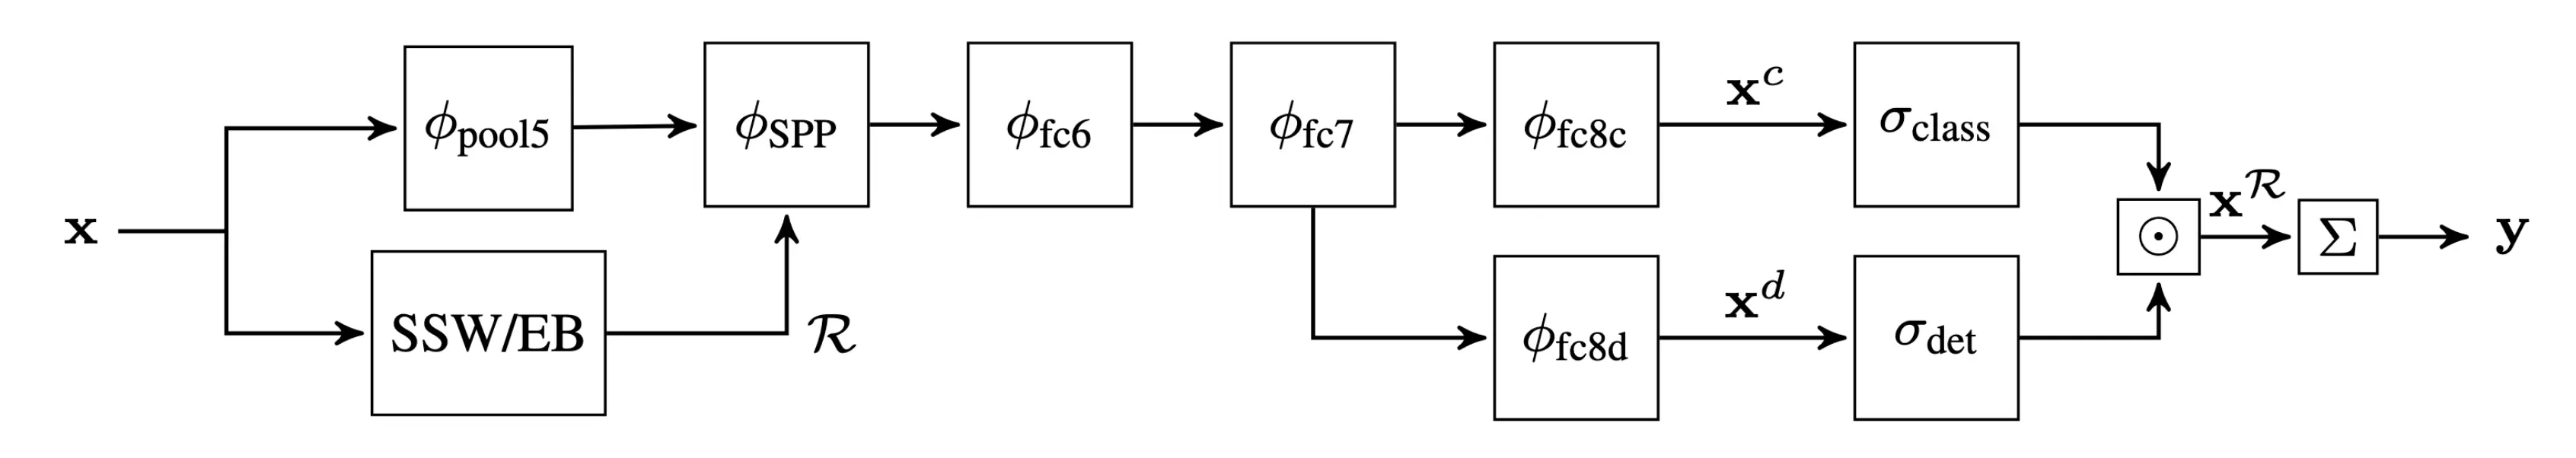
图 3:WSDDN 网络结构。
候选区域生成器(Proposal Generator)
基于 MIL 的网络通常使用以下候选区域生成方法:
- 选择性搜索(Selective Search,SS):结合穷举搜索与图像分割的优点生成初始候选区域。
- 边缘框(Edge Boxes,EB):利用对象边缘生成候选区域,在许多方法中得到广泛应用。
- 滑动窗口(Sliding Window,SW):使用多个不同比例的窗口在图像中连续滑动,每次滑动产生一个候选区域。滑动窗口的尺度过大时会产生大量无效候选区域,增加计算复杂度并降低检测速度;尺度过小时则容易遗漏形状不规则的物体。
主干网络(Backbone)
随着卷积神经网络(Convolutional Neural Network,CNN)和 ImageNet 等大规模数据集的发展,预训练的 AlexNet、VGG16、GoogLeNet、InceptionV3 和 SENet 已成为图像分类与目标检测中常用的特征提取网络。此外,DRN-WSOD 还尝试使用 ResNet 等深度残差网络,以改进对象实例定位与判别特征学习。
检测头(Detection Head)
检测头包括分类头和定位头。分类头预测每个候选区域的类别分数,定位头预测每个候选区域属于各类别的概率。随后,模型汇总两类分数并预测整张图像的置信度,以便在学习过程中引入图像级监督。
流程总结
给定一张图像后,模型首先将其输入候选区域生成器和主干网络,分别生成候选区域与特征图(Feature Map)。随后,将特征图和候选区域送入空间金字塔池化(Spatial Pyramid Pooling,SPP)层,生成固定大小的区域特征。最后,检测头根据这些区域特征对对象实例进行分类和定位。
基于类激活映射(CAM)
类激活映射(Class Activation Mapping,CAM)是一种用于可视化 CNN 关注区域的技术。借助 CAM,可以观察网络在识别图像时重点关注的区域。例如,当网络将两幅图像分别识别为“刷牙”和“砍树”时,CAM 可以显示网络据以作出判断的图像区域。
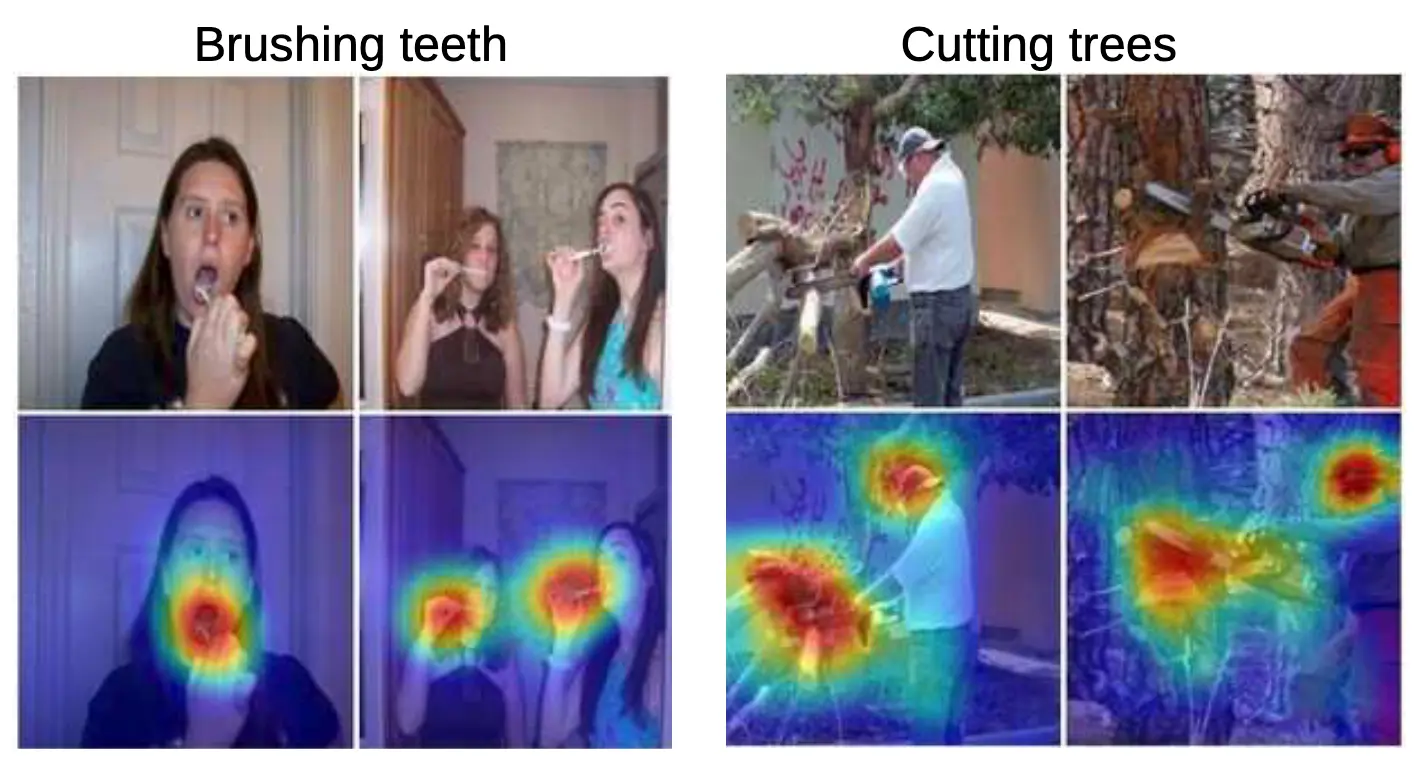
图 4:CAM 展示分类网络重点关注的图像区域。
类激活图本质上是不同空间位置上视觉模式的加权线性和。将类激活图上采样到输入图像的尺寸后,便可以识别与特定类别最相关的图像区域。
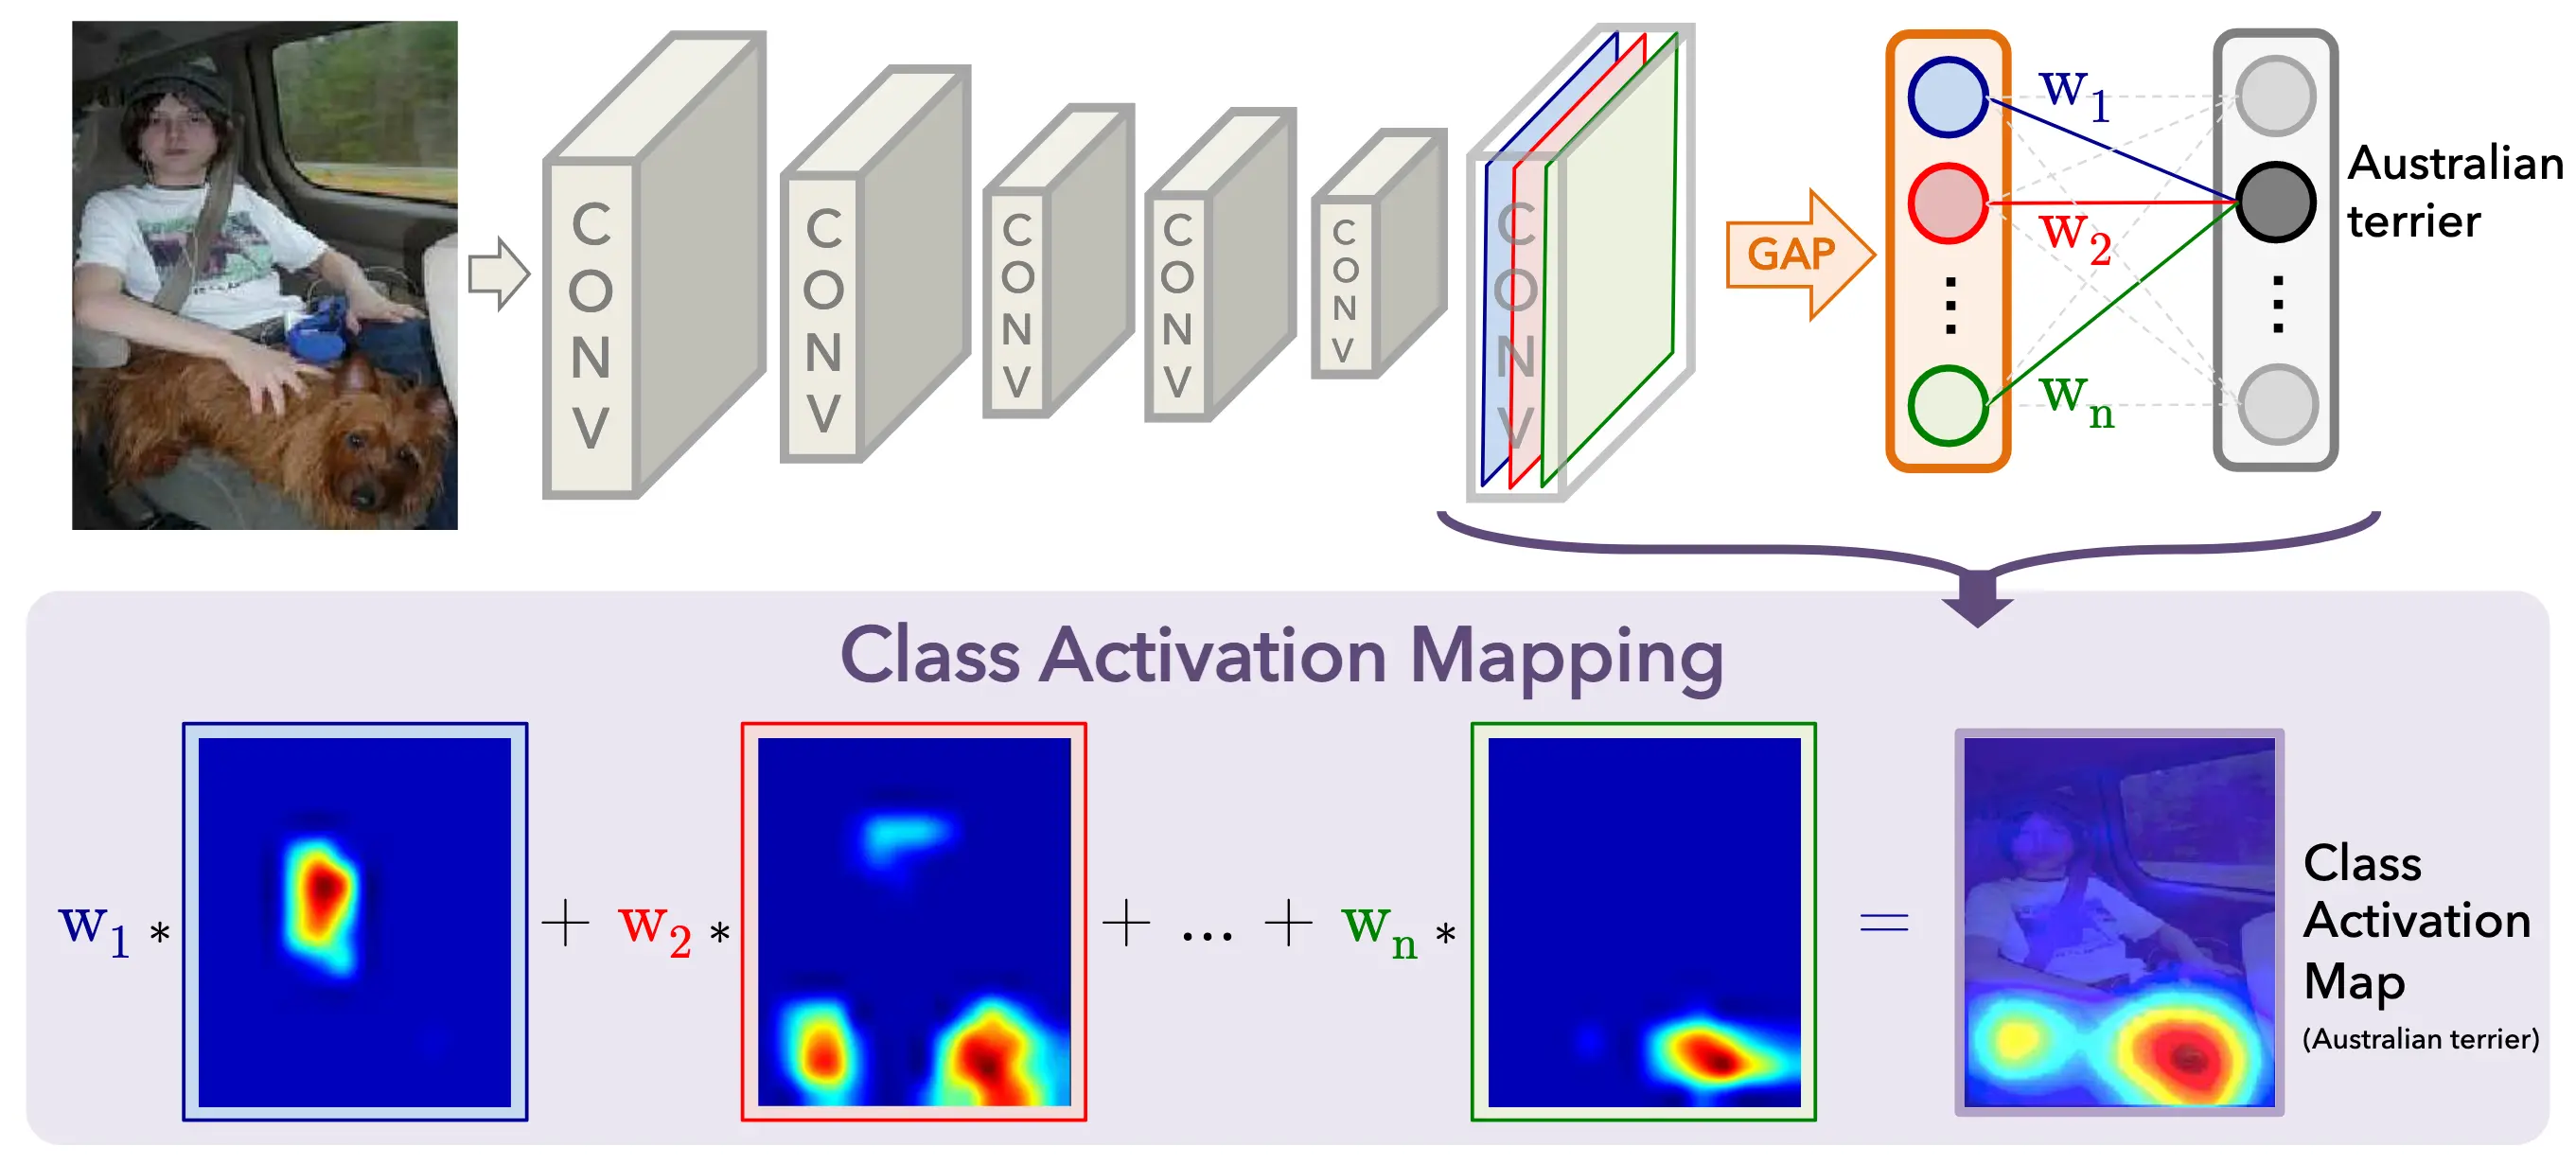
图 5:类激活映射的生成过程。
基于 CAM 的 WSOD 方法通过分割类激活图定位对象实例。其基本结构由主干网络、分类器和类激活图三个部分组成。
主干网络(Backbone)
该部分与基于 MIL 网络的主干网络类似,负责生成具有良好表征能力的特征图。此外,TS-CAM 尝试使用 Transformer 取代 CNN 主干网络,以捕捉像素之间的长距离特征依赖关系。
分类器(Classifier)
分类器负责预测图像类别,通常包含全局平均池化(Global Average Pooling,GAP)层和全连接层。
类激活图(Class Activation Maps)
类激活图负责结合简单的分割技术定位对象实例。它由全连接层的权重与最后一个卷积层的特征图通过矩阵运算生成,因此能够突出各激活图中特定类别的判别区域。对类激活图进行分割后,即可生成相应类别的边界框。
流程总结
给定一张图像后,模型首先通过主干网络生成特征图,再将特征图传递给分类器以预测图像类别。同时,模型将全连接层的权重与最后一个卷积层的特征图进行矩阵运算,生成类激活图。最后,对预测概率最高类别的激活图进行分割,得到用于对象定位的边界框。
参考文献
- Bilen, H., & Vedaldi, A. (2016). Weakly Supervised Deep Detection Networks. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2846–2854.
- Zhou, B., Khosla, A., Lapedriza, A., Oliva, A., & Torralba, A. (2016). Learning Deep Features for Discriminative Localization. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2921–2929. 论文链接
- Zhang, D., Han, J., Cheng, G., & Yang, M.-H. (2022). Deep Learning for Weakly-Supervised Object Detection and Localization: A Survey. Neurocomputing, 496, 192–207. https://doi.org/10.1016/j.neucom.2022.01.095
- MIL:多示例学习(Multiple Instance Learning)
- Multi-Instance Learning(多示例学习)综述
- 浅谈 Class Activation Mapping(CAM)